
Qué cambió en Codex 0.165.0
Las notas de la versión enumeran dos elementos de memory bajo Nuevas Funciones:
- Memory v2 es el valor predeterminado para perfiles nuevos.
- Codex puede importar memories de un agente externo a v2.
Las pull requests que las sustentan dicen más que las notas de la versión. La primera, titulada "Default fresh memory profiles to v2", da la razón: "Los perfiles sin un espacio de trabajo de memory v1 no tienen contexto heredado que preservar o consolidar antes de usar v2".
La segunda explica qué fallaba antes: "Las importaciones de memory de agentes externos anteriormente solo escribían en el espacio de trabajo v1 y solo ponían en cola la consolidación de v1, dejando al pipeline v2 sin recursos importados".
Así que, hasta este lanzamiento, una máquina que ejecutara el pipeline v2 podía importar memories de otro agente, y las memories importadas no llegarían a v2. La versión 0.165.0 cierra esa brecha y, al mismo tiempo, convierte a v2 en el punto de partida para las máquinas que no tienen memories antiguas que trasladar.
Qué se mantiene igual
Antes de entrar en versiones, conviene separar lo que la actualización no cambia.
Las memories siguen desactivadas por defecto. La documentación de Codex dice: "Las memories locales de Codex están desactivadas por defecto". Se activan en la aplicación de escritorio de ChatGPT en Settings > Personalization con Enable Codex memories, o con un feature flag en config.toml. El cambio de versión solo importa una vez que las memories están activadas.
Las memories siguen siendo locales. Los documentos dicen que "los clientes locales de Codex utilizan un almacén de memory local y controles separados" y que ChatGPT web utiliza la memory de ChatGPT en su lugar. Las notas de la versión no describen ningún vínculo entre ambos.
Los archivos siguen siendo estado generado. La guía de OpenAI no ha cambiado: "Trate estos archivos como estado generado. Puede inspeccionarlos al solucionar problemas o antes de compartir su directorio de inicio de Codex, pero no confíe en editarlos a mano como su superficie de control principal".
El control por chat sigue funcionando de la misma manera. /memories controla si el chat actual puede usar memories existentes y si puede contribuir a las futuras, y "las elecciones a nivel de chat no cambian la configuración global de memory".
Qué versión de memory utiliza tu máquina
El esquema de configuración que se incluye con Codex describe ahora el ajuste de versión en una frase: "Selecciona el pipeline de memory. Los perfiles nuevos usan v2 por defecto cuando las memories están habilitadas, a menos que la escritura dual esté explícitamente desactivada; los perfiles v1 existentes usan v1 por defecto".
La pull request ofrece la prueba exacta que aplica Codex: "Seleccionar v2 cuando las memories estén habilitadas y el directorio memories esté ausente". También enumera lo que no toca: "Preservar los ajustes explícitos de memories.version, la opción de exclusión memories.dual_write = false y el valor predeterminado v1 para espacios de trabajo existentes o errores de comprobación del sistema de archivos".
En términos sencillos, Codex mira tu directorio de inicio de Codex cuando las memories están activadas:
- Si aún no existe el directorio
memories. Codex trata el perfil como nuevo y utiliza v2. - Si ya existe un directorio
memories. Codex te mantiene en v1, por lo que las memories que ya ha construido siguen en uso. - Si tú mismo estableces una versión. Codex la respeta.
- Si Codex no puede comprobar el sistema de archivos. Recurre a v1.
Lo que lo decide es el directorio, no la fecha en que instalaste Codex. Si una instalación que tienes desde hace meses no tiene directorio memories porque nunca se habilitaron las memories, la regla de la pull request la sitúa en v2 cuando las actives.
Qué significa dual-write
El esquema describe un segundo ajuste, memories.dual_write, como: "Generar ambas versiones mientras v1 esté seleccionada; v2 se ejecuta sola tras el cambio (cutover)".
Eso describe una transición. Una máquina en v1 puede construir memories v2 en paralelo, de modo que cuando pase a v2 ya haya algo allí. Establecer memories.dual_write en false es una de las opciones que el valor predeterminado respeta, y en ese caso un perfil nuevo no pasa a v2 por defecto.
Ni memories.version ni memories.dual_write aparecen todavía en la referencia de configuración de Codex. Ambos provienen del esquema y de la pull request, así que trátalos como un comportamiento actual que aún podría cambiar.
Dónde guarda cada versión sus archivos
La ubicación documentada es el almacén v1: "Los archivos principales de memory residen bajo ~/.codex/memories/ e incluyen resúmenes, entradas duraderas, entradas recientes y evidencia de apoyo de chats anteriores".
El espacio de trabajo v2 es un directorio separado. La pull request de importación se refiere a él por su nombre: "Importar siempre los recursos seleccionados en memories_v2". Si has movido tu inicio de Codex con CODEX_HOME, ambos directorios se encuentran bajo esa ubicación en lugar de ~/.codex.
Un pequeño cambio afecta a los reinicios (resets). La pull request dice que hizo que "reiniciar un espacio de trabajo de memory ausente sea una operación nula (no-op) para que no cree un directorio v1 sin usar". Reiniciar las memories en una máquina nueva ya no deja una carpeta memories vacía que haría que Codex pensara que el perfil estaba en v1.
Dónde aterrizan las memories importadas de Claude Code
El flujo de importación de Codex trae la configuración y el trabajo reciente de otro agente a la aplicación de escritorio de ChatGPT o al CLI de Codex. La documentación de importación enumera lo que puede traer. Los archivos de instrucciones se convierten en AGENTS.md, los ajustes en config.toml, y la fila para memory dice: Project memories de Claude Code, con Memories como destino.
La pull request de importación describe lo que ocurre ahora con esas memories:
"Importar siempre los recursos seleccionados en memories_v2. Actualizar también memories cuando v1 esté seleccionada o exista un espacio de trabajo heredado".
Por lo tanto:
- En un perfil v2, las memories importadas van a
memories_v2. - En un perfil v1, van a ambos. Codex las escribe en
memoriespara el pipeline que estás usando ahora y enmemories_v2para el futuro.
Tras la importación, Codex pone en cola un pase de consolidación para cada espacio de trabajo que haya cambiado. La pull request dice que "pondrá en cola la consolidación por separado para cada espacio de nombres actualizado", y adapta las instrucciones para consolidar memories importadas al "formato de salida del pipeline activo". Las memories importadas son materia prima que Codex pliega en su propio formato de memory, no archivos copiados tal cual.
Una tercera pull request en la misma versión evita que una importación y un pase de consolidación cambien el mismo espacio de trabajo a la vez. Si un destino está en uso, Codex "devolverá un error de ocupado reintentable si un destino está bloqueado, y omitirá la consolidación cuando su espacio de trabajo esté ocupado". Si una importación informa que está ocupada, espera y ejecútala de nuevo. La propia prueba de la pull request confirma que nada queda escrito a medias cuando esto sucede.
Lo que la importación no toca
La documentación de importación dice: "La importación no cambia ni elimina la configuración de su agente existente". Tus archivos de memory de Claude Code se quedan donde están.
La importación por CLI también tiene límites que conviene conocer antes de planificar en torno a ella. "Codex CLI importa hasta 50 chats de los últimos 30 días". Y /import "no está disponible durante una tarea en ejecución, en una sesión remota o mientras se está conectado a un demonio de servidor de aplicaciones local". En la aplicación de escritorio, puedes activar las actualizaciones automáticas en Settings > Import para mantener el trabajo importado sincronizado con el agente original y revisar tu historial de importaciones allí. Para el traslado más amplio, nuestra guía para migrar de Claude Code a Codex cubre instrucciones, servidores MCP y habilidades.
Lo que la documentación aún no dice
La nota de la versión, el esquema y las pull requests describen v2. La página de memories en la documentación de Codex todavía describe un único almacén bajo ~/.codex/memories/.
Eso deja algunos puntos abiertos:
- Qué cambia v2 sobre la calidad de la memory. Las pull requests describen a dónde van los archivos v2 y cuándo los usa Codex, no en qué se diferencian sus memories en cuanto a contenido.
- Cómo se traslada una máquina v1 a v2. El esquema menciona un cambio (cutover), pero ni las notas de la versión ni los documentos describen cuándo o cómo ocurre.
- Si la aplicación de escritorio muestra la versión. Los ajustes de Personalization descritos en los documentos no la mencionan.
Hasta que la documentación se ponga al día, las carpetas en tu inicio de Codex son la señal más directa de lo que tu máquina está usando. Una pull request más en la versión añade una forma experimental para que las aplicaciones lean el resumen de memory de un chat desde "la versión de memory resuelta del hilo", sin "recurrir a otra versión". Esa es una interfaz para desarrolladores, pero confirma que las dos versiones se mantienen separadas en lugar de fusionarse.
Lo que la gente intenta primero
Asumir que la actualización activó las memories. No lo hizo. Las memories siguen desactivadas hasta que las habilites; la actualización decide qué versión obtienes cuando lo haces.
Asumir que todas las máquinas pasaron a v2. Solo los perfiles sin un directorio memories existente comienzan en v2. Una máquina con memories v1 se mantiene en v1 por defecto.
Editar archivos de memory para arreglar lo que Codex recuerda. OpenAI pide que se traten como estado generado. Con dos espacios de trabajo, una edición manual en una carpeta puede no ser lo que el pipeline activo lee.
Esperar que las memories importadas aparezcan palabra por palabra. Pasan por una consolidación en el formato propio de Codex.
Copiar un inicio de Codex a una computadora nueva y esperar la misma versión. Las carpetas que copies lo deciden. Nuestra guía para mover Codex a una computadora nueva cubre qué traer.
La solución: Comprueba tu versión, importa a propósito y mantén las reglas fuera de la memory
Paso 1: Mira tu inicio de Codex antes y después de activar las memories
Abre tu inicio de Codex, que es ~/.codex a menos que hayas configurado CODEX_HOME, y observa qué carpetas de memory existen. Una carpeta memories significa un espacio de trabajo v1. Una carpeta memories_v2 significa que existen archivos v2, ya sea porque estás en v2 o porque la escritura dual o una importación los crearon.
Si vas a habilitar las memories en una máquina que nunca las ha usado, espera v2. Si quieres mantenerte en el comportamiento v1 documentado por ahora, las reglas de la pull request significan que se respeta un ajuste explícito de memories.version, pero dado que esa clave aún no está en la referencia de configuración, consulta las notas de la versión para tu versión antes de confiar en ella.
Paso 2: Revisa lo que estás importando antes de importarlo
Claude Code mantiene su propia auto memory como markdown plano bajo ~/.claude/projects/<proyecto>/memory/, con un índice MEMORY.md. Abre la carpeta del proyecto y léelo antes de ejecutar la importación. Cualquier cosa desactualizada allí se convierte en material que Codex consolida en sus propias memories.
Luego, importa solo lo que necesites. En el CLI, ejecuta /import desde una sesión local y elige Claude Code. En la aplicación de escritorio, abre Settings > Import. Si la importación dice que un espacio de trabajo está ocupado, ejecútala de nuevo después de un momento.
Si en su lugar vas a traer contexto desde el lado de ChatGPT, nuestra guía para migrar la memory de ChatGPT a Codex explica por qué esa ruta funciona de manera diferente.
Paso 3: Mantén las reglas que deben aplicarse en AGENTS.md
La documentación de memories es directa al respecto: "Mantenga la guía de equipo requerida en AGENTS.md o en la documentación registrada. Trate las memories como una capa de recuerdo útil, no como la única fuente para las reglas que deben aplicarse siempre".
Un cambio de versión es un buen momento para comprobar ese consejo. Si una convención solo existe en las memories de Codex, o solo en la auto memory de Claude Code, escríbela en AGENTS.md o en los documentos de tu repositorio, donde cada sesión y cada versión la lean de la misma manera. Nuestra guía sobre cómo evitar que Codex omita las reglas de AGENTS.md cubre cómo Codex encuentra esos archivos.
Configurando esto en MemoryLake
Codex tiene ahora dos espacios de trabajo de memory local, y Claude Code tiene su propia carpeta de memory por proyecto. Cada una es generada por su herramienta, en una máquina, en el formato de esa herramienta. Las decisiones de las que quieres que parta cada agente necesitan un lugar que no dependa de en qué pipeline se encuentre una máquina.
MemoryLake es una capa de memory para mantener ese tipo de contexto en una lista que tú mantienes, disponible para Codex y los demás asistentes que conectes, como Claude Code y ChatGPT.
Tú mismo escribes las entradas, con tus propias palabras. No se lee nada de, ni se escribe en, ni se borra de ~/.codex/memories/, memories_v2, la auto memory de Claude Code, tu configuración importada o el almacén de cualquier proveedor. Las propias memories de Codex siguen funcionando de la forma en que OpenAI las describe.
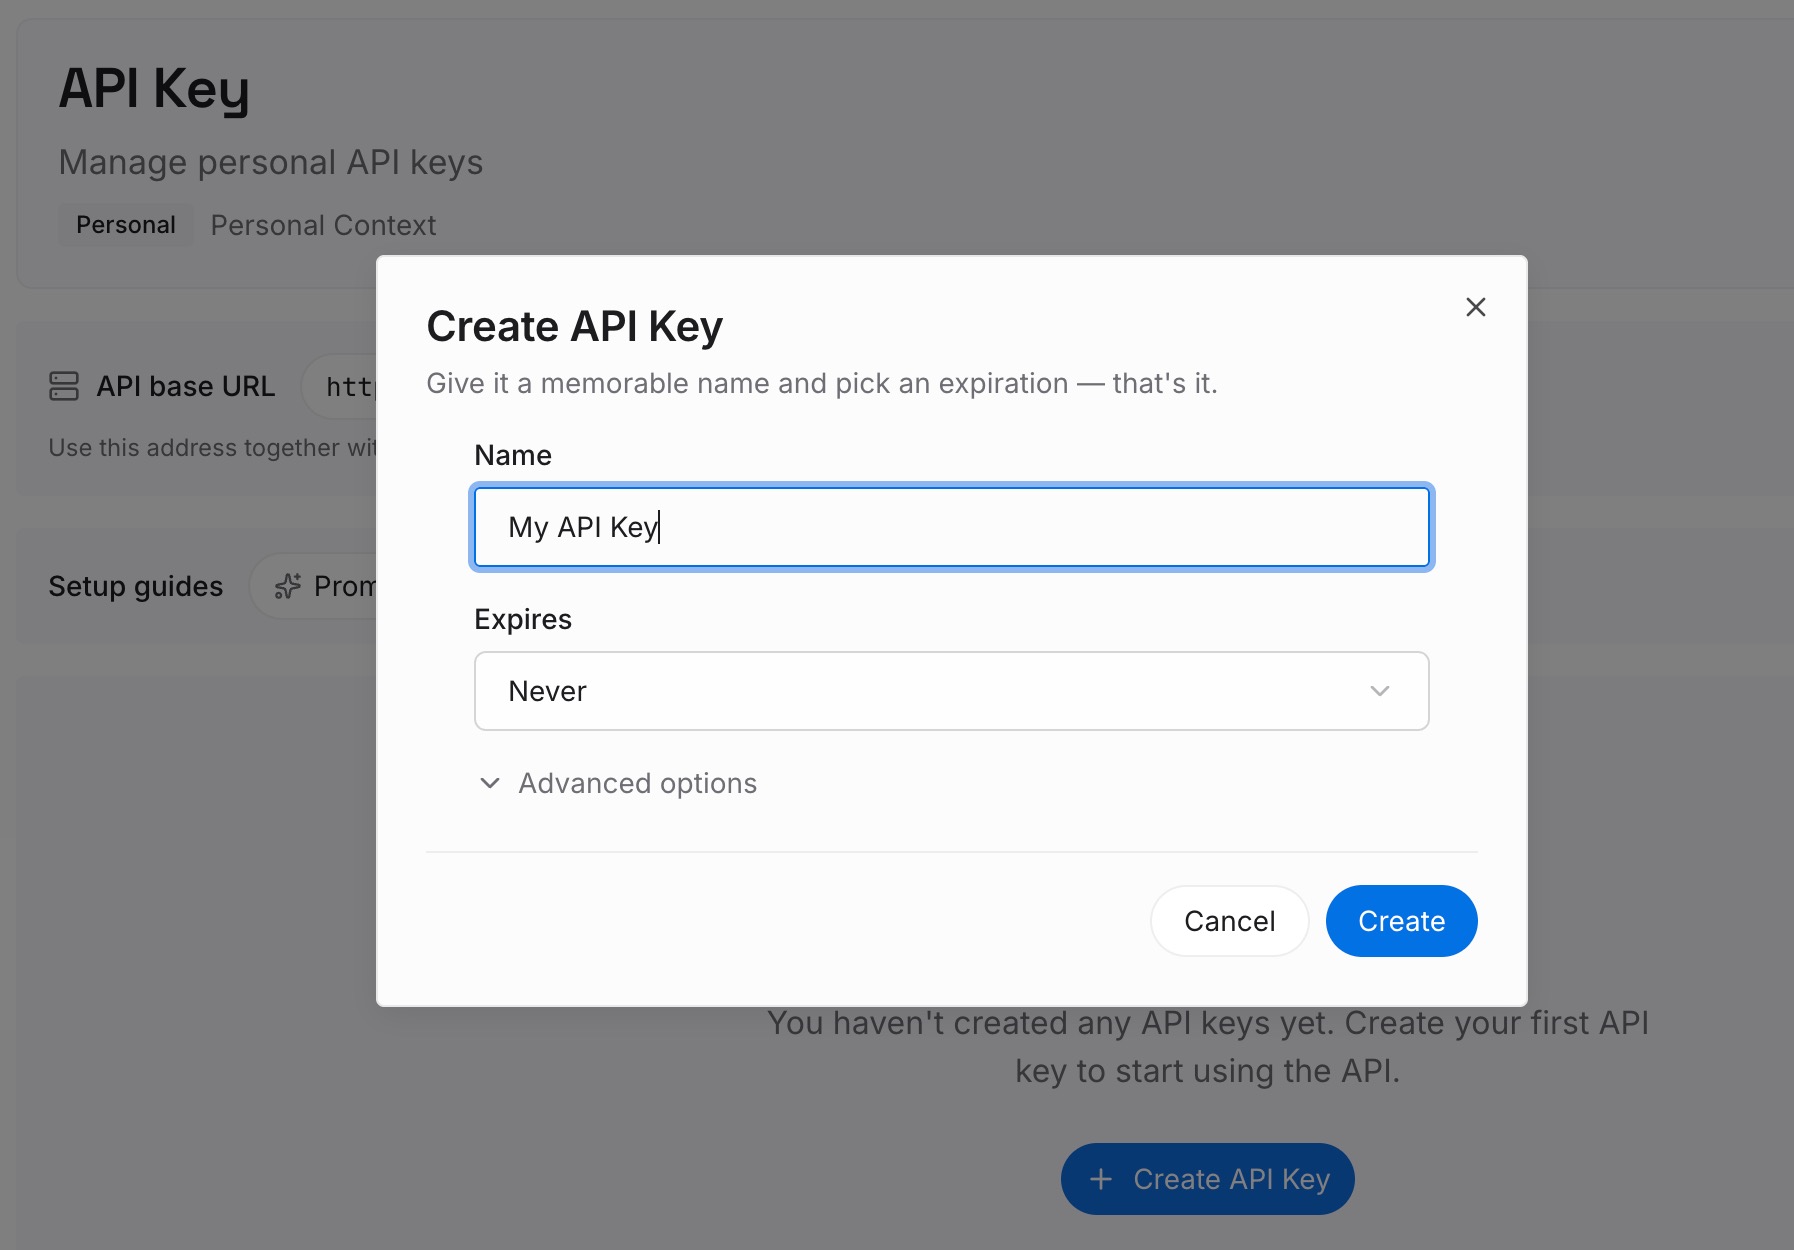
Paso 1: Crea una clave API
Inicia sesión y genera una clave desde el panel de control. La clave pertenece a tu espacio de trabajo de MemoryLake y es independiente de tu cuenta de ChatGPT y de tu configuración de Codex.
Paso 2: Sube tus primeras memories
Empieza con lo que comprobaste en el Paso 2 de la solución: las convenciones, decisiones y trampas conocidas que valía la pena conservar de la memory de Claude Code. Un punto por entrada, con fecha y etiquetado con el repositorio al que se aplica.
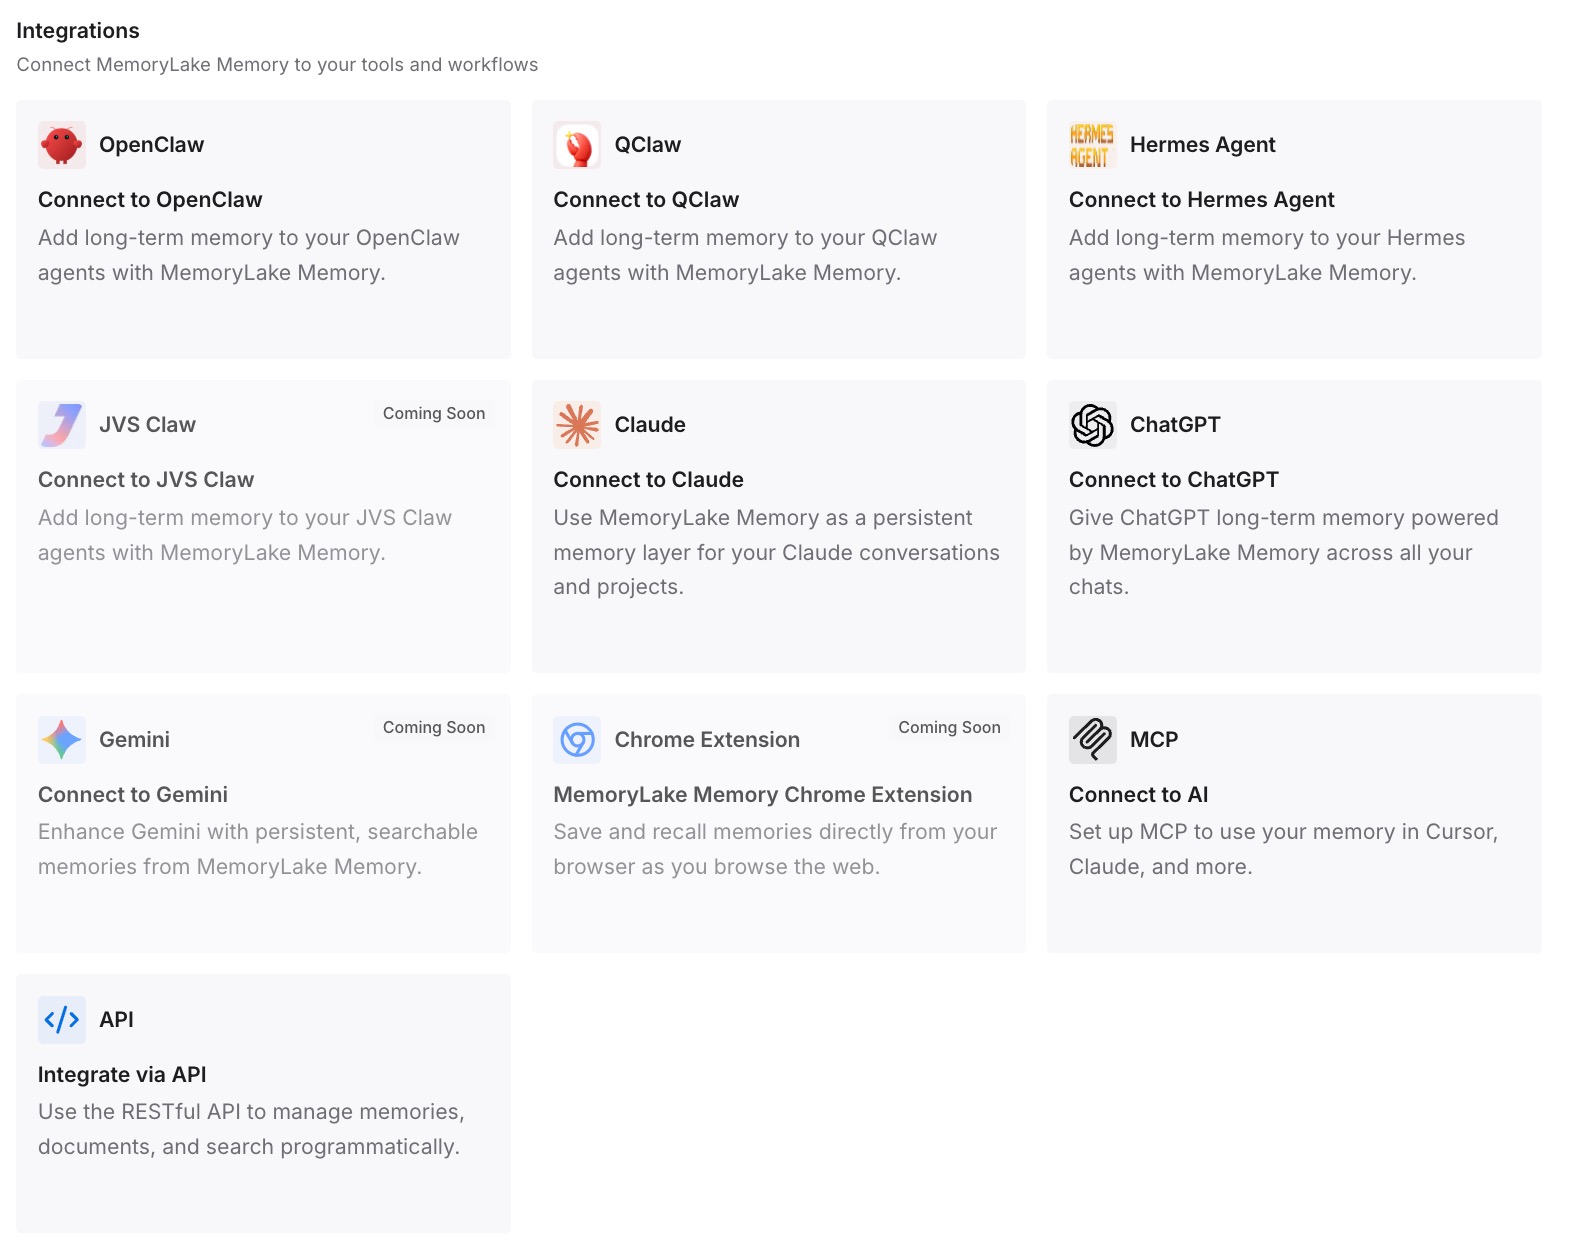
Paso 3: Conecta tu IA y agentes
Conecta Codex y los demás asistentes que utilices. El contexto en el que confías sigue siendo el mismo cuando una máquina cambia la versión de memory o tú cambias de herramienta.
Qué cambia esto en la práctica
La primera diferencia es que sabes qué almacén estás mirando. Una carpeta memories y una carpeta memories_v2 no son lo mismo, y la actualización decide entre ellas por lo que ya hay en el disco.
La segunda es que las importaciones dejan de ser un misterio. En v1 van a ambos espacios de trabajo, en v2 a uno, y en cualquier caso Codex las reescribe en su propio formato.
La tercera es que las reglas de las que dependes no se mueven con la versión. Están en AGENTS.md y en tus documentos, donde Codex las lee independientemente del pipeline de memory. Si buscas un chat en lugar de una memory, nuestra guía para encontrar el historial de chat de Codex perdido cubre dónde residen.
Mejores prácticas para Codex memories después de 0.165.0
Comprueba tu inicio de Codex en busca de memories y memories_v2. Las carpetas te dicen qué hay allí.
No asumas v2 en una máquina existente. Un espacio de trabajo v1 te mantiene en v1 por defecto.
Lee los archivos de memory de Claude Code antes de importarlos. Las notas desactualizadas se convierten en memories desactualizadas.
Vuelve a ejecutar una importación que informe de un espacio de trabajo ocupado. Está diseñada para ser reintentada.
Deja en paz los archivos generados. Usa /memories, los ajustes de Personalization o un reinicio en su lugar.
Pon las reglas requeridas en AGENTS.md. Las memories son una capa de recuerdo.
Vigila las notas de la versión. La documentación aún no describe v2, por lo que las notas de la versión son donde aparecen primero los cambios.
Conclusión
Codex 0.165.0 convierte a memory v2 en el valor predeterminado para los perfiles que aún no tienen un espacio de trabajo de memory v1, y envía las memories importadas de Claude Code a v2. Las máquinas que ya tienen memories v1 se mantienen en v1 por defecto, y las importaciones allí se escriben en ambos espacios de trabajo. Las memories siguen desactivadas por defecto, siguen siendo locales y siguen siendo archivos generados que no deberías editar a mano.
Comprueba qué carpetas contiene tu inicio de Codex, revisa la memory de Claude Code antes de importarla y mantén las reglas que deben aplicarse siempre en AGENTS.md.