
Cómo funciona la búsqueda web en Codex
Codex tiene una herramienta de búsqueda integrada. La documentación de OpenAI la describe con una advertencia adjunta: "ChatGPT incluye una herramienta de búsqueda web de origen. Trate todos los resultados web como entradas no confiables".
Puedes ver cuándo buscó Codex. La documentación dice: "Las búsquedas aparecen como elementos web_search en la transcripción interactiva y en la salida de codex exec --json". En la extensión del IDE, la actividad de búsqueda también aparece en la transcripción del chat, y la documentación señala: "La extensión utiliza el modo de búsqueda del host de Codex conectado".
La pregunta clave es de dónde provienen los resultados. Eso depende del modo de búsqueda.
Qué es la búsqueda en caché
La documentación de configuración de Codex explica el valor por defecto con más detalle: "La caché es un índice de resultados web mantenido por OpenAI, por lo que el modo en caché devuelve resultados preindexados en lugar de obtener páginas en vivo. Esto reduce la exposición a la inyección de prompts de contenido en vivo arbitrario".
Por lo tanto, en el modo en caché, Codex no está visitando la página por la que preguntaste en el momento en que preguntas. Está leyendo los resultados de un índice. Esa es la razón del ejemplo inicial. Es posible que una página publicada o actualizada muy recientemente aún no se refleje.
La compensación es deliberada. Las páginas en vivo pueden contener instrucciones escritas para manipular a un agente. Un índice reduce esa exposición, aunque la documentación tiene cuidado al decir que disminuye el riesgo en lugar de eliminarlo.
Los cuatro modos de búsqueda
La referencia de configuración de Codex enumera cuatro valores para el ajuste web_search. La documentación describe cada uno:
- Cached es el valor por defecto. Sirve resultados de la caché de búsqueda web.
- Indexed permite el acceso web externo solo cuando el índice de búsqueda filtra la solicitud.
- Live obtiene los datos más recientes de la web. La documentación dice que es lo mismo que el flag
--search. - Disabled apaga la herramienta de búsqueda web.
Hay una excepción al valor por defecto. La documentación dice: "Cuando Codex se ejecuta con acceso total, la búsqueda web por defecto es a resultados en vivo". Así que, si ejecutas Codex con acceso total, es posible que ya estés obteniendo resultados en vivo sin haber configurado nada.
Cuándo son suficientes los resultados en caché
Para gran parte del trabajo diario, el índice es suficiente:
- Buscar cómo funciona una función de una librería bien establecida.
- Encontrar páginas de documentación que no cambian a menudo.
- Investigar antecedentes para una decisión de diseño.
- Comparar enfoques sobre los que se ha escrito durante un tiempo.
En estos casos, es probable que el índice tenga lo que necesitas y mantienes la menor exposición al contenido en vivo.
Cuándo cambiar a resultados en vivo
La guía de la documentación es breve: "Usa la búsqueda en vivo cuando tu tarea dependa de la información más reciente".
Eso cubre tareas como estas:
- Revisar un lanzamiento publicado hoy.
- Leer el estado actual de una página de estado o un informe de incidente.
- Consultar un registro de cambios que se actualiza a menudo.
- Verificar que una corrección o una depreciación se haya implementado.
Para una sola ejecución, la CLI tiene un flag. La documentación dice: "En la CLI, pasa --search para obtener resultados en vivo para una ejecución". Esto deja tu configuración por defecto sin cambios.
Para un cambio duradero, establece el modo en tu archivo de configuración. La documentación dice que se debe establecer el valor de web_search a live en config.toml, o a disabled para desactivar la herramienta.
Cómo cambiar el modo
El ajuste se coloca en un archivo de configuración de Codex. La documentación de configuración de Codex enumera el orden en que se resuelven los valores, de mayor a menor precedencia:
- Flags de la CLI y anulaciones de
--config. - Archivos de configuración del proyecto en
.codex/config.toml, primero los más cercanos a tu directorio de trabajo, solo para proyectos confiables. - Archivos de perfil seleccionados con
--profile. - Tu configuración de usuario en
~/.codex/config.toml. - Valores por defecto gestionados en la nube, cuando se entregan para tu espacio de trabajo.
- Configuración del sistema, si está presente.
- Valores por defecto integrados.
Por lo tanto, un proyecto puede establecer su propio modo de búsqueda, un perfil puede cambiarlo para un tipo de trabajo y un solo comando puede anular ambos. Si un proyecto se marca como no confiable, la documentación dice que Codex omite las capas .codex/ de ámbito de proyecto, incluida la configuración local del proyecto.
Si has usado Codex durante un tiempo, busca configuraciones antiguas. La referencia de configuración enumera interruptores heredados bajo [features], como web_search_cached y web_search_request, como obsoletos. Cuando el ajuste de nivel superior web_search no está establecido, estos todavía se mapean a cached o live. Establecer web_search directamente aclara el modo.
Qué reglas de red no sigue la búsqueda web
Este es el detalle del título, y es importante si has configurado restricciones de red para Codex.
La documentación dice: "La búsqueda web es una herramienta alojada, separada de la red de comandos locales en sandbox. No utiliza el proxy de red del perfil de permisos ni la lista de dominios permitidos, y puede permanecer disponible cuando el acceso a la red de comandos está desactivado".
Así que hay dos sistemas separados:
- Red de comandos. Las reglas del sandbox que deciden si los comandos que ejecuta Codex, como la instalación de un paquete o un
curl, pueden llegar a la red, a través de qué proxy y a qué dominios. - Búsqueda web. Una herramienta alojada con sus propios ajustes.
Desactivar el acceso a la red para los comandos no desactiva la búsqueda web. Una lista de dominios permitidos para comandos no limita qué sitios puede devolver la búsqueda.
La búsqueda web tiene su propio filtro de dominios. La referencia de configuración describe una forma de objeto de tools.web_search que "puede establecer el tamaño del contexto de búsqueda, los dominios de búsqueda permitidos y la ubicación aproximada del usuario". Añade que estos filtros "son independientes de las reglas de dominio de red de comandos en sandbox y no restringen los conectores ni los servidores MCP".
La página de búsqueda web dice lo mismo desde el otro lado: "Los filtros de dominio de búsqueda no restringen el tráfico de comandos locales, aplicaciones, conectores o servidores MCP".
Si quieres limitar ambos, necesitas ambos ajustes. Cubrimos cómo Codex decide qué comandos pueden ejecutarse fuera del sandbox en nuestra guía sobre las reglas de Codex.
Cómo pueden los administradores limitar los modos de búsqueda
Para entornos gestionados, la documentación de OpenAI menciona un requisito llamado allowed_web_search_modes. La referencia de configuración lo describe como los valores permitidos para web_search, y añade: "disabled siempre está permitido; una lista vacía permite efectivamente solo disabled".
Así, una organización puede, por ejemplo, permitir cached y disabled pero no live. La documentación sugiere combinar la política de red de comandos con controles como allowed_web_search_modes, servidores MCP aprobados y requisitos de funciones para aplicaciones, complementos, navegadores o Computer Use.
En ChatGPT en la web, la documentación señala: "Los ajustes del espacio de trabajo pueden limitar si la búsqueda está disponible".
Cómo interactúa la búsqueda web con las memorias de Codex
Codex puede convertir el contexto útil de chats anteriores en memorias locales. Su referencia de configuración incluye un ajuste que conecta las memorias y la búsqueda.
La documentación de memorias describe memories.disable_on_external_context de esta manera: "cuando es true, mantiene los chats que usaron contexto externo, como llamadas a herramientas MCP, búsqueda web o búsqueda de herramientas, fuera de la generación de memoria". La referencia de configuración dice que el valor por defecto es false.
Por lo tanto, por defecto, un chat que usó la búsqueda web aún puede contribuir a la generación de memoria, al igual que cualquier otro chat elegible. Si prefieres evitar que los chats que extrajeron contenido externo den forma a lo que Codex recuerda, establece esa opción en true. La documentación señala que un nombre de clave antiguo, memories.no_memories_if_mcp_or_web_search, todavía se acepta como un alias.
Esto importa más cuando los resultados de búsqueda son entradas no confiables. Un chat que leyó páginas web es un chat cuyo contenido provino en parte de fuera de tu proyecto.
Una nota sobre la inyección de prompts
La documentación de configuración termina su sección sobre búsqueda con una advertencia: "Tenga precaución al habilitar el acceso a la red o la búsqueda web en Codex. La inyección de prompts puede hacer que el agente obtenga y siga instrucciones no confiables".
El modo en caché es el predeterminado porque reduce esa exposición. El modo en vivo está ahí cuando la frescura de la información importa más. Ninguno de los dos hace que el contenido web sea confiable, así que revisa lo que Codex hace con los resultados, especialmente antes de que ejecute comandos basados en ellos.
Lo que la gente intenta primero
Esperar que los resultados de búsqueda reflejen los cambios de hoy. Los chats locales usan un índice en caché por defecto.
Desactivar el acceso a la red de comandos para detener las búsquedas. La búsqueda web es independiente y puede permanecer disponible.
Usar una lista de dominios permitidos de comandos para limitar la búsqueda. La búsqueda tiene su propio filtro de dominios en tools.web_search.
Dejar interruptores de funciones antiguos en su lugar. Establece el valor de web_search de nivel superior en su lugar.
Asumir que la búsqueda nunca afecta a la memoria. Por defecto, los chats que usaron la búsqueda web pueden alimentar la generación de memoria.
La solución: Elige el modo de búsqueda por tarea
Paso 1: Mantén la caché como tu valor por defecto
Usa el índice para investigación de antecedentes y documentación estable.
Paso 2: Usa en vivo para comprobaciones urgentes
Pasa --search para una sola ejecución, o establece live en un perfil que uses para ese tipo de trabajo.
Paso 3: Establece los límites de búsqueda por separado de los límites de red
Usa tools.web_search para los dominios de búsqueda y los ajustes del sandbox para el tráfico de comandos.
Paso 4: Registra lo que verificaste
Cuando una búsqueda en vivo confirme una versión, una corrección o una depreciación, anota el resultado y la fecha.
Configurando esto en MemoryLake
La búsqueda web responde a una pregunta en un momento dado. Lo que aprendes de ella, como qué versión introdujo una corrección, qué API fue depreciada o en qué fuente confía tu equipo para una dependencia, es contexto del proyecto que es útil mucho después de la búsqueda.
MemoryLake es una capa de memoria para ese tipo de contexto de proyecto, como hechos verificados, decisiones y las fuentes detrás de ellos, mantenidos en un solo lugar que tú controlas y disponibles para los asistentes que conectes, como ChatGPT, Claude Code y Codex.
Tú mismo escribes las entradas, con tus propias palabras. No se lee nada, ni se escribe ni se borra de tus chats de Codex, tus resultados de búsqueda, tu config.toml, tus memorias de Codex o el almacén de cualquier proveedor. La búsqueda web de Codex funciona de la manera que describe OpenAI.
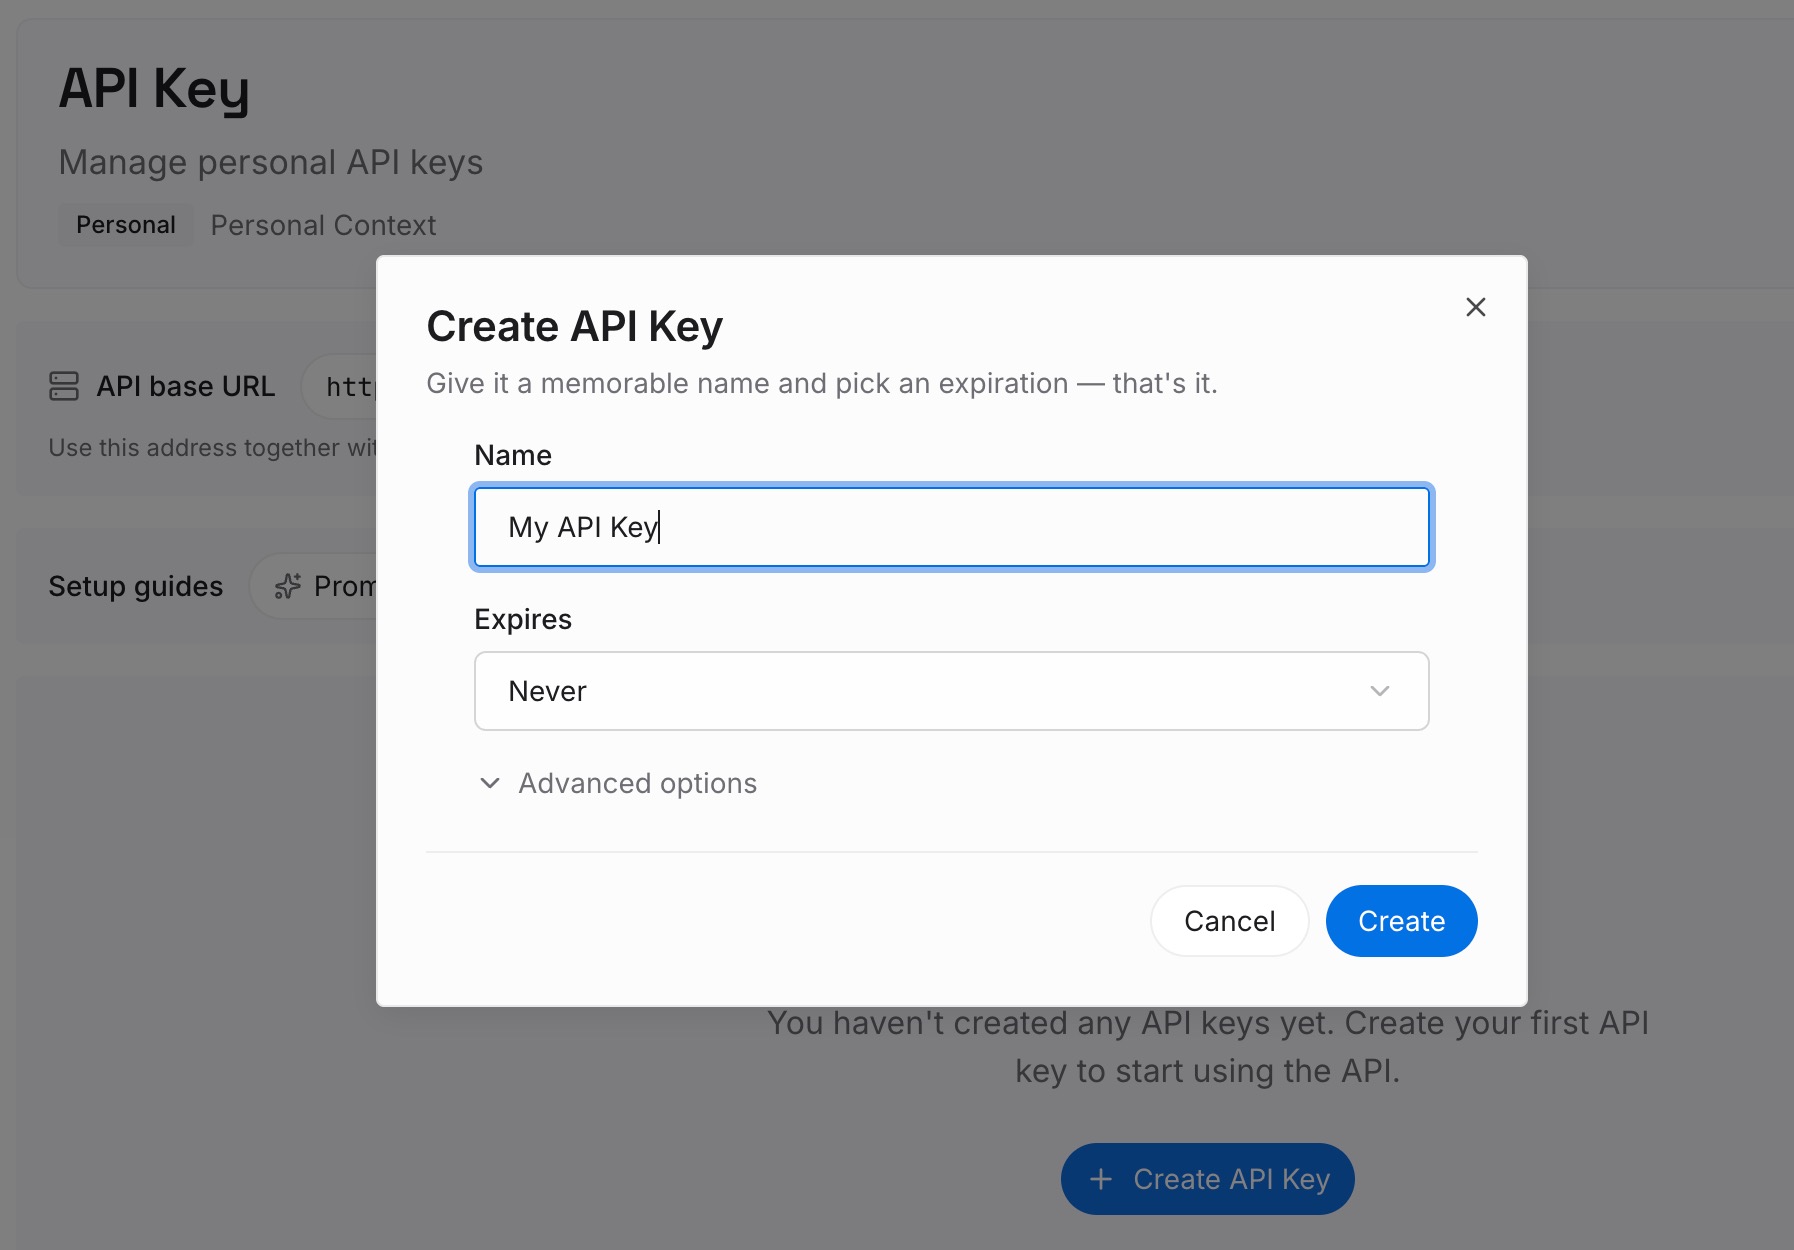
Paso 1: Crea una clave de API
Inicia sesión y genera una clave desde el panel de control. Guárdala fuera de tus repositorios, como cualquier otra credencial.
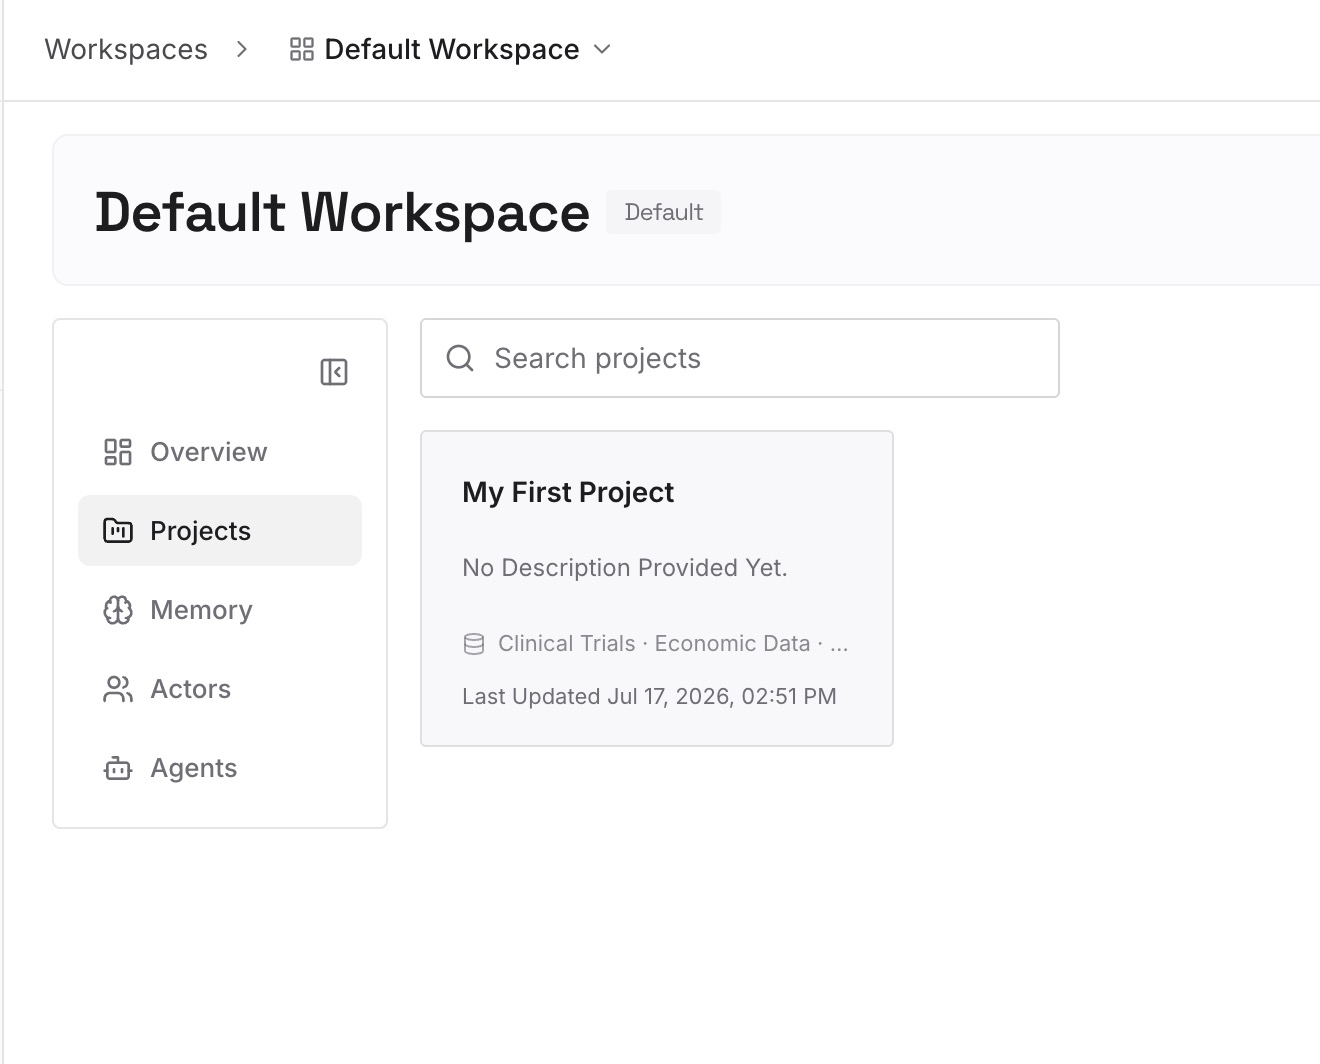
Paso 2: Sube tus primeras memorias
Comienza con lo que escribiste en el Paso 4 de la solución: los hechos que verificaste y cuándo. Un hecho por entrada, con la fuente.
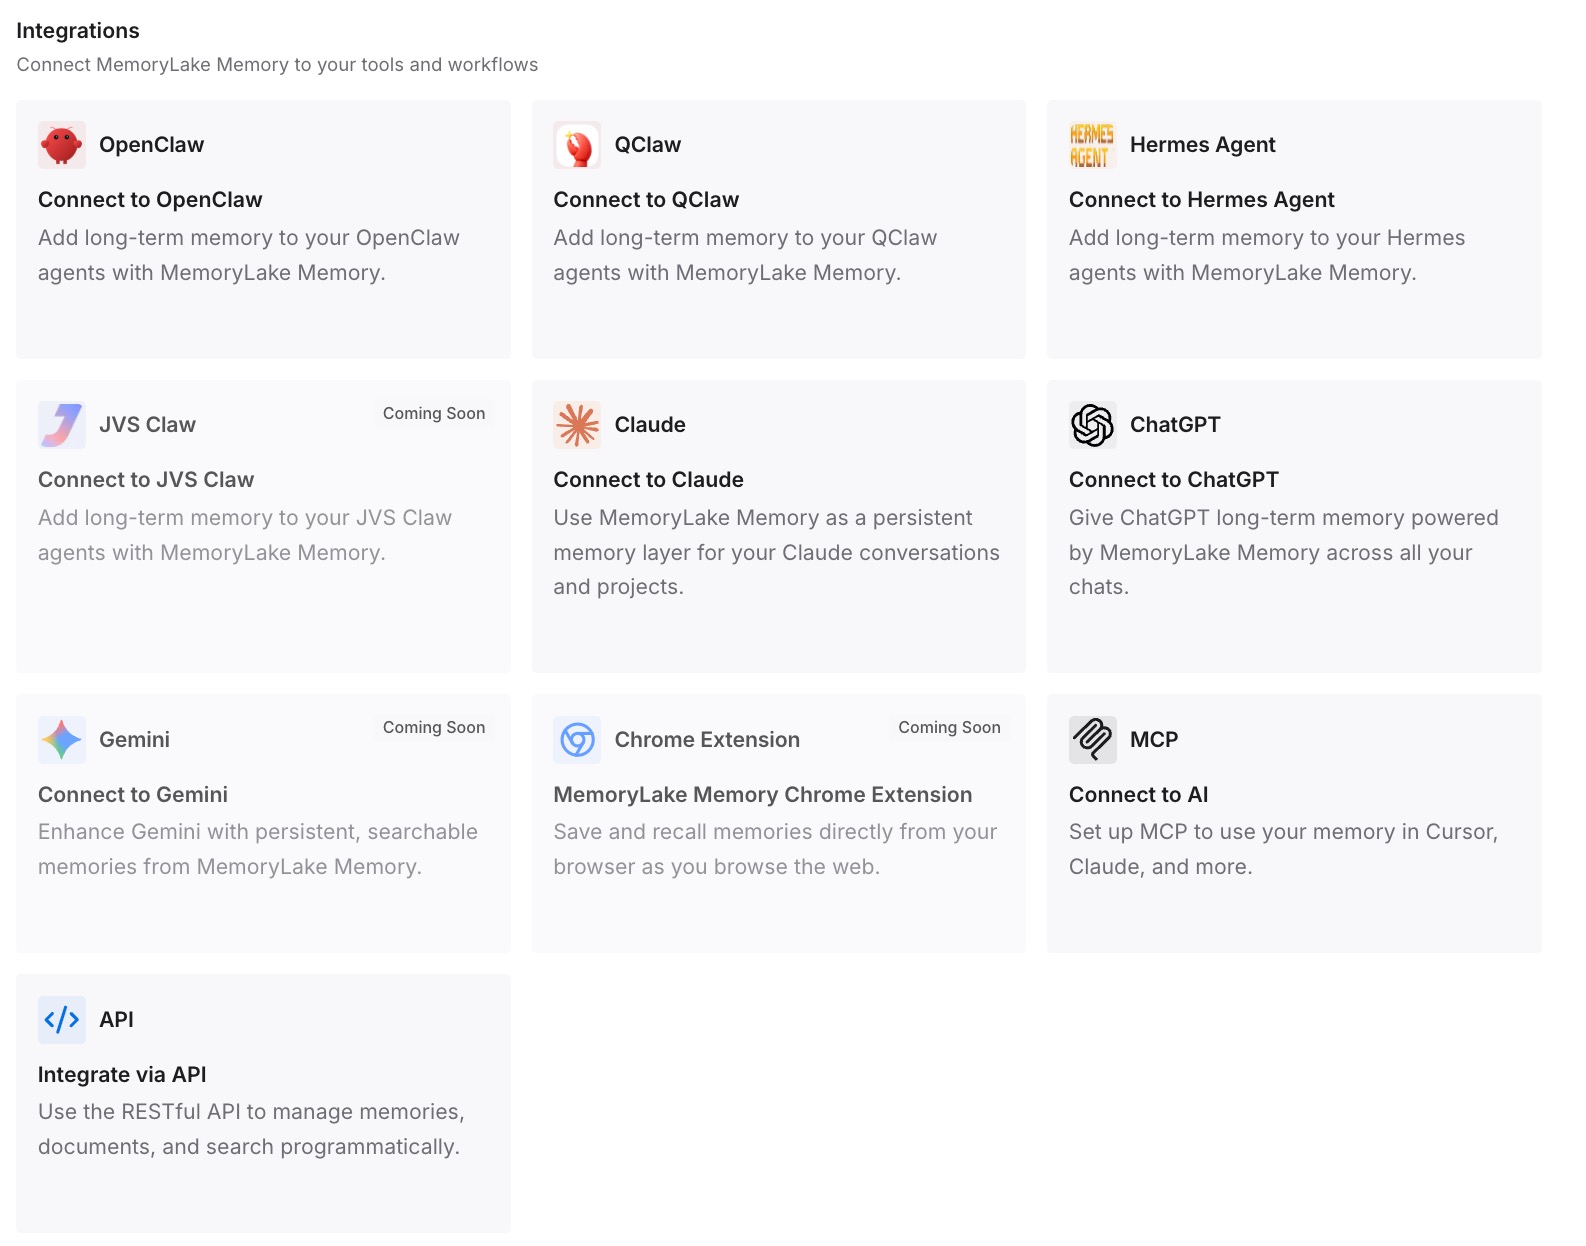
Paso 3: Conecta tu IA y agentes
Conecta Codex, Claude Code y los otros asistentes que utilices. Cada uno puede recurrir a los mismos hechos verificados sin tener que buscar de nuevo.
Qué cambia esto en la práctica
La primera diferencia es que hay menos búsquedas repetidas. Un hecho que verificaste una vez está disponible la próxima vez.
La segunda es una procedencia más clara. Cada entrada indica de dónde vino un hecho y cuándo.
La tercera es la consistencia entre herramientas. Los mismos hechos verificados están allí en Codex y en otros asistentes.
Mejores prácticas para la búsqueda web de Codex
Mantén la caché como el valor por defecto. Reduce la exposición al contenido en vivo.
Usa --search para frescura puntual. No cambia tu configuración por defecto.
Usa perfiles para trabajo en vivo repetido. Establece el modo donde corresponda.
Limita los dominios de búsqueda por separado. Las reglas de red de comandos no se aplican a la búsqueda.
Busca interruptores heredados. Prefiere el ajuste web_search de nivel superior.
Decide sobre la generación de memoria. Usa memories.disable_on_external_context si quieres que los chats buscados queden fuera.
Trata los resultados como no confiables. Revísalos antes de actuar sobre ellos.
Conclusión
La búsqueda web de Codex utiliza un índice en caché mantenido por OpenAI por defecto en los chats locales. Eso reduce la exposición a la inyección de prompts, pero significa que las páginas muy recientes pueden no verse reflejadas. El modo en vivo, configurado con web_search en config.toml o el flag --search para una ejecución, obtiene los datos más recientes, y las sesiones de acceso total tienen por defecto el modo en vivo.
La búsqueda web es una herramienta alojada, independiente de la red de comandos del sandbox, por lo que no utiliza tu proxy de red ni tu lista de dominios permitidos de comandos, y puede seguir disponible cuando el acceso a la red de comandos está desactivado. Tiene su propio filtro de dominios, los administradores pueden limitar los modos permitidos y, por defecto, un chat que usó la búsqueda aún puede alimentar la generación de memoria a menos que establezcas memories.disable_on_external_context en true.