
Lo que OpenAI lanzó el 17 de noviembre
El registro de cambios de ChatGPT y Codex de OpenAI con fecha del 17 de noviembre de 2026 enumera a GPT-6.2 Astra y GPT-6.2 Sol como disponibles en ChatGPT Work y Codex. La documentación los describe como un par con tareas diferentes.
- GPT-6.2 Astra. La documentación dice que "Astra es la opción más sólida para el razonamiento complejo". Sus tareas de ejemplo son diagnosticar un error en varios servicios, crear una presentación a partir de un informe y una plantilla de diapositivas, y comparar fuentes de investigación para encontrar dónde no coinciden las evidencias.
- GPT-6.2 Sol. OpenAI describe a Sol como el modelo para la programación diaria, la escritura y el trabajo que requiere varios pasos. Sobre el costo de uso, la misma página dice: "En comparación con GPT-6.1 Sol, te permite completar más tareas con el mismo plan de pago".
La sección de Codex del anuncio convierte eso en consejos de programación. Elige Astra "para rastrear un error en varios servicios, corregirlo y probar los flujos de trabajo afectados". Elige Sol "para revisar una solicitud de extracción (pull request) o revisar código en respuesta a comentarios".
La parte que cambia tu trabajo diario en Codex es menos visible: los dos modelos no comienzan con la misma cantidad de espacio.
Dónde puedes usar GPT-6.2
Las reglas de disponibilidad explican la segunda mitad del ejemplo inicial.
ChatGPT Work. El anuncio dice que puedes usar Astra o Sol en Work "en la web, escritorio o móvil con Plus, Pro, Business, Enterprise o Edu". Hay un paso adicional para algunas organizaciones: "Los administradores de Enterprise y Edu deben habilitar primero los modelos en la configuración del espacio de trabajo".
Codex. Ambos modelos están disponibles en la aplicación Codex y en la CLI. Los eliges con el selector de modelos en la aplicación o con /model en la CLI.
Chat. Este es el punto clave. La sección Chat del anuncio lo dice en una línea: "Para usar GPT-6.2 Astra o Sol en ChatGPT, abre Work". Para los modelos que puedes seleccionar en Chat, OpenAI remite a un artículo de ayuda separado sobre modelos en ChatGPT, y ese artículo no incluye a GPT-6.2.
La API. Los desarrolladores pueden llamar a gpt-6.2-astra o gpt-6.2-sol en la Responses API.
Un detalle más importa si usas tanto Work como Codex: "Codex y Work comparten el uso". Una sesión larga de Astra en Codex y una tarea larga en Work consumen el mismo cupo.
Work en sí es un modo de ChatGPT, no una aplicación separada. Cubrimos cómo se diferencia de Chat y qué memoria, proyectos e historial comparte en nuestra guía sobre el modo ChatGPT Work.
Con qué te inicia Work
Si cambias a Work en ChatGPT sin tocar el selector de modelos, no obtienes Astra. El anuncio dice: "En los planes de consumo compatibles, los nuevos chats de Work se inician por defecto en Sol con un esfuerzo de razonamiento Light". Para las organizaciones, "los espacios de trabajo Enterprise con acceso a modelos se inician por defecto en Sol en Medium".
Por lo tanto, en Work, Sol es el predeterminado y Astra es una elección deliberada. Si tu pantalla muestra un control deslizante de Power, la documentación dice que abras Advanced para elegir un modelo y el esfuerzo de razonamiento.
Cuánto contexto inicia cada modelo en Codex
Este es el detalle que explica por qué la sesión fue más corta.
La referencia del modelo de Codex enumera un valor llamado contexto predeterminado en Codex para cada modelo:
- GPT-6.2 Astra: 272,000 tokens.
- GPT-6.2 Sol: 500,000 tokens.
Para comparar, la misma página dice que "GPT-6.1 Sol utiliza una ventana de contexto predeterminada de 500,000 tokens en Codex y ChatGPT Work". Así que, si pasaste de GPT-6.1 Sol a GPT-6.2 Sol, tu espacio inicial no cambió. Si pasaste de GPT-6.1 Sol a GPT-6.2 Astra, comenzaste con poco más de la mitad.
Esa brecha no es un límite del modelo. La referencia añade: "GPT-6.2 Astra y GPT-6.2 Sol admiten cada uno una ventana de contexto de hasta 1 millón de tokens". La cifra de 272,000 es el valor predeterminado que usa Codex a menos que le indiques lo contrario.
En la práctica, una ventana más pequeña puede significar que un hilo largo llegue a la compactación antes. La referencia de configuración de Codex describe el ajuste relacionado, model_auto_compact_token_limit, como el "Umbral de tokens que activa la compactación automática del historial (si no se establece, usa los valores predeterminados del modelo)". Cuando no lo has configurado, el umbral sigue al modelo que estás usando.
Por qué una línea de configuración anula ambos
La referencia del modelo de Codex te indica cómo obtener más espacio: "Para usar una ventana de contexto más larga en Codex, establece model_context_window en config.toml".
Aquí está la parte que es fácil pasar por alto. La referencia de configuración describe model_context_window como "Tokens de la ventana de contexto disponibles para el modelo activo". Es un valor único para cualquier modelo que esté activo. No hay una entrada separada para Astra y otra para Sol.
Esto tiene tres consecuencias:
- Si lo configuras una vez, se aplica a ambos. Si lo aumentas para Astra, Sol obtiene el mismo número cuando vuelvas a cambiar.
- Si lo configuraste para un modelo antiguo, sigue aplicándose. Un valor que añadiste hace meses para un modelo diferente sigue anulando los nuevos valores predeterminados, independientemente del modelo GPT-6.2 que elijas.
- Si nunca lo configuras, cada modelo obtiene su propio valor predeterminado. El archivo de configuración de muestra señala que el valor predeterminado es automático para el modelo, razón por la cual Astra y Sol comienzan con tamaños diferentes.
La misma lógica se aplica al umbral de compactación. Si model_auto_compact_token_limit está configurado en tu archivo, no sigue al modelo. Si no lo está, utiliza el valor predeterminado del modelo.
Antes de confiar en cualquiera de los modelos para una sesión larga, abre tu config.toml y verifica si alguna de las líneas está allí. Si encuentras una, decide si todavía la quieres para ambos modelos. Si no, elimínala y deja que cada modelo use su propio valor predeterminado.
Esto importaba menos cuando los modelos entre los que alternabas tenían el mismo valor predeterminado. Con GPT-6.2, los dos modelos entre los que es más probable que cambies comienzan con tamaños diferentes, por lo que un valor que establezcas para uno decide el espacio para ambos.
Qué cambia /model en un hilo en ejecución
Codex te permite cambiar de modelo sin empezar de cero. La referencia del modelo dice: "Puedes cambiar de modelo a medida que tu trabajo cambie".
En la CLI, la referencia de comandos de barra describe los pasos. Escribe /model, elige un modelo y luego: "Esperado: Codex confirma el nuevo modelo en la transcripción. Ejecuta /status para verificar el cambio".
También describe una forma más corta: "Para cambiar la configuración de la sesión actual directamente, usa /model [modelo] [--reasoning=<nivel>] [--speed=<nivel>]". Por ejemplo, /model --reasoning=high mantiene el modelo actual y solo aumenta su esfuerzo de razonamiento.
Lo que la documentación no describe es qué sucede con un hilo que ya ha superado la ventana predeterminada del nuevo modelo. Si has acumulado 400,000 tokens de contexto en GPT-6.2 Sol y luego cambias a Astra sin tener configurado model_context_window, los documentos no dicen si Codex compacta de inmediato, en el siguiente turno o en algún otro momento. La lectura segura es asumir que un cambio a un modelo con una ventana más pequeña puede adelantar la compactación, y cambiar en un descanso natural en lugar de en medio de una investigación larga.
Hay dos formas sencillas de evitar la duda:
- Inicia el trabajo largo de Astra en un hilo nuevo. Dale un resumen breve en lugar de arrastrar un historial largo de Sol a una ventana más pequeña.
- Establece la ventana deliberadamente. Si quieres que Astra tenga tanto espacio como Sol, establece
model_context_windowy acepta que se aplica a ambos.
Para iniciar Codex en un modelo específico desde la línea de comandos, la referencia muestra codex --model gpt-6.2-sol. El mismo indicador -m funciona con codex exec para ejecuciones no interactivas.
Qué añade la documentación de la API sobre mantener el contexto
Los desarrolladores que utilizan la Responses API reciben una nota relacionada en el mismo anuncio. En el modo estándar de agente único, puedes cambiar el esfuerzo de razonamiento o el formato de salida entre respuestas añadiendo un elemento configuration_update antes del siguiente mensaje del usuario.
La documentación explica por qué ese enfoque es importante: "Mantener intacta la entrada anterior ayuda a preservar el razonamiento a través de los turnos y mantiene esa entrada elegible para el almacenamiento en caché de prompts (prompt caching)".
El principio se traslada también al uso de Codex. Cuanto más estable mantengas un hilo, más útil seguirá siendo. Los cambios de configuración en medio de un trabajo largo son más económicos cuando no alteran lo que vino antes.
Qué dice la guía de prompts de Codex sobre AGENTS.md
OpenAI publicó una guía de prompts para la familia GPT-6.2 en Codex el mismo día. La mayor parte trata sobre el esfuerzo de razonamiento, subagentes y trabajo visual, pero una sección trata sobre el contexto del proyecto.
Su encabezado es directo: mantén tu AGENTS.md ligero. La guía dice: "Usa AGENTS.md para los requisitos y convenciones del proyecto que Codex no pueda inferir del código, las pruebas o los documentos". Sobre el trabajo repetido, añade: "Si el mismo tipo de trabajo surge regularmente, pon esa instrucción en la habilidad relevante o en AGENTS.md e indica cuándo se aplica".
Ese consejo se conecta con la cuestión de la ventana de contexto. Un AGENTS.md ligero se carga en cada hilo, en cada modelo, y cuesta los mismos tokens ya sea que tengas 272,000 o 500,000 para trabajar. Una ventana más pequeña simplemente deja menos espacio después de él.
Cómo elegir entre Astra y Sol en Codex
La página de selección de modelos de OpenAI ofrece la regla general: "Comienza con una tarea que conozcas bien y compara el resultado con lo que necesitas". Sugiere considerar cuánto tiempo estás dispuesto a esperar, cuánto uso requiere la tarea y cuánto detalle o juicio está involucrado.
Aplicado a Codex, los propios ejemplos de la documentación clasifican las tareas de esta manera:
- Astra para investigaciones que abarcan sistemas. Rastrear un error en varios servicios, corregirlo y ejecutar las pruebas afectadas.
- Sol para trabajo enfocado e iterativo. Revisar una solicitud de extracción, revisar código después de comentarios o convertir notas en un plan.
- Sol para los hilos individuales más largos, a menos que cambies la ventana. Con la configuración predeterminada, Sol comienza con más espacio en Codex.
El esfuerzo de razonamiento es una elección separada. La guía de prompts sugiere Medium para una revisión rápida, High para rastrear una causa sospechosa en varios sistemas y Extra High cuando varias causas pueden interactuar.
Lo que la gente intenta primero
Buscar GPT-6.2 en un chat regular de ChatGPT. Los modelos están en Work. OpenAI dice que abras Work para usarlos.
Asumir que Astra tiene la ventana más grande. En Codex, el valor predeterminado de Astra es 272,000 tokens y el de Sol es 500,000, a menos que lo cambies.
Aumentar la ventana solo para un modelo. model_context_window se aplica al modelo activo, por lo que un solo valor cubre ambos.
Olvidar una anulación antigua. Un valor que estableciste para un modelo anterior todavía se aplica a los nuevos.
Cambiar de modelo en la parte profunda de un hilo largo. La documentación no describe cómo se maneja un hilo más grande que el nuevo valor predeterminado, así que cambia en un descanso natural.
La solución: Elige el modelo a propósito y mantén el contexto fuera de la ventana
Paso 1: Revisa tu archivo de configuración
Abre config.toml y busca model_context_window y model_auto_compact_token_limit. Manténlos solo si quieres los mismos valores para cada modelo.
Paso 2: Ajusta el modelo al hilo
Usa Astra para investigaciones entre sistemas y Sol para la iteración diaria. Inicia un nuevo hilo cuando cambies el tipo de trabajo.
Paso 3: Verifica después de cambiar
Después de /model, verifica la confirmación en la transcripción y ejecuta /status.
Paso 4: Mantén el contexto del proyecto en un lugar que no dependa del modelo
Escribe las decisiones y restricciones con las que cada hilo debería comenzar, para que un nuevo hilo o un modelo diferente no necesite el historial antiguo.
Configurando esto en MemoryLake
Una ventana de contexto contiene lo que el hilo actual ha recopilado. Cuando cambias de modelo, inicias un nuevo hilo o dejas que la compactación resuma los turnos antiguos, las decisiones detrás de tu proyecto no deberían depender de nada de eso. Qué servicio posee la lógica de reintento, por qué se pospuso una migración, qué pruebas deben pasar antes de un lanzamiento: eso es contexto del proyecto, no historial de la sesión.
MemoryLake es una capa de memoria para ese tipo de contexto de proyecto, como decisiones, restricciones y prioridades actuales, mantenida en un solo lugar que tú controlas y disponible para los asistentes que conectes, como ChatGPT, Claude Code y Codex.
Tú mismo escribes las entradas, con tus propias palabras. No se lee nada, ni se escribe ni se borra de tus hilos de Codex, tu config.toml, tus archivos AGENTS.md, tus memorias de Codex, tus chats de Work o el almacenamiento de cualquier proveedor. GPT-6.2, Codex y Work se comportan de la manera que OpenAI describe.
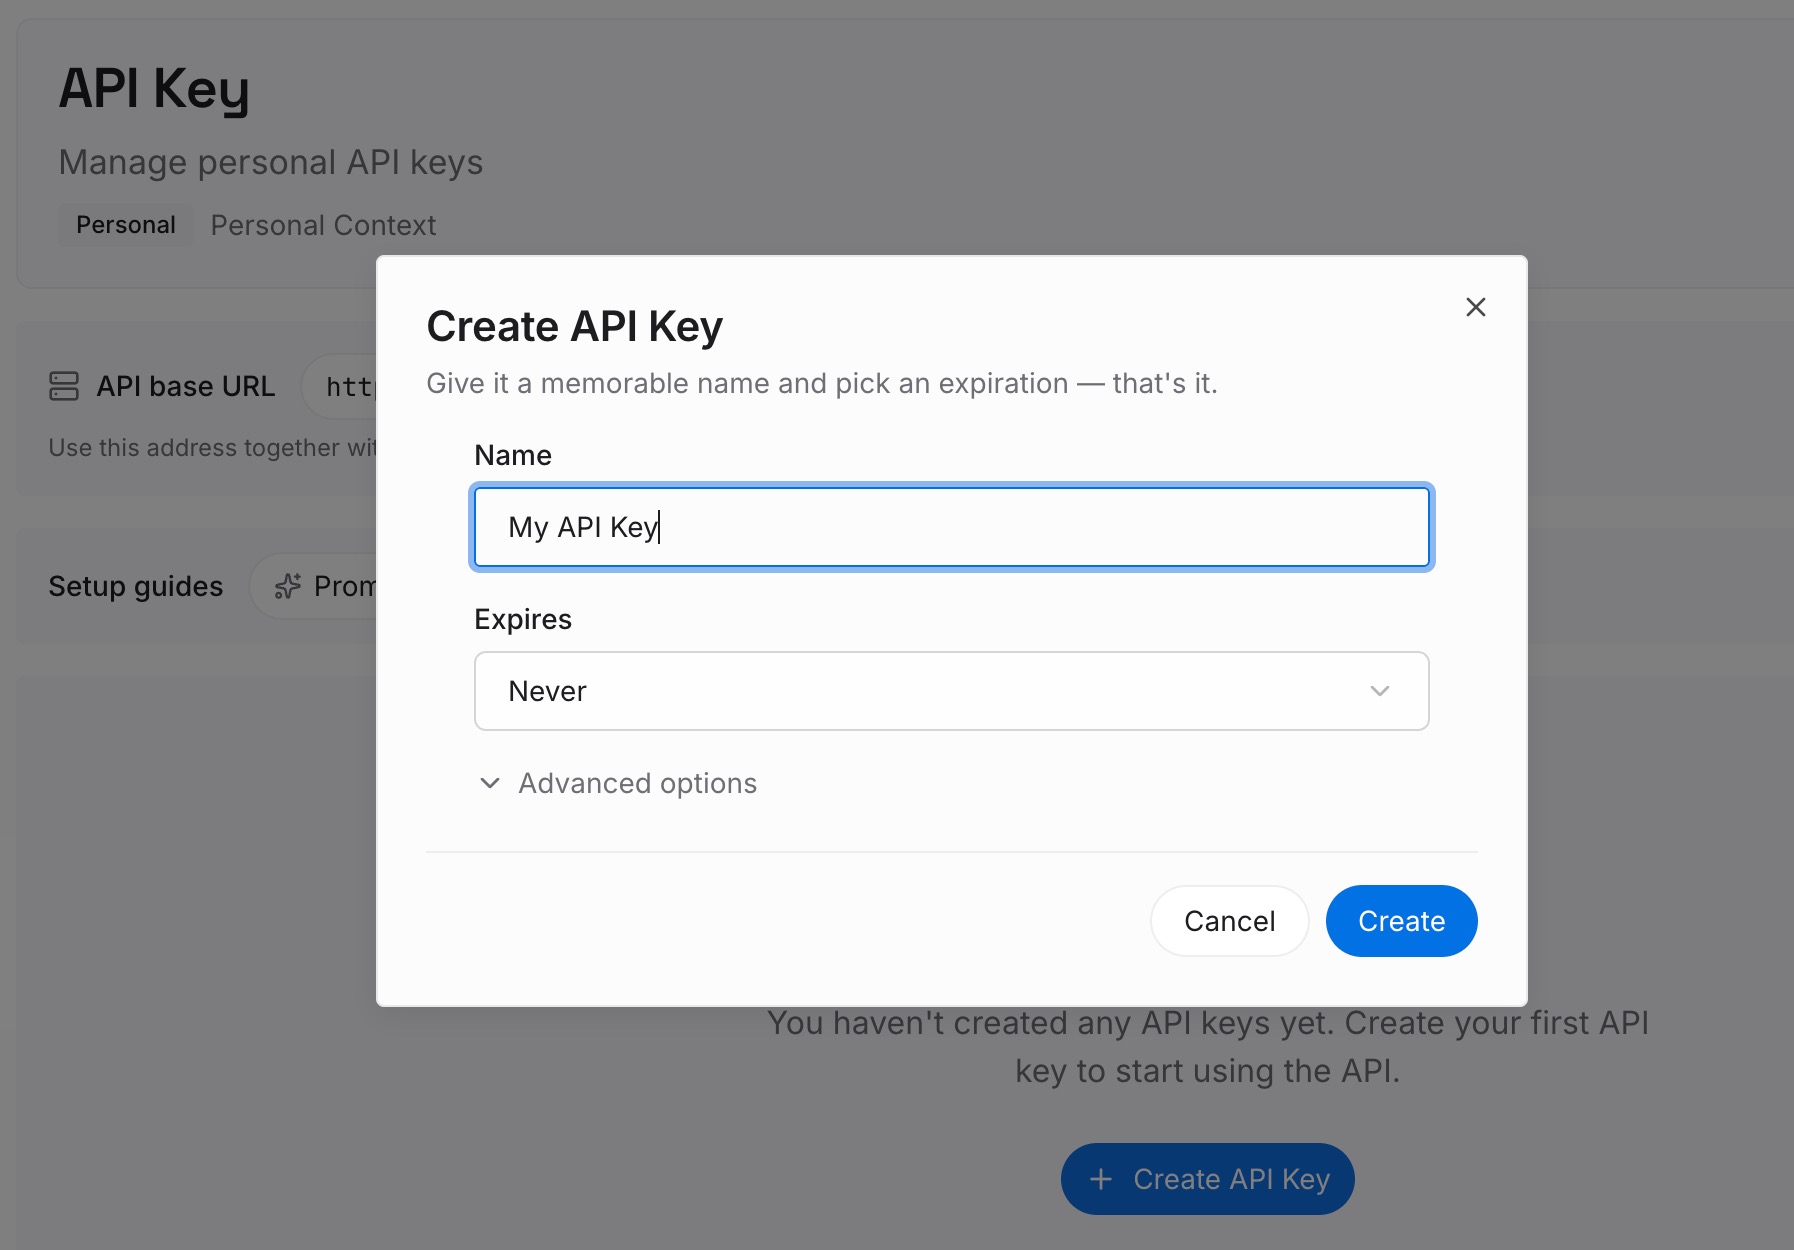
Paso 1: Crea una clave API
Inicia sesión y genera una clave desde el panel de control. Guárdala fuera de tus repositorios, como cualquier otra credencial.
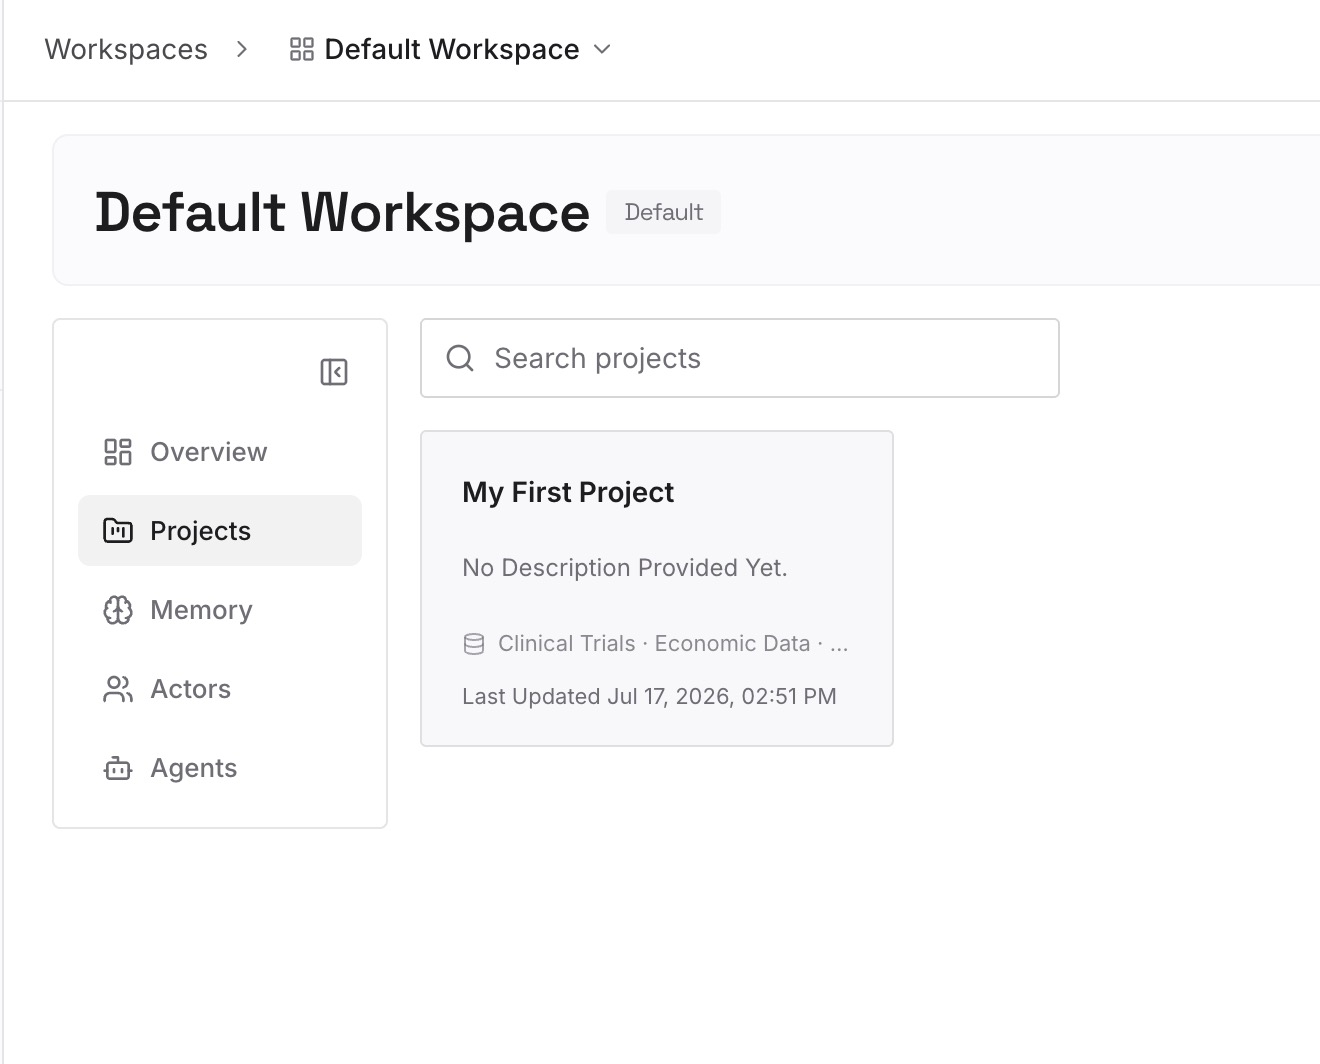
Paso 2: Sube tus primeras memorias
Comienza con lo que escribiste en el Paso 4 de la solución: las decisiones y restricciones que necesita un nuevo hilo. Una decisión por entrada, con la fecha en que se tomó.
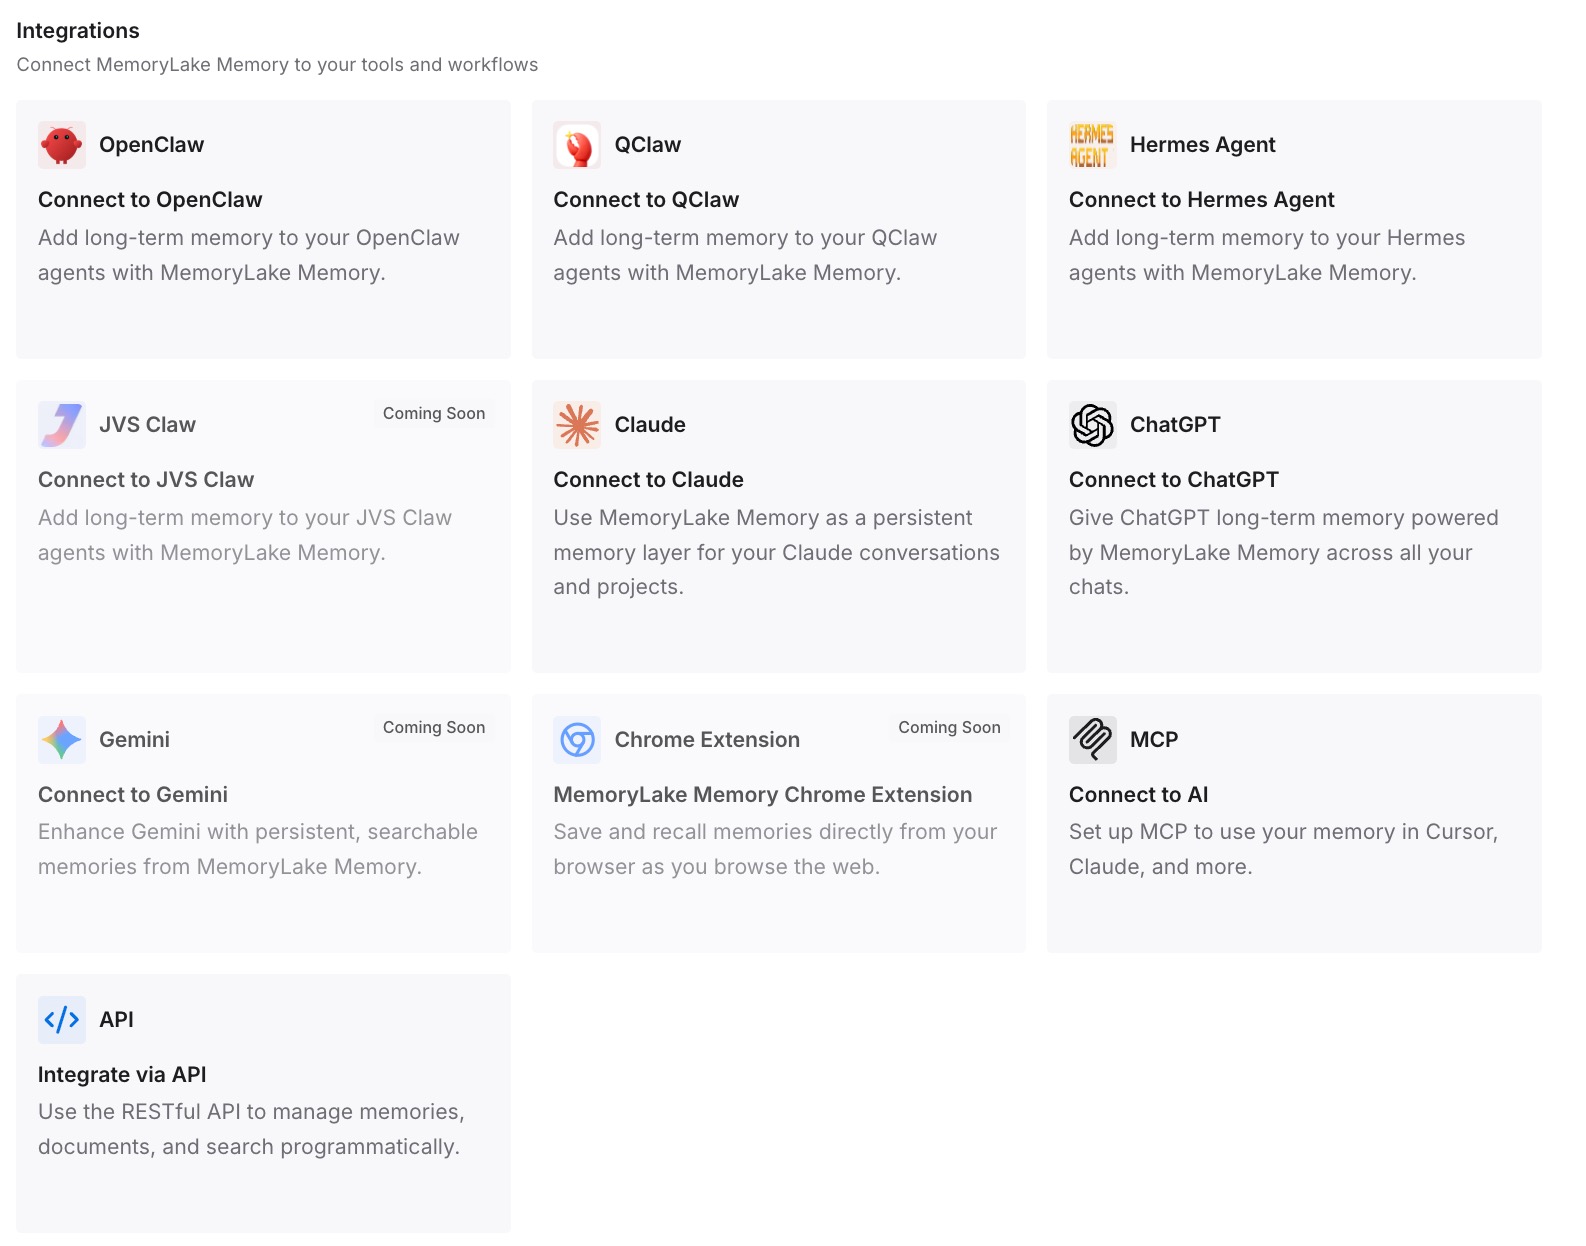
Paso 3: Conecta tu IA y agentes
Conecta Codex, ChatGPT y los otros asistentes que utilices. Cada uno puede recurrir a las mismas decisiones, independientemente del modelo seleccionado.
Qué cambia esto en la práctica
La primera diferencia es un cambio más económico. Un nuevo hilo en Astra puede comenzar con un resumen breve en lugar de un historial largo de Sol.
La segunda es menos preocupación por la compactación. Cuando las decisiones viven fuera del hilo, un resumen que omite detalles cuesta menos.
La tercera es la consistencia entre herramientas. El mismo contexto de proyecto está presente en Codex, en Work y en cualquier otro asistente que conectes.
Mejores prácticas para GPT-6.2 en Codex
Elige Astra para trabajo entre sistemas. Es el modelo que OpenAI recomienda para las investigaciones más difíciles.
Elige Sol para hilos largos cotidianos. Comienza con más espacio en Codex por defecto.
Trata model_context_window como global. Un valor se aplica a cualquier modelo que esté activo.
Limpia las anulaciones antiguas. Los ajustes de modelos anteriores todavía se aplican a los nuevos.
Cambia en descansos naturales. Inicia un nuevo hilo para un tipo de trabajo diferente.
Mantén AGENTS.md ligero. La guía de prompts de OpenAI lo recomienda, y se carga en cada hilo.
Usa Work para el acceso a ChatGPT. Los modelos no están en Chat.
Conclusión
GPT-6.2 Astra y Sol llegaron a ChatGPT Work, Codex y la API el 17 de noviembre. Astra es la elección de OpenAI para el trabajo más difícil y entre sistemas, y Sol es el modelo cotidiano que te permite completar más tareas en el mismo plan que GPT-6.1 Sol. En ChatGPT, accedes a ambos a través de Work, donde los nuevos chats se inician por defecto en Sol.
En Codex, los modelos comienzan con diferentes ventanas predeterminadas: 272,000 tokens para Astra y 500,000 para Sol, con hasta 1 millón disponible para ambos. El ajuste único model_context_window cambia eso para cualquier modelo que esté activo, y un valor antiguo sigue aplicándose hasta que lo elimines. La documentación no dice cómo se maneja un hilo más grande que el valor predeterminado de un nuevo modelo después de un cambio, así que cambia en un descanso natural y mantén las decisiones importantes fuera del hilo.