
Qué cubre el acuerdo y qué deja abierto el anuncio
Comencemos con lo que se compró. Los activos mencionados en el comunicado de prensa son Cosmos, la Auggie CLI, el Code Context Engine y la tecnología relacionada. El papel futuro de Cosmos se define directamente: «Cosmos se convertirá en Harness Cosmos Software Factory Agent, con una función clara: automatizar el trabajo de ingeniería desde la idea hasta el código». El comunicado también indica que «Harness Cosmos ya está disponible».
Dos líneas del comunicado se refieren al contexto. La primera trata sobre el índice: «El Code Context Engine de Augment mantiene un mapa en vivo de la base de código, de modo que los cambios se adapten al código ya existente». La segunda trata sobre la memoria: «La memoria compartida traslada las lecciones de cada revisión al siguiente cambio». Ambas se describen como parte de lo que ofrecerá Harness Cosmos en el futuro.
La propia publicación del blog de Harness añade una línea dirigida a los usuarios actuales: «Los clientes pueden adoptar el Harness Cosmos Software Factory Agent, seguir utilizando sus herramientas de programación preferidas o usar ambas». También dice, sobre los productos y el equipo: «Estamos invirtiendo en los productos, la tecnología y las personas que los crearon».
Lo que el anuncio y sus preguntas frecuentes no describen es la mecánica para las cuentas existentes: cómo se trasladan los espacios de trabajo, índices y memorias de Expert actuales, si cambia algo en la facturación o el manejo de datos, o qué sucede con las extensiones de Augment para VS Code y JetBrains, que el comunicado no menciona entre los activos adquiridos. Esto no es, por sí mismo, una señal de problemas. Significa que el material publicado trata sobre la dirección estratégica, y los detalles operativos para los clientes actuales provendrán directamente de Harness y Augment.
Esa brecha es exactamente la razón por la que vale la pena hacer un inventario ahora. No necesitas esperar a recibir un correo electrónico para saber qué parte de tu contexto es portable por diseño.
Contexto que vive en tu repositorio
La documentación de Augment es clara sobre dónde se almacenan las reglas y las directrices del espacio de trabajo: «Las Workspace Guidelines y Rules se almacenan directamente en tu repositorio». La documentación de la CLI dice lo mismo sobre las reglas del espacio de trabajo: «Las reglas del espacio de trabajo se almacenan en el repositorio del proyecto y se aplican solo a ese proyecto específico».
Augment también lee archivos neutros respecto a las herramientas. Su jerarquía de reglas incluye CLAUDE.md y AGENTS.md junto con .augment/rules/, y descubre AGENTS.md y CLAUDE.md en subdirectorios a medida que trabajas. Cualquier cosa que tu equipo haya escrito en estos archivos está bajo control de versiones, es revisable y puede ser leída por otros agentes. Pertenece a tu repositorio, no a la cuenta de un proveedor.
Contexto que vive en tu máquina
Las preferencias personales están más cerca de ti. «Las User Guidelines se almacenan localmente en tu IDE y se aplicarán a todos los chats futuros en ese IDE». En VS Code, Augment nombra el archivo: «En Visual Studio Code, el archivo de directrices por usuario es ~/.augment/user-guidelines.md». Para la CLI, «Las reglas de usuario se almacenan en tu directorio de inicio y se aplican a todos los proyectos».
Estos son archivos de texto plano en tu directorio de inicio. Son tuyos en el sentido más literal, aunque también son fáciles de olvidar porque nadie los confirma (commit) en el repositorio.
Contexto que vive en la plataforma de Augment
El resto lo retiene el servicio. La indexación es el ejemplo más claro: «Cuando abres un espacio de trabajo con Augment habilitado, tu base de código se cargará automáticamente en la nube segura de Augment». El Context Engine remoto funciona de la misma manera: te conectas al «Context Engine alojado en Augment a través de HTTP» y este indexa las ramas predeterminadas de los repositorios seleccionados.
La memoria de Expert de Cosmos también está en el lado de la plataforma. «La memoria permite que un Expert retenga un contexto útil a través de las sesiones. Almacena conocimiento acotado en el sistema de archivos virtual (VFS) compartido». La documentación añade que «La memoria de un Expert pertenece a su equipo y está separada por un alcance adecuado para el flujo de trabajo», y que «El Expert escribe la información como Markdown legible bajo su propio directorio VFS».
Un índice se puede reconstruir a partir de tu código. La memoria de Expert es diferente. Es el residuo de meses de comentarios de revisión, correcciones y decisiones, destilados en notas cortas. Esa es la pieza que más vale la pena asegurar en un formato que tú controles.
Qué intenta la gente en su lugar
Asumir que nada cambia. Posiblemente sea cierto por un tiempo. Pero se vendieron «activos seleccionados» y el material publicado cubre el futuro de Cosmos, no el camino para cada espacio de trabajo existente. Trata la continuidad como algo que debes confirmar en lugar de asumir.
Asumir que todo se pierde. También es incorrecto. Las reglas, las directrices del espacio de trabajo y los archivos AGENTS.md están en tu repositorio. Las directrices de usuario y las reglas de usuario son archivos en tu máquina. Una gran parte del contexto que da forma al comportamiento de Augment nunca estuvo en la plataforma.
Intentar exportar el índice. El índice es un artefacto derivado construido a partir de tu código. No necesitas una copia de él. Cualquier herramienta que indexe tu repositorio construirá el suyo propio.
Esperar a recibir un aviso de migración antes de hacer nada. El inventario que se presenta a continuación requiere una tarde de trabajo y es útil independientemente de lo que Harness anuncie a continuación, incluso si sigues utilizando Cosmos bajo su nuevo nombre.
Mover todo al formato de reglas de un solo proveedor. Si más adelante evalúas otras herramientas, habrá que traducir .augment/rules/. Los archivos neutros respecto a las herramientas viajan más lejos, como muestran detalladamente las notas sobre cómo migrar de Augment Code a Cursor.
La solución: clasifica tu contexto de Augment según dónde reside y luego completa la capa portable
Paso 1: Inventariar cada lugar donde reside el contexto de Augment de tu equipo
Haz una lista corta por repositorio y por persona.
En cada repositorio, busca .augment/rules/, .augment-guidelines, AGENTS.md y CLAUDE.md, incluidas las copias anidadas en subdirectorios. Toma nota de qué reglas se aplican siempre y cuáles son condicionales, ya que el frontmatter de Augment controla cuándo se aplica una regla de espacio de trabajo.
En la máquina de cada desarrollador, busca ~/.augment/rules/ y, para los usuarios de VS Code, ~/.augment/user-guidelines.md. Los usuarios de JetBrains deben revisar la configuración de su IDE, ya que Augment señala que las directrices «definidas en VSCode no se propagarán a los IDE de JetBrains y viceversa».
En el lado de la plataforma, enumera tus Experts de Cosmos, cuáles tienen la memoria habilitada y qué alcance utiliza cada uno. La documentación de Augment dice que «La memoria está habilitada para todos los Template Experts», por lo que si usas plantillas, asume que la memoria se está acumulando. Si has estado ajustando esa memoria deliberadamente, los ajustes descritos en cómo guiar lo que los Experts de Cosmos de Augment aprenden de tus comentarios son los que debes registrar.
Por último, anota qué repositorios están conectados al Context Engine remoto y qué máquinas ejecutan el servidor local a través de la Auggie CLI.
Paso 2: Escribir lo que tus Experts han aprendido mientras sea fácil de leer
La memoria de Expert se almacena como Markdown, y en las sesiones interactivas un Expert «te avisa cuando recuerda algo para que puedas corregirlo o vetarlo». Eso hace que sea revisable. Lee las directrices recordadas para cada Expert y alcance de repositorio.
Luego clasifícalo. Parte de ello será conocimiento duradero del equipo: convenciones de nomenclatura, estándares de revisión, una dependencia que nunca debe actualizarse sin una prueba de ejecución, un servicio que posee una tabla en particular. Otra parte será ruido o ya estará desactualizada.
Mueve los elementos duraderos al repositorio, con tus propias palabras. Una sección corta en AGENTS.md o una regla de espacio de trabajo es suficiente. La propia guía de Augment respalda esta división: «Usa habilidades o instrucciones de Expert para flujos de trabajo explícitos; usa la memoria para el contexto aprendido a través del trabajo continuo». Una vez que una lección aprendida ha demostrado su eficacia, merece convertirse en una instrucción explícita que viva con el código.
Haz lo mismo con el contexto personal. Si las directrices de usuario de un desarrollador contienen convenciones del equipo en lugar de preferencias personales, mueve esas convenciones al repositorio para que no se vayan con esa persona o esa computadora portátil. La versión general de este traspaso se trata en cómo conservar el contexto de IA de tu equipo cuando alguien se va.
Paso 3: Mantener la capa de reglas legible por más de una herramienta
Augment lee AGENTS.md y CLAUDE.md de forma jerárquica, lo cual es conveniente: puedes poner convenciones compartidas en esos archivos y seguirán funcionando en Augment, a la vez que serán legibles por otros agentes. Reserva .augment/rules/ para cosas que realmente dependan de las características de Augment, como la aplicación condicional a través de frontmatter.
Comprueba que los archivos se estén leyendo realmente. La documentación de Augment señala un detalle de alcance que es fácil pasar por alto: «Los archivos en .augment/rules/ solo se cargan desde la raíz del espacio de trabajo, no desde los subdirectorios». En su lugar, el contexto anidado debe ir en archivos AGENTS.md anidados. En un sentido más amplio, por qué los agentes de IA ignoran los archivos de instrucciones que escribiste analiza las reglas de carga que suelen confundir a los equipos.
Si tu equipo llegó a Augment desde Claude Code, el mapeo inverso en cómo migrar de Claude Code a Augment Code es una lista de verificación útil: lo que sea que hayas traducido al entrar es lo que traducirías al salir.
Configuración en MemoryLake
Los pasos 2 y 3 mueven el conocimiento del equipo al repositorio. Hay contextos que no encajan allí: decisiones que abarcan varios repositorios, las razones detrás de una convención, lecciones de un proyecto que se aplican al siguiente y preferencias de trabajo personales que deseas en cada herramienta que utilizas. MemoryLake es un lugar para mantener esa capa, independientemente de qué proveedor sea el propietario de tu agente de programación este trimestre.
Tú mismo escribes las entradas, con tus propias palabras. No se lee, escribe ni elimina nada de Augment, Harness, tus repositorios ni de la tienda de ningún proveedor. Antes de añadir cualquier información sobre el código o las decisiones de tu empleador, consulta la política de tu organización.
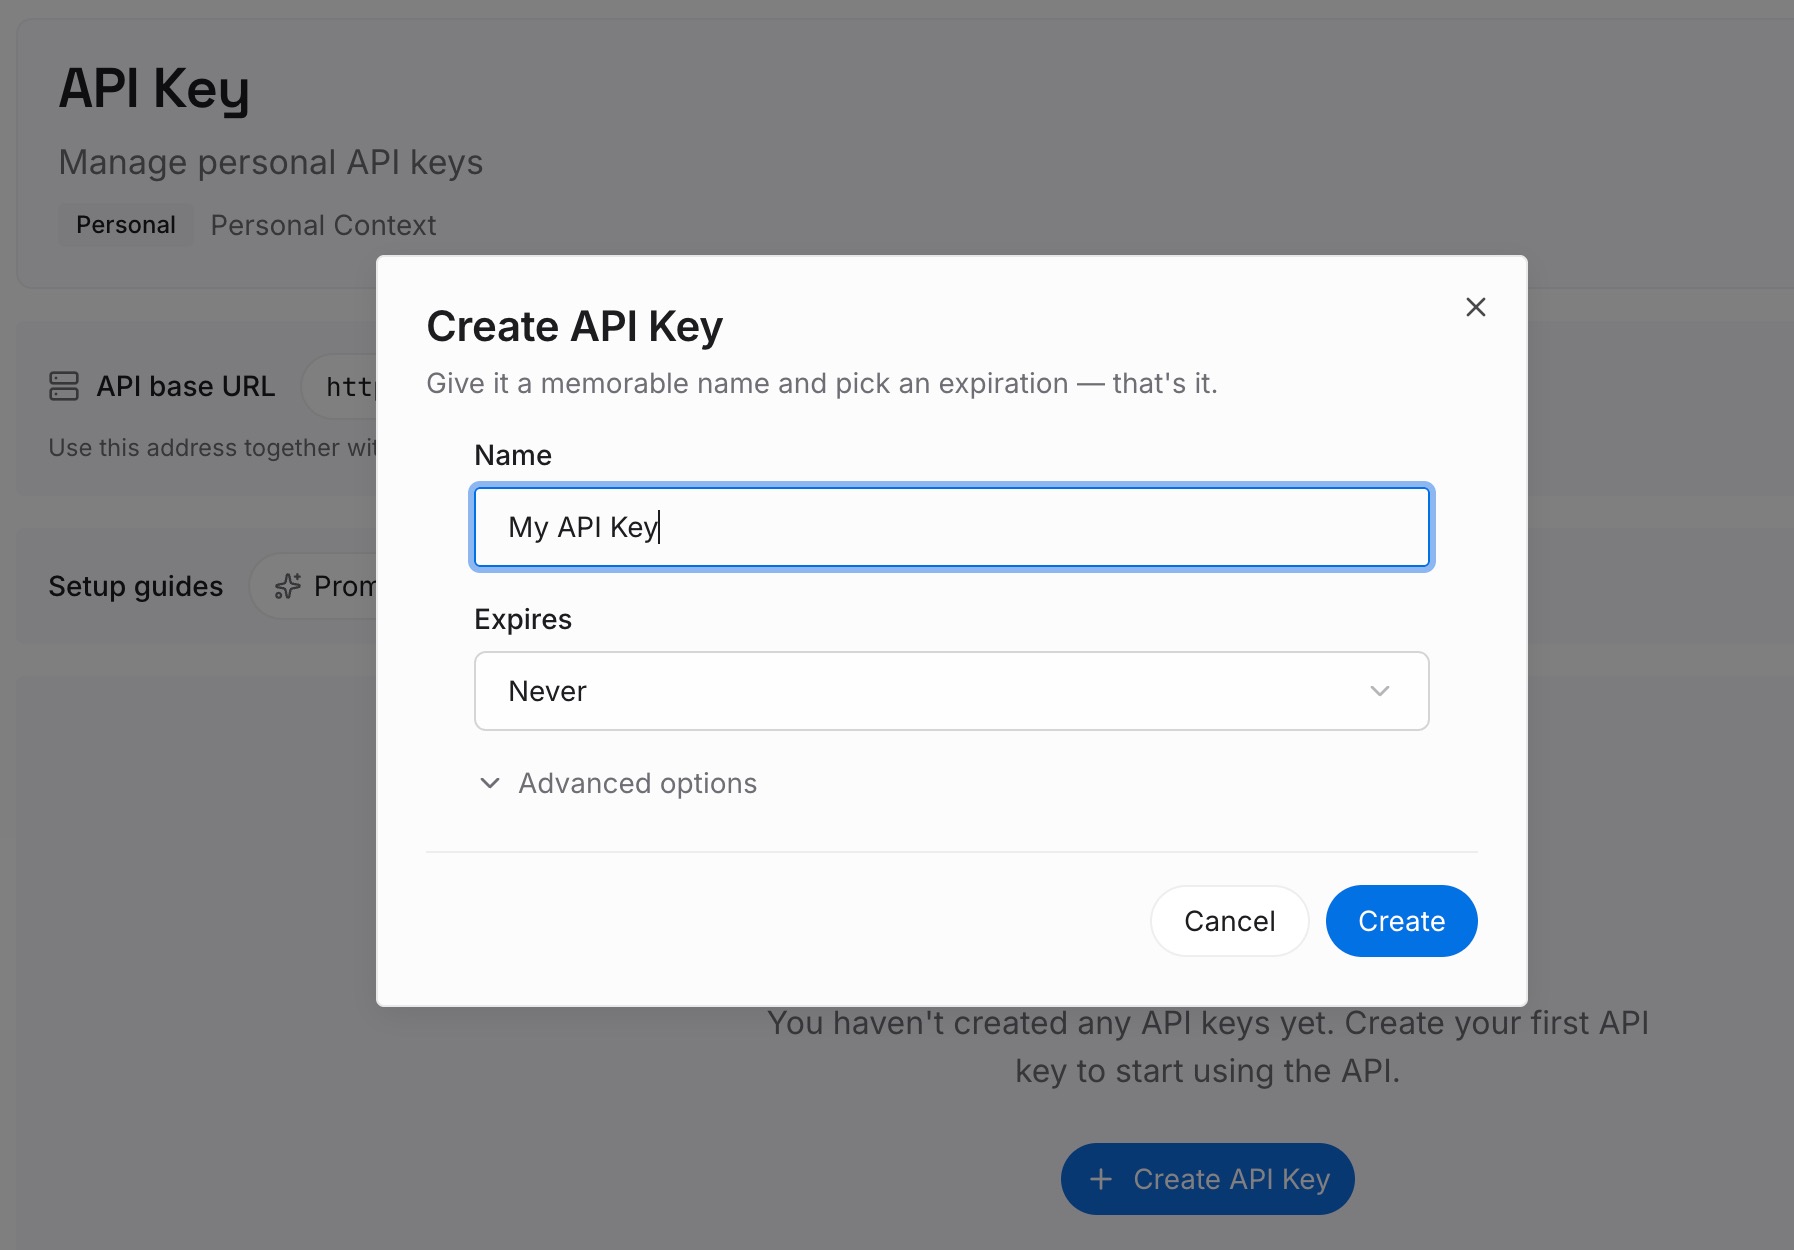
Paso 1: Crear una clave API
Inicia sesión y genera una clave desde el panel de control. La clave pertenece a tu espacio de trabajo de MemoryLake, de forma independiente a cualquier cuenta de Augment o Harness.
Paso 2: Subir tus primeras memorias
Comienza con las lecciones inter-repositorio que clasificaste de tu memoria de Expert en el Paso 2, y las preferencias personales que no son específicas de una sola base de código. Una decisión o preferencia por entrada, con fecha.
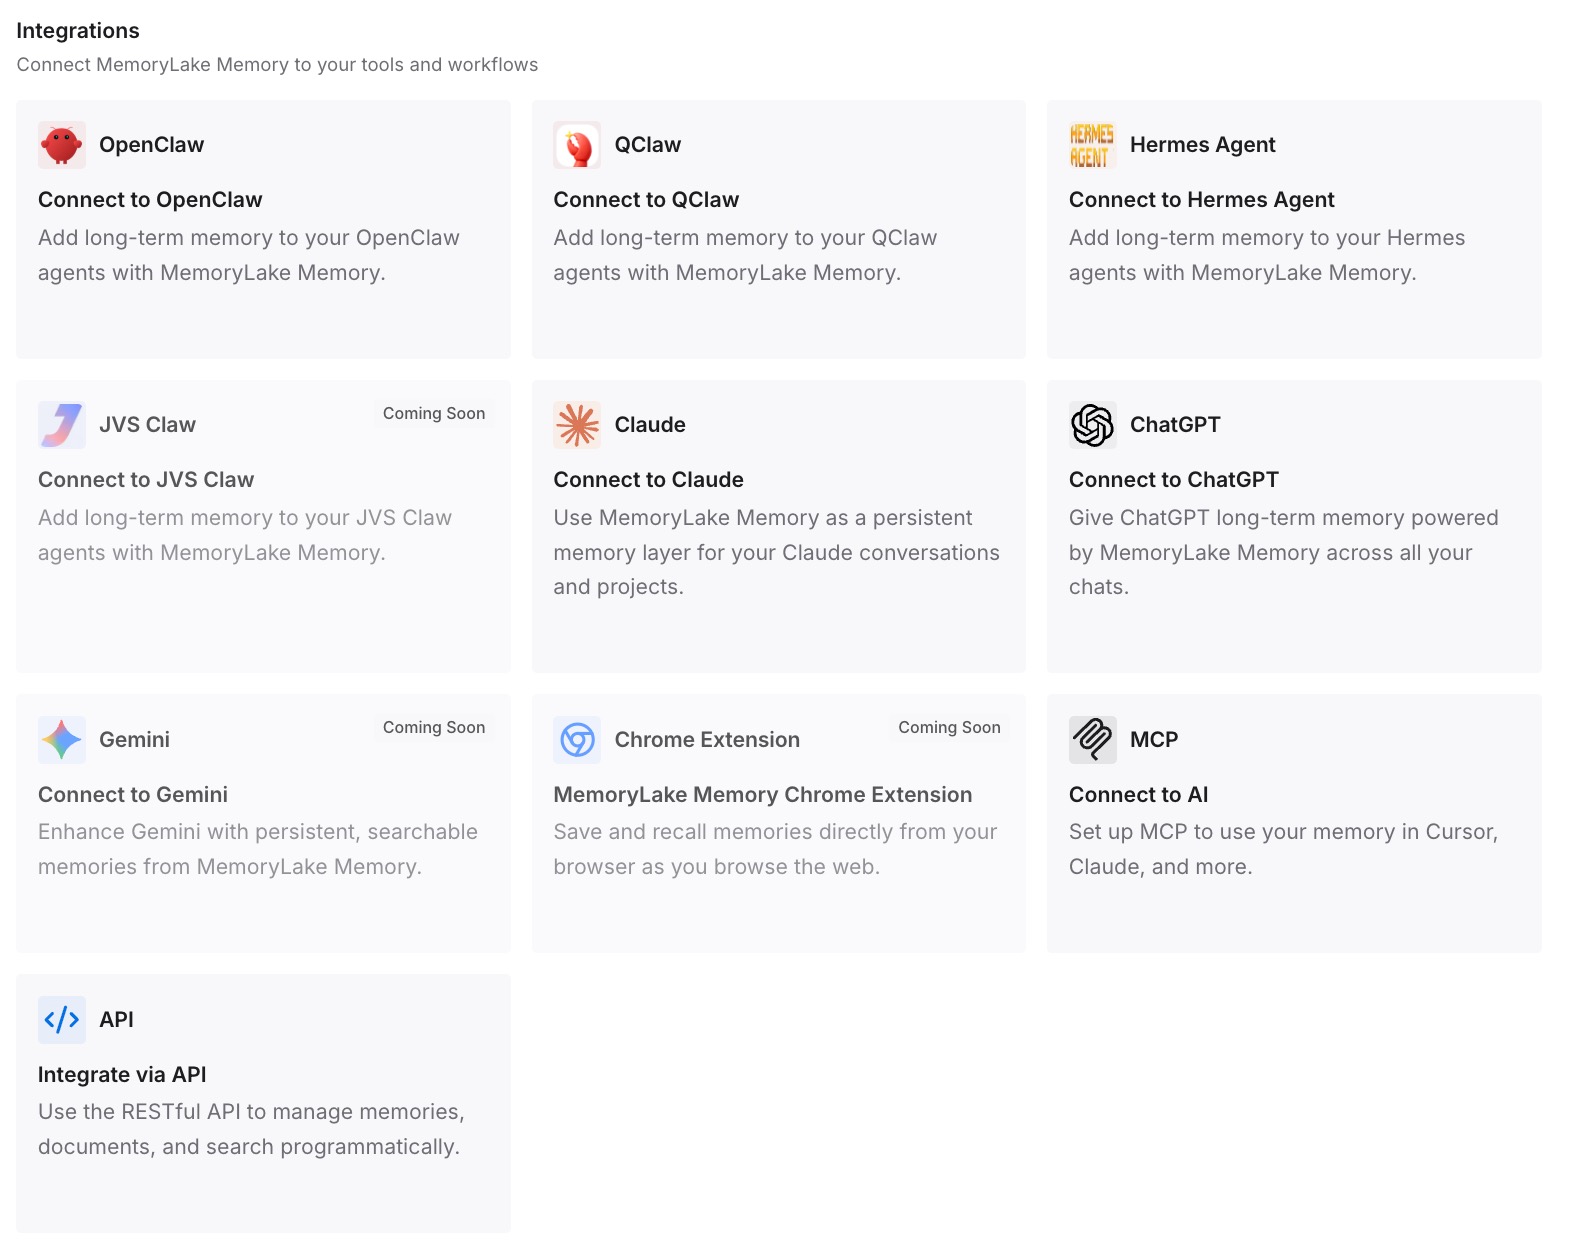
Paso 3: Conectar tu IA y agentes
Conecta los agentes y asistentes de programación que utilizas. El mismo contexto estará disponible tanto si te quedas en Cosmos, como si añades otro agente o cambias de herramienta.
Qué cambia esto en la práctica
La primera diferencia es una imagen clara. En lugar de tratar todo como una pila indiferenciada de contexto de Augment, sabes qué partes están en Git, cuáles en las computadoras portátiles y cuáles en la plataforma.
La segunda es que la parte retenida en la plataforma se reduce a lo que debería ser. Los índices se reconstruyen a partir del código. La memoria de Expert sigue haciendo su trabajo, pero las lecciones más importantes también existen como texto revisado en tu repositorio.
La tercera es la opcionalidad. Ya sea que adoptes Harness Cosmos, sigas utilizando las herramientas de Augment a medida que evolucionan o evalúes otra opción, tus reglas viajan contigo. El argumento más amplio para mantener el contexto portable se expone en ¿es la memoria de IA una característica o un bloqueo de proveedor?.
La cuarta es la resiliencia ante el próximo cambio, sea cual sea. Las adquisiciones, los cambios de nombre y las modificaciones de precios son normales en esta categoría. Los equipos cuyo contexto vive en archivos que ellos controlan tratan estos cambios como cuestiones de adquisición en lugar de eventos de pérdida de conocimiento.
Buenas prácticas para los equipos de Augment tras el acuerdo con Harness
Haz un inventario antes de actuar. Enumera por separado las reglas del repositorio, las directrices locales y el contexto retenido en la plataforma.
Lee tu memoria de Expert ahora. Está en Markdown y es revisable. Promueve las lecciones duraderas al repositorio.
Prefiere archivos neutros respecto a las herramientas para las reglas compartidas. AGENTS.md y CLAUDE.md funcionan en Augment y más allá.
Mueve las convenciones del equipo fuera de las directrices personales. Los archivos personales se van con la persona.
No intentes conservar el índice. Se reconstruye a partir de tu código con cualquier herramienta que utilices.
Confirma los detalles de la cuenta directamente. Pregunta a Harness o Augment sobre los espacios de trabajo, el manejo de datos y las extensiones en lugar de deducirlo del comunicado de prensa.
Compara opciones con criterios claros. Si estás revisando alternativas, las mejores herramientas de memoria de base de código para equipos de ingeniería detalla qué evaluar.
Conclusión
Harness ha adquirido Cosmos, la Auggie CLI, el Code Context Engine y la tecnología relacionada, así como el equipo detrás de ellos. El anuncio describe un futuro en el que el contexto del código y el contexto de entrega están conectados, y les dice a los clientes actuales que pueden adoptar Harness Cosmos, conservar sus herramientas preferidas o usar ambas.
Lo que aún no detalla es cómo se trasladan los espacios de trabajo, los índices y las memorias de Expert existentes. No necesitas esa respuesta para proteger tu contexto. Las reglas y las directrices del espacio de trabajo ya están en tu repositorio. Las directrices de usuario y las reglas de usuario son archivos en tu máquina. El índice se puede reconstruir. La pieza sobre la que vale la pena actuar es la memoria de Expert: léela, conserva lo que se ha ganado su lugar y escríbelo en archivos que pertenezcan a tu equipo.
Haz eso, y la adquisición se convertirá en una pregunta sobre herramientas en lugar de una pregunta sobre lo que sabe tu equipo.