
Qué se transfiere realmente
Un Space consta de cuatro cosas, y llegan de manera muy diferente al otro lado.
Los hilos se transfieren como documentos, uno a la vez. Abre un hilo, usa el menú de compartir o de más opciones, y expórtalo a PDF, Markdown o DOCX. Markdown es el que quieres: la exportación conserva tus prompts, las respuestas, el formato y los bloques de citas con la lista de fuentes, que es la parte que hace que la investigación sea reutilizable más adelante. No existe una forma oficial de exportar un Space completo en una sola acción. Existen extensiones de navegador que exportan Spaces por lotes e incluso los envían a Notion, y funcionan; también requieren autorizar el acceso a tu cuenta de Perplexity, lo cual es una decisión que debes tomar de manera deliberada y no a la ligera.
Los archivos subidos no se transfieren; ya los tienes. Los PDF y documentos que adjuntaste al Space siguen en tu disco, o deberían estarlo. Vuelve a subirlos o cópialos en el repositorio en lugar de intentar extraerlos de Perplexity.
Las instrucciones personalizadas se transfieren casi directamente. Las instrucciones de un Space ya están escritas como directrices sobre el tono, la profundidad y qué priorizar. La mayor parte se adapta a CLAUDE.md con una edición ligera; las partes sobre el estilo de cita y la longitud de la respuesta no suelen sobrevivir al viaje, porque ya no estás pidiendo respuestas, estás pidiendo código.
La exploración no se transfiere, y no debería. Treinta de tus cuarenta hilos fueron para descubrir cuál era la pregunta correcta. Su valor radicó en producir los otros diez. Exportar los cuarenta le da a Claude Code un montón de razonamientos superados, algunos de los cuales contradicen tu conclusión final, y todos compitiendo por el contexto. Aquí es donde las migraciones fallan: no por perder información, sino por cargar con demasiada.
Una asimetría que vale la pena mencionar desde el principio. La memoria de Perplexity se organiza en torno a hilos: cada conversación es su propio contenedor, por lo que el contenido dentro de un Space no informa automáticamente a tus otros hilos. La memoria de Claude Code se organiza en torno al sistema de archivos: lee lo que hay en el proyecto. No solo estás moviendo texto entre herramientas; estás convirtiendo conocimiento en forma de conversación en conocimiento en forma de archivo. Todo lo que sigue a continuación es esa conversión.
La migración manual
Paso 1: Exporta los hilos que aún importan
Revisa el Space y haz un triaje antes de exportar nada. Para cada hilo, hazte una pregunta: ¿contiene esto una conclusión que defendería o una búsqueda que ya terminé? Exporta el primer tipo. Omite el segundo.
En concreto, conserva los hilos que establecieron una decisión ("estamos usando esta biblioteca debido a la licencia"), los hilos que reunieron evidencia comparativa que querrás citar de nuevo, los hilos con datos de dominio que limitan la construcción (límites de velocidad, formatos, requisitos regulatorios) y los hilos donde te equivocaste y descubriste por qué. Esta última categoría es la más valiosa y la que más se suele descartar.
Para cada hilo que decidas conservar: abre el hilo, usa el menú de compartir o de más opciones, elige Markdown. Obtendrás los prompts, las respuestas, el formato y las citas con su lista de fuentes. Conserva las citas: la razón principal para migrar la investigación en lugar de volver a hacerla es que las fuentes vienen con ella.
Si un Space tiene docenas de hilos que conservar, aquí es donde las herramientas de exportación masiva de terceros se ganan su lugar. Evalúalo con honestidad: necesitan acceso a tu cuenta, y le estás dando a una extensión de navegador la capacidad de leer todo en tu cuenta de Perplexity. Para un Space de investigación personal, puede estar bien. Para cualquier cosa bajo un acuerdo de confidencialidad (NDA) con un cliente, exporta los hilos a mano y no lo pienses más.
No te saltes el triaje solo porque exista la exportación masiva. El objetivo del triaje no es ahorrar clics de exportación; es que todo lo que transfieras competirá por la atención de Claude Code más adelante.
Paso 2: Convierte las exportaciones en archivos que Claude Code realmente cargue
Las exportaciones de hilos en bruto no son documentos de proyecto útiles. Un hilo es una transcripción: tu pregunta a medio formular, una respuesta larga, un seguimiento corrigiéndola, otra respuesta. Claude Code leerá todo eso y dará peso a las partes incorrectas.
Así que condensa. Para cada grupo de hilos relacionados, escribe un archivo Markdown en el repositorio (una ubicación razonable es docs/research/) con esta estructura:
- La conclusión primero, en una o dos frases, expresada como un hecho sobre el proyecto.
- Lo que se descarta, si corresponde. "Evaluamos X y lo rechazamos debido a Y" evita que un agente vuelva a proponer alegremente X en tres semanas.
- La evidencia, condensada, con los enlaces de origen del bloque de citas de la exportación.
- La fecha y la herramienta de la que provino. La investigación caduca; un archivo con fecha te permite saberlo.
Luego, haz que Claude Code sea consciente de ello. CLAUDE.md en la raíz del proyecto es el archivo que carga automáticamente; ahí es donde van los punteros, no el contenido:
## Contexto de investigación
Las decisiones y su evidencia viven en `docs/research/`. Lee
`docs/research/auth-approach.md` antes de tocar cualquier cosa bajo `src/auth/`.
No vuelvas a abrir las decisiones registradas allí sin avisar.
Dos cosas hacen que esto funcione mejor que volcar la investigación directamente. Primero, CLAUDE.md se carga en cada sesión, por lo que mantenerlo limitado a punteros y reglas no te cuesta casi nada por tarea, mientras que un volcado de investigación de 4,000 palabras te cuesta en cada solicitud. Segundo, las importaciones con @path te permiten traer un archivo específico cuando realmente es relevante, en lugar de hacerlo siempre.
Coloca las preferencias personales en ~/.claude/CLAUDE.md en lugar de en el archivo del proyecto, y haz commit del archivo del proyecto para que tu equipo herede el mismo contexto. Si prefieres que Claude Code redacte la primera versión del archivo, /init lo estructurará a partir del repositorio, y /memory abre los archivos de memoria para editarlos directamente.
Luego, establece las expectativas correctamente: esto hace que el conocimiento esté disponible, no recordado. Claude Code sigue iniciando cada sesión desde cero y sigue compactando el contexto en sesiones largas, razón por la cual olvida el contexto del proyecto entre sesiones incluso con buenos archivos implementados. Los archivos son el suelo, no el techo.
La mejor manera: una capa de memoria, investigación y código
Mira lo que fue realmente el Paso 2: convertiste a mano la investigación del formato de una herramienta al formato de otra, y guardaste el resultado en un lugar que solo la segunda herramienta puede leer.
Ahora piensa en los próximos seis meses. Volverás a investigar, en Perplexity o en lo que sea que lo reemplace, y construirás en Claude Code, o Codex, o algo anunciado en octubre. Cada combinación necesita su propia conversión. El conocimiento es estable; las herramientas a su alrededor no lo son.
Mantener el conocimiento en una capa a la que ambas partes puedan acceder elimina el paso de conversión. MemoryLake es una capa de memoria que se sitúa debajo de tus herramientas: las notas de investigación, las decisiones y los documentos de origen se introducen una vez, y Claude Code los lee a través de MCP mientras que cualquier otra cosa que uses lee el mismo almacén a través de la API. Tu investigación deja de ser un artefacto de Perplexity que necesita migración y se convierte en algo que tus herramientas consultan.
Siendo justos con los pros y contras: docs/ más CLAUDE.md tiene virtudes reales. Es texto plano, está en control de versiones, se revisa en las pull requests y funciona sin configuración previa. Consérvalo para todo lo que pertenezca a la base de código. La capa de memoria se gana su lugar para el conocimiento que no tiene forma de repositorio (investigaciones entre proyectos, contexto del cliente, decisiones que abarcan tres repositorios) y para hacer que ese conocimiento sea legible desde una herramienta que aún no has elegido.
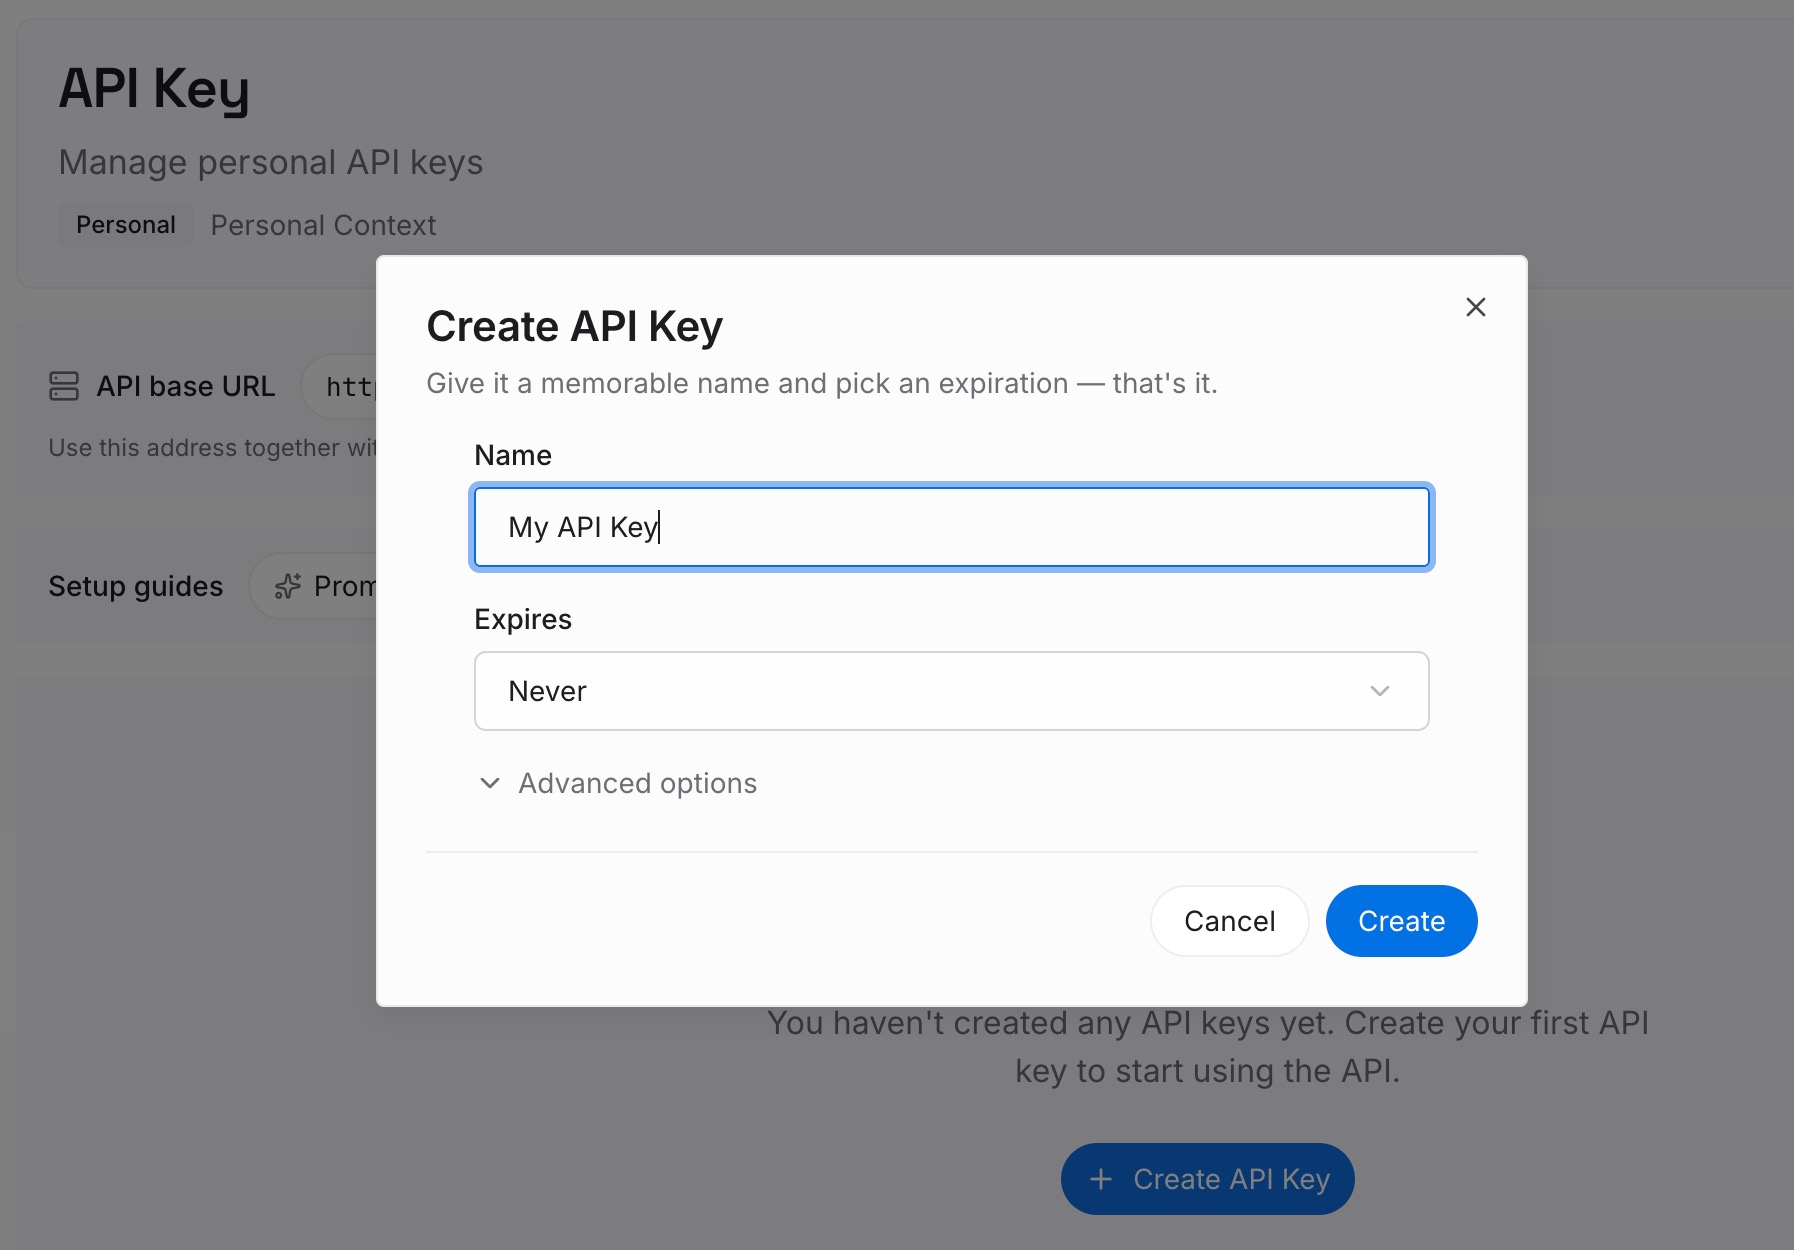
Paso 1: Crea una clave de API
Genera una clave y realiza tu primera solicitud en unos 30 segundos. Guárdala en tu entorno o en un gestor de secretos, no directamente en un archivo de configuración que se suba al repositorio o se sincronice.
Paso 2: Sube tus primeras memorias
Sube los documentos, imágenes y archivos en los que realmente se apoya tu investigación: los hilos exportados, los PDF que habías subido al Space, el documento de decisiones. Sube las fuentes siempre que puedas, no solo tu resumen de ellas. Un resumen es donde suele desaparecer la advertencia que realmente importaba.
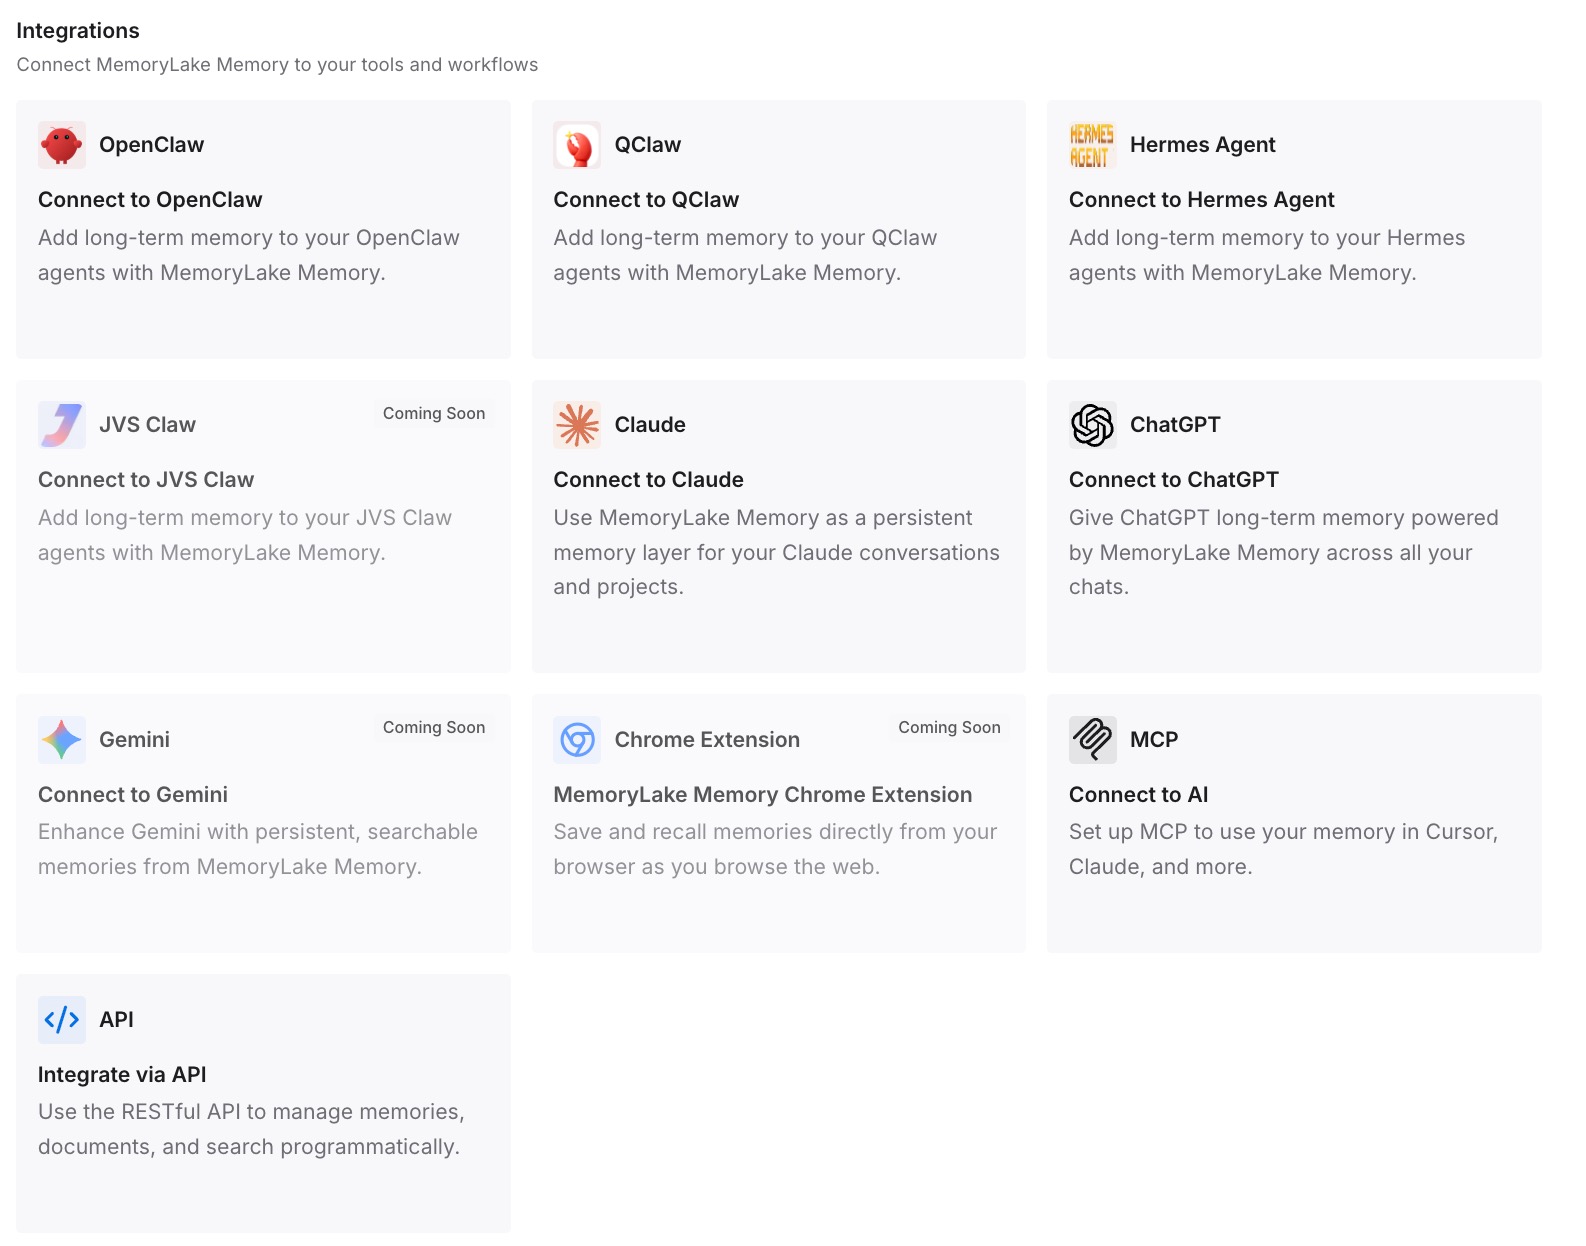
Paso 3: Conecta tu IA y agentes
Dale a Claude, Codex, OpenClaw y otros agentes de IA acceso a la memoria a través de MCP o la API. Claude Code es compatible con servidores MCP, por lo que esto es una entrada de configuración en lugar de una reescritura. Para herramientas de investigación sin un cliente MCP (Perplexity entre ellas), extrae lo que necesites a través de la API e inyéctalo en el prompt o flujo de trabajo, de modo que la dirección de viaje funcione en ambos sentidos.
Qué cambia esto en la práctica
El primer cambio es que a la pregunta "¿qué decidimos sobre la autenticación?" se le responde con fuentes adjuntas, en la herramienta donde estás escribiendo el código. No con un enlace a un hilo en otro producto que tendrías que ir a leer.
El segundo es que las opciones rechazadas siguen rechazadas. El fallo más común tras una transferencia de investigación a desarrollo es que un agente proponga con total seguridad la biblioteca que pasaste una semana descartando, porque el descarte vivía en un hilo de Perplexity y el código vive aquí. Una vez que la decisión y su razonamiento están en el almacén, eso se acaba.
El tercero es la dirección que la mayoría de la gente no prevé: también funciona a la inversa. Una vez que las decisiones de implementación están en la misma capa, tu próxima fase de investigación puede comenzar a partir de lo que realmente hace la base de código, en lugar de lo que recuerdas que hace.
Y prácticamente, sobrevive al próximo cambio. Ya sea que termines en Cursor o de vuelta en un producto de chat, el conocimiento está en un solo lugar y la herramienta es un cliente.
Buenas prácticas para la migración
Condensa antes de importar, no después
El instinto es mover todo y dejar que el agente lo resuelva. No lo hará: dará el mismo peso a una respuesta superada que a la final, porque nada en la exportación indica cuál es cuál. Diez documentos de conclusiones bien escritos superan a cuarenta transcripciones, y el acto de escribir es lo que te obliga a notar qué conclusiones no puedes defender realmente.
Conserva las citas
La razón por la que migrar la investigación supera a volver a hacerla es que las fuentes vienen con ella. Eliminar los bloques de citas de tus exportaciones para que queden más limpios significa conservar las afirmaciones pero descartar la evidencia, lo que significa que la primera vez que alguien cuestione una, volverás a estar en la barra de búsqueda. La exportación a Markdown incluye la lista de fuentes. Déjala ahí.
Pon fecha a todo y señala lo que esté obsoleto
La investigación sobre una API que cambia rápidamente es una instantánea. Pon la fecha en el archivo y, cuando descubras que algo ha cambiado, edita el archivo en lugar de añadir un documento más nuevo al lado. Dos documentos sin fecha que no coinciden son peores que uno que está marcado honestamente con una fecha.
Mantén las instrucciones y el conocimiento en lugares diferentes
CLAUDE.md es para reglas y punteros, se carga en cada sesión y debe ser breve. La investigación es conocimiento: larga, relevante de forma ocasional y costosa de cargar incondicionalmente. Mezclarlos te da un archivo inflado por el que pagas en cada solicitud y en el que, aun así, no cabe todo.
Conclusión
Perplexity exporta un hilo a la vez a PDF, Markdown o DOCX, y no hay una exportación masiva oficial de Spaces; Claude Code no tiene importador. Así que el camino honesto es manual y corto: haz un triaje del Space buscando conclusiones en lugar de búsquedas, expórtalas como Markdown con sus citas, condensa cada grupo en un documento con fecha que comience con la decisión y apunta CLAUDE.md a la carpeta en lugar de pegarlo directamente.
La elección que vale la pena tomar deliberadamente es dónde vive el conocimiento después. En el repositorio, sirve a este proyecto en esta herramienta. En una capa de memoria que ambas partes leen, sirve también para el próximo proyecto y la próxima herramienta, lo cual importa más de lo que parece, porque la investigación te llevó una semana y la elección de la herramienta cambiará antes de que lo haga la investigación.