Lo que OpenAI añadió el 20 de octubre
El cambio se aplica a GPT-5.6 y modelos posteriores en la API de Responses. El tiempo de vida se establece con prompt_cache_options.ttl, que acepta dos valores: 30m, el predeterminado, y 12h. La guía de OpenAI describe cuándo usar cada uno. El tiempo de vida de 30 minutos es para "Conversaciones y pasos de agentes que reutilizan el contexto con frecuencia". El tiempo de vida de 12 horas es para "Instrucciones estables o material de referencia reutilizado en intervalos más largos".
Puedes establecer el tiempo de vida para una solicitud completa o para puntos de interrupción individuales. La guía dice: "El ttl a nivel de solicitud se aplica al punto de interrupción implícito y a los puntos de interrupción explícitos sin su propio ttl". Un punto de interrupción explícito puede anularlo con prompt_cache_breakpoint.ttl.
La escritura en la caché de 12 horas se factura a una tarifa de escritura más alta que la caché de 30 minutos, y las lecturas cuestan lo mismo para ambas. El propio consejo de OpenAI es comparar: "Compara la tarifa de escritura de 12 horas más alta con el costo de reescribir el prefijo después de que expire la cobertura de 30 minutos". Consulta las tarifas actuales en la página de precios de OpenAI para el modelo que utilices.
Los modelos más antiguos conservan su propia configuración. La guía dice que estas nuevas configuraciones "no cambian el parámetro prompt_cache_retention de los modelos anteriores", y la lista de verificación de migración dice "Reemplaza prompt_cache_retention con prompt_cache_options.ttl" cuando migres a GPT-5.6 o posterior.
Qué almacena realmente la caché de prompts
La caché no almacena tu prompt como texto. OpenAI explica que el modelo calcula estados intermedios de clave-valor mientras procesa la entrada, y "El almacenamiento en caché de prompts preserva ese estado para un prefijo reutilizable: los tokens sin cambios al principio de un prompt". Añade: "La caché de prompts almacena tensores de clave-valor (KV), no los tokens en sí".
De esto se derivan dos consecuencias. Primero, la coincidencia debe ser exacta. "La reutilización de la caché requiere que coincida todo el prefijo renderizado". Segundo, la caché no cambia lo que el modelo hace con ese prefijo. En las preguntas frecuentes: "El almacenamiento en caché de prompts no cambia la forma en que el modelo genera los tokens de salida".
En otras palabras, el almacenamiento en caché tiene que ver con el costo y la latencia de la entrada que el modelo ya ha procesado. No es un lugar para almacenar información y no hace que el modelo recuerde nada.
Lo que promete el tiempo de vida de 12 horas y lo que deja abierto
El número en el nombre es un mínimo. La guía de OpenAI dice: "OpenAI puede retener las entradas más tiempo que el mínimo solicitado", y que la configuración "no establece un plazo de eliminación ni cambia la política máxima de retención de datos". La página de controles de datos hace la misma distinción: prompt_cache_options.ttl "controla el tiempo de vida mínimo de la caché, no este período máximo de retención del estado de la aplicación".
El mínimo se refiere a la elegibilidad de precios, no a una garantía de reutilización. "El tiempo de vida mínimo rige la elegibilidad para los precios de lectura de caché. No garantiza que cada solicitud reutilice los tensores KV almacenados o tenga una latencia menor". La ubicación también importa: "Los estados almacenados en caché residen en máquinas individuales" y "Una solicitud puede reutilizar un prefijo almacenado en caché solo si llega a una máquina que contiene una entrada coincidente que no ha expirado". La caché también tiene un alcance limitado: "Las cachés no se comparten entre organizaciones y no se pueden reutilizar a través de límites de procesamiento regional".
Las lecturas no reinician el reloj de 12 horas. "Una lectura de 30 minutos actualiza la cobertura a al menos 30 minutos después de esa lectura". Cuando esa lectura cae en una entrada con cobertura de 12 horas, la entrada conserva la expiración que sea posterior, y la guía dice: "No reinicia un reloj de 12 horas ni incurre en otro cargo por escritura".
Actualizar cuesta una nueva escritura. "Actualizar una cobertura válida de 30 minutos a 12 horas cobra una nueva escritura de 12 horas para esos tokens, sin crédito por la escritura anterior". Si cambias un prefijo muy utilizado de 30 minutos a 12 horas, la primera solicitud después del cambio paga por una nueva escritura.
Y no hay control manual sobre la expiración. "La limpieza manual de la caché no está disponible actualmente".
Qué contenido pertenece detrás de un punto de interrupción de 12 horas
La recomendación de OpenAI es dividir un prompt según la frecuencia con la que cambian sus partes. Mantén el material que reutilizas a lo largo del día al principio del prompt con un punto de interrupción de 12 horas. Dale al contexto de la sesión que cambia con más frecuencia el valor predeterminado de 30 minutos. Deja la pregunta actual después del último punto de interrupción, donde en el modo de solo explícitos "no incurre en un cargo por escritura en caché".
Un prefijo de larga duración es el lugar para:
- Instrucciones del desarrollador que definen el rol y las reglas del agente.
- Definiciones de herramientas, que la guía recomienda mantener estables: "Preserva las definiciones de herramientas, el orden y los esquemas".
- Material de referencia que el agente consulta en la mayoría de las solicitudes.
Lo que no pertenece allí es cualquier cosa que cambie por usuario o por día. La guía es específica: "Si las instrucciones del desarrollador o el material compartido contienen marcas de tiempo, contenido específico del usuario u otro contenido dinámico, colócalos al final en lugar de al principio, o muévelos a mensajes de conversación posteriores".
Dos detalles estructurales son importantes. "Las instructions de nivel superior no pueden contener un punto de interrupción explícito", por lo que las instrucciones reutilizables que desees marcar van "en un bloque input_text dentro de un mensaje de desarrollador". And el prefijo debe superar el tamaño mínimo. Para GPT-5.6 y posteriores, la guía lo establece en 1,024 tokens de entrada visibles.
Qué rompe un prefijo de larga duración
Debido a que la coincidencia debe ser exacta desde el primer token, cualquier cambio antes de un punto de interrupción invalida lo que le sigue. "Si el contenido o una configuración relevante cambian antes de un punto de interrupción, el prefijo después de ese cambio no puede coincidir con la entrada de caché existente".
Eso incluye configuraciones, no solo texto. La guía enumera model, tools, parallel_tool_calls, text.format, reasoning.effort, text.verbosity y context_management como configuraciones que pueden afectar al prefijo almacenado en caché. En los modelos GPT-6, sugiere agregar un elemento configuration_update para cambiar el esfuerzo de razonamiento en lugar de cambiar la configuración a nivel de solicitud.
Reescribir el historial también lo rompe. El consejo de la guía es "Agregar nuevos mensajes en lugar de reescribir turnos anteriores", porque "La resumización, compactación o truncamiento de contexto pueden cambiar el prefijo y reiniciar la reutilización de la caché". Nuestra guía sobre la compactación por inactividad de Claude Code muestra la misma compensación desde el otro lado, donde la compactación ocurre justo antes de que expire la caché.
Incluso extender un mensaje puede hacerlo. Si una solicitud termina con un mensaje que contiene un bloque de contenido y la siguiente solicitud agrega algo a ese mismo mensaje, el antiguo punto final ahora está dentro de un mensaje en lugar de al final, y sin un punto de interrupción explícito allí, el prefijo guardado en ese punto no se reutiliza.
Lo que tu agente sigue olvidando
Esta es la parte que una caché más larga no cambia. La guía de estado de conversación de OpenAI comienza desde lo básico: "Aunque cada solicitud de generación de texto es independiente y sin estado, aún puedes implementar conversaciones de varios turnos proporcionando mensajes adicionales como parámetros en tu solicitud de generación de texto". Lo que sea que el modelo deba saber tiene que llegar a él a través de la solicitud, ya sea que lo envíes tú mismo o hagas referencia al estado de conversación almacenado.
La caché hace que un prefijo estable sea más barato de enviar de nuevo. No le añade nada. Si tu agente se entera el martes por la mañana de que un cliente ha cambiado de plan, ese dato no está en el prefijo de 12 horas que escribiste a las 8 a.m. Para incluirlo, debes agregarlo a la conversación o editar el prefijo. Editar el prefijo es un cambio antes del punto de interrupción, lo que significa una nueva escritura.
Por lo tanto, la pregunta de diseño cambia. Un prefijo de larga duración premia el mantener estable el material compartido durante horas. Un agente que mejora a lo largo del día acumula datos que pertenecen a otro lugar: en la conversación, en un almacenamiento del que recupera tu aplicación, o en una lista curada que actualizas e incorporas periódicamente de nuevo al prefijo. Para las conversaciones, la API de Conversations de OpenAI es una opción. La guía dice que puede "persistir el estado de la conversación como un objeto de larga duración con su propio identificador duradero". Para datos duraderos a través de las conversaciones, necesitas una fuente que tú mantengas. Nuestra comparación de APIs de memoria de IA para desarrolladores cubre las opciones.
Lo que la gente intenta primero
Poner todo en el prefijo de 12 horas. El nombre del usuario, la fecha de hoy, el ticket más reciente. Cada uno de ellos cambia, y cada cambio antes del punto de interrupción obliga a una nueva escritura.
Asumir que 12 horas significa exactamente 12 horas. Es un mínimo para la elegibilidad de precios. Las entradas pueden vivir más tiempo, y una solicitud aún puede fallar si no llega a una máquina con la entrada.
Esperar que las lecturas extiendan la ventana de 12 horas. Una lectura extiende la cobertura a al menos 30 minutos después de la lectura, y no reinicia el reloj de 12 horas.
Tratar la caché como la memoria del agente. La caché contiene el estado procesado de un prefijo que envías. No contiene datos propios y no cambia nada sobre la salida.
Cambiar la configuración sin medir. La escritura de 12 horas cuesta más. Si vale la pena o no depende de qué tan a menudo se reutilice el prefijo y qué tan largos sean los intervalos.
La solución: Divide el prompt según la frecuencia con la que cambia, dale solo 12 horas a la parte estable y mantén los datos en una fuente que tú controles
Paso 1: Clasifica tu prompt en estable, de sesión y actual
Toma una solicitud real de tu agente y marca cada parte:
- Estable: instrucciones, definiciones de herramientas y material de referencia que son idénticos para todos los usuarios y se mantienen así durante horas.
- Sesión: contexto para la conversación o tarea actual que se reutiliza durante los próximos minutos.
- Actual: la nueva pregunta o el resultado de la herramienta en esta solicitud.
Cualquier cosa con una marca de tiempo, un identificador de usuario o datos por solicitud se mueve fuera de la parte estable. Si la parte estable cae por debajo del tamaño mínimo almacenable en caché, la guía sugiere "acortarla o expandirla con instrucciones, ejemplos o material de referencia útiles y estables" y medir el resultado.
Paso 2: Coloca los puntos de interrupción y mide el resultado
Coloca la parte estable primero, dentro de un mensaje de desarrollador, con un punto de interrupción explícito establecido en 12h. Coloca el contexto de la sesión después con el valor predeterminado de 30 minutos. Deja la entrada actual después del último punto de interrupción. En GPT-5.6 y posteriores, una solicitud puede crear hasta cuatro escrituras en caché, por lo que tienes espacio para unas cuantas capas.
Luego mide. El objeto de uso reporta cached_tokens y cache_write_tokens, y para estos modelos cache_write_tokens_details divide las escrituras en ttl_30m_tokens y ttl_12h_tokens. Observa con qué frecuencia se escribe el prefijo de 12 horas. Si se reescribe varias veces al día, verifica si algo en él está cambiando.
Paso 3: Mantén los datos que aprende tu agente en una fuente que tú controles
Decide a dónde va el nuevo conocimiento. El contexto de corta duración se queda en la conversación. Los datos que deben sobrevivir a una conversación, como el plan de un cliente, una decisión que tomó un equipo o una corrección que hizo un usuario, van a un almacenamiento que tú cures.
En un horario que se adapte a tu patrón de reutilización, incorpora los datos que cada solicitud necesita en el prefijo estable. Eso hace que la reescritura sea un evento deliberado en lugar de algo provocado por cada nuevo detalle. Recupera el resto por solicitud y colócalo después de los puntos de interrupción.
Configuración de esto en MemoryLake
Una caché de 12 horas funciona mejor cuando la parte estable de tu prompt cambia según tu horario, no el de tu agente. Eso significa que los datos en los que confía tu agente necesitan un hogar independiente tanto de la caché como de cualquier conversación individual.
MemoryLake es una capa de memoria para mantener esos datos en una lista que tú controlas, disponible para los asistentes que conectes, como Codex, Claude Code y ChatGPT.
Tú mismo escribes las entradas, con tus propias palabras. No se lee, escribe ni elimina nada de la caché de prompts de OpenAI, de tus conversaciones de API, de tus respuestas almacenadas ni del almacenamiento de ningún proveedor. Excluye secretos y datos personales que tus políticas no permitan fuera de tus sistemas.
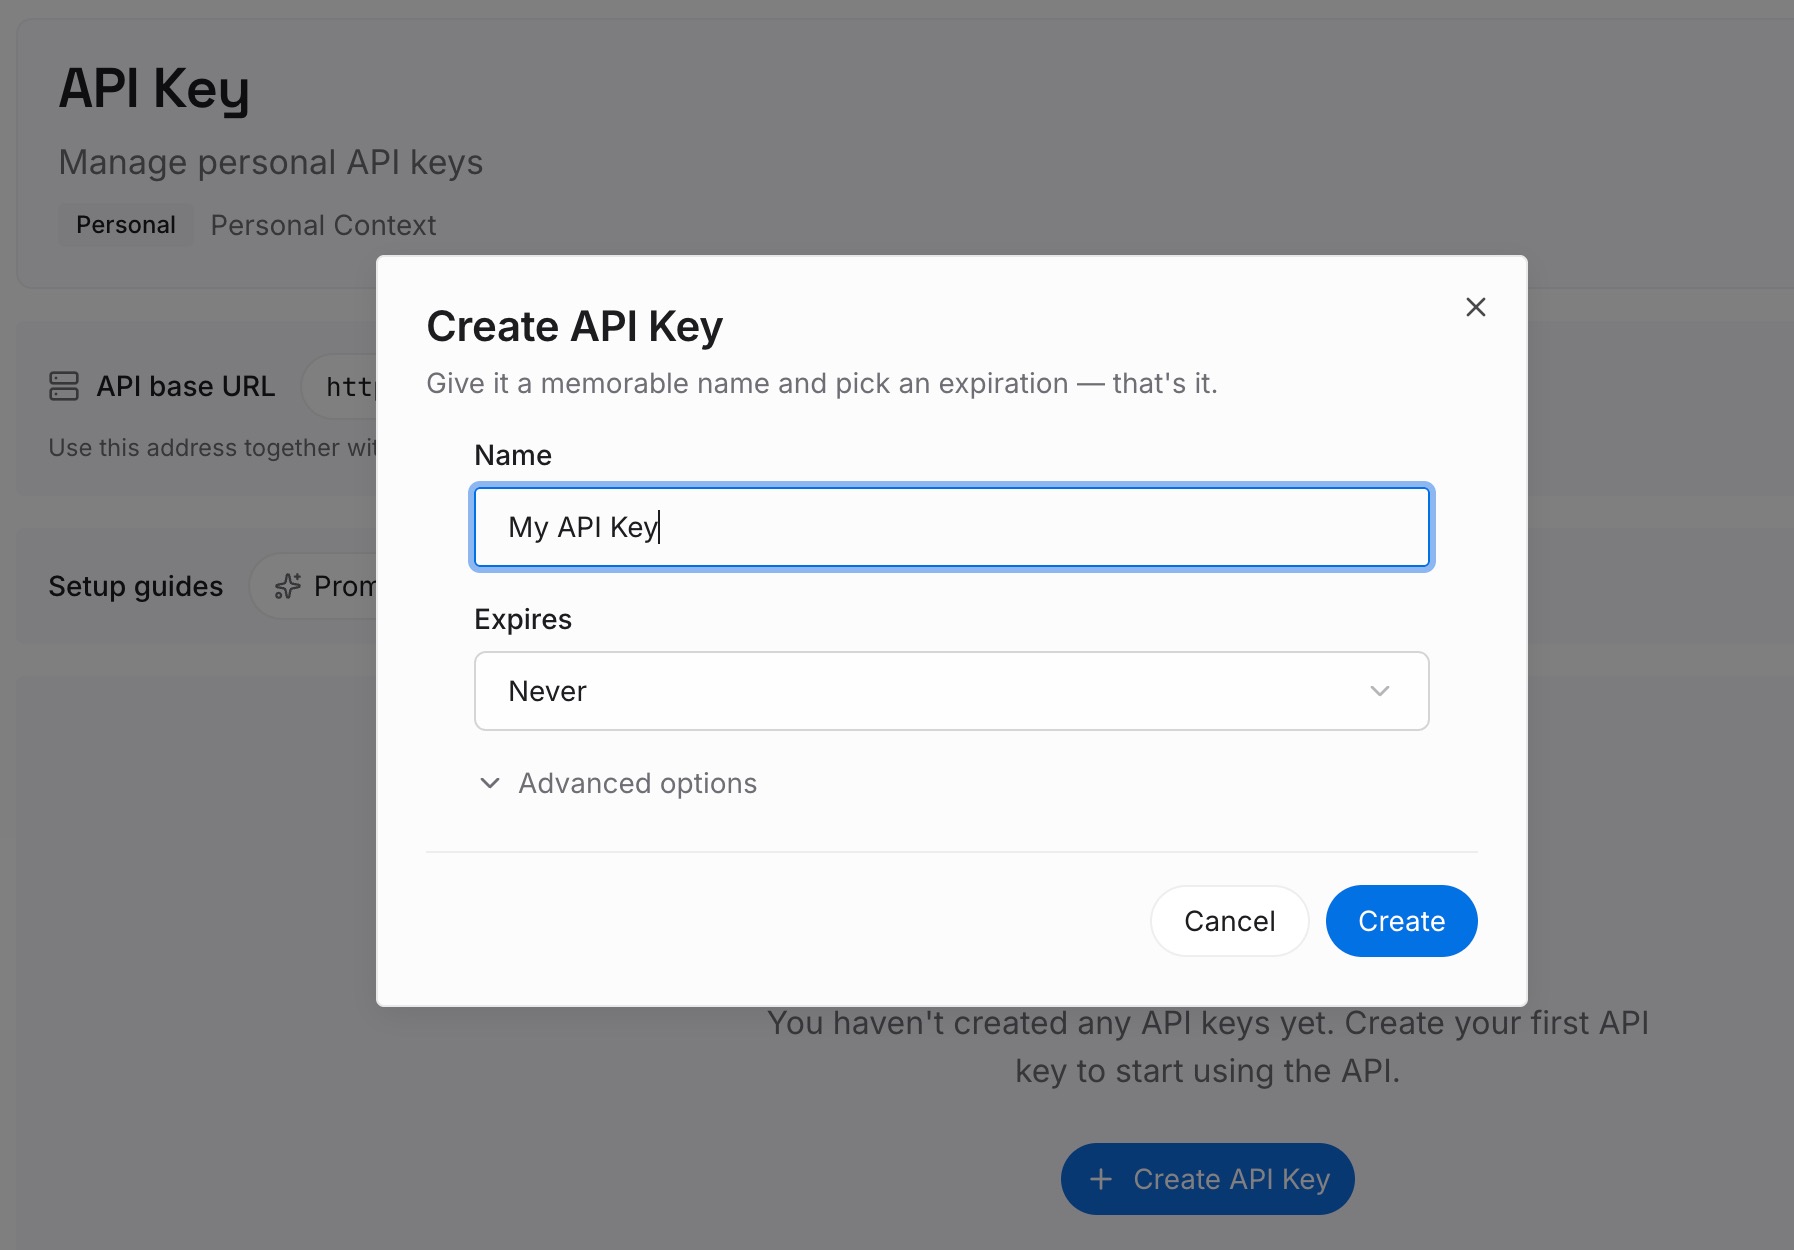
Paso 1: Crea una clave de API
Inicia sesión y genera una clave desde el panel de control. La clave pertenece a tu espacio de trabajo de MemoryLake y es independiente de tus claves de API de OpenAI.
Paso 2: Sube tus primeras memorias
Comienza con los datos que clasificaste en el Paso 3 de la solución: las decisiones, correcciones y puntos de referencia que tu agente debe conocer a través de las conversaciones. Un punto por entrada, con fecha, para que puedas ver qué cambió desde la última reconstrucción del prefijo.
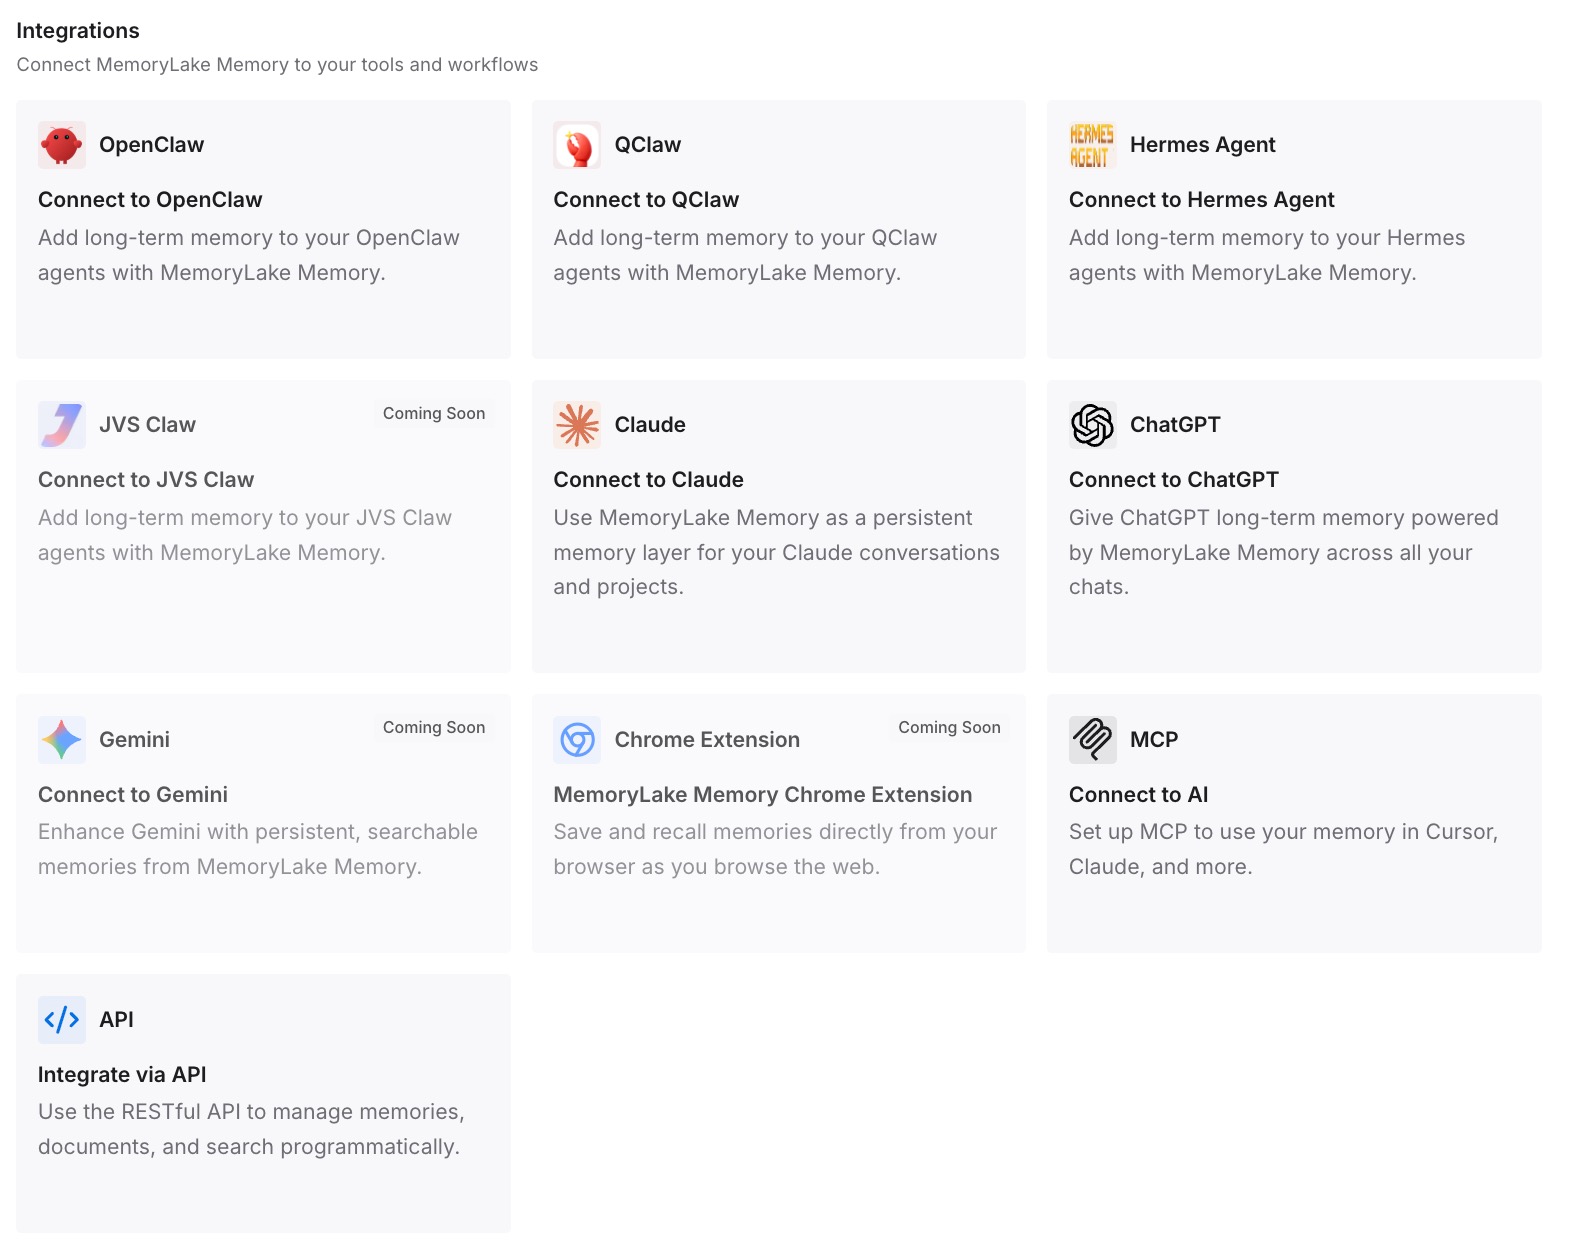
Paso 3: Conecta tu IA y agentes
Conecta los asistentes y agentes de programación que utilices. Cuando llegue el momento de reconstruir el prefijo estable, trabajarás a partir de una sola lista en lugar de tener que reconstruirla a partir de conversaciones antiguas.
Qué cambia esto en la práctica
La primera diferencia es que el prefijo de 12 horas se mantiene estable. Al haber extraído los datos por usuario y por día, solo cambia cuando lo reconstruyes, y el recuento de escrituras en el objeto de uso lo demuestra.
La segunda es que el nuevo conocimiento tiene un destino claro. Va a la conversación o a tu lista mantenida, no a una edición del prefijo almacenado en caché a mitad del día.
La tercera es que la decisión de costos se vuelve medible. Puedes comparar las escrituras de 12 horas y de 30 minutos con tráfico real en lugar de adivinar. Para la compensación más amplia entre recortar prompts y mantener el contexto, nuestra guía sobre por qué los prompts más cortos por sí solos no son suficientes cubre las otras opciones.
Buenas prácticas para el almacenamiento en caché de prompts de 12 horas
Usa 12 horas solo para contenido que sea idéntico durante horas. Instrucciones, herramientas y material de referencia compartido.
Mantén las marcas de tiempo y los datos de usuario fuera del prefijo estable. Muévelos al final o a mensajes posteriores.
Agrega en lugar de reescribir. La compactación y el truncamiento cambian el prefijo.
Coloca las instrucciones reutilizables en un mensaje de desarrollador. Las instructions de nivel superior no pueden contener un punto de interrupción explícito.
Lee el desglose de escrituras. ttl_12h_tokens muestra con qué frecuencia se está reescribiendo el prefijo de larga duración.
Reconstruye el prefijo de forma programada. Incorpora nuevos datos de manera deliberada, no uno por uno.
Mantén los datos duraderos fuera de la caché. Nuestra guía sobre cuánta memoria darle a un agente de IA cubre qué conservar y qué dejar fuera.
Conclusión
El almacenamiento en caché de prompts de 12 horas de OpenAI permite a los agentes reutilizar instrucciones estables, herramientas y material de referencia en intervalos más largos a la tarifa de entrada almacenada en caché. La documentación es cuidadosa con sus límites: las 12 horas son un mínimo para la elegibilidad de precios, no un plazo de eliminación ni una garantía de reutilización, las lecturas no reinician el reloj de 12 horas y cualquier cambio antes de un punto de interrupción rompe la coincidencia.
La caché tampoco almacena conocimiento. Cada solicitud aún debe llevar lo que el modelo debe saber. Divide tu prompt según la frecuencia con la que cambia, dale solo 12 horas a la parte estable y mantén los datos que aprende tu agente en una fuente que tú controles e incorpóralos según tu propio horario.