
Lo que OpenAI realmente publicó
Comencemos con qué es Habitat y quién lee de él. OpenAI lo describe como «la plataforma de almacenamiento en línea que creamos para que los productos de OpenAI puedan acceder de manera rápida y confiable a la información necesaria», y comienza nombrando los tipos de solicitudes que atiende: «Cada producto de OpenAI depende de un acceso rápido y confiable a los datos, ya sea que alguien esté iniciando sesión, verificando su configuración de Codex o iniciando una nueva conversación en ChatGPT. Cada una de esas acciones puede requerir muchas búsquedas de datos independientes antes de que el producto pueda responder».
La escala se expone claramente. Habitat «ahora maneja más de 70 millones de solicitudes por segundo, dando soporte a productos utilizados por más de 1000 millones de personas cada semana, en casi 40 regiones geográficas», y «hoy en día, es un sistema distribuido complejo que sirve más de 500 petabytes de datos».
Luego viene la decisión de diseño que importa aquí, y OpenAI la etiqueta como una decisión en lugar de una limitación:
«En lugar de permitir que los clientes construyan consultas SQL arbitrarias que podrían resultar en grandes escaneos de tablas o uniones (joins) entre muchas tablas, Habitat expone una API NoSQL simple. La falta de una API potente es un compromiso (tradeoff) explícito en el diseño de Habitat».
El razonamiento tiene que ver con la predictibilidad. «Nuestro objetivo es optimizar para solicitudes simples, predecibles y de trabajo constante. En nuestra experiencia, estos sistemas son sustancialmente más fáciles de escalar y difíciles de errar o usar mal. Las solicitudes con una ramificación (fanout) impredecible son operativamente peligrosas: complican el aislamiento, el equilibrio de carga e introducen picos de latencia que son difíciles de escalar tanto para el servicio como para sus clientes».
El modelo de datos se deriva de eso. «Habitat expone una API NoSQL modelada en torno a tipos de objetos y aristas (edges) definidos por el cliente, inspirada en TAO. Los clientes definen previamente los objetos y las aristas y cómo se relacionan entre sí, pero no el contenido de cada tipo». OpenAI nombra su inspiración aquí, lo cual vale la pena notar: este es un patrón muy conocido, no algo inventado para ahorrar costos.
Y luego la frase que la cobertura omitió:
«Particionamos este grafo de modo que cada objeto y sus aristas correspondientes se ubiquen en la misma partición a nivel de almacenamiento, pero no hacemos ningún esfuerzo concertado a nivel de base de datos para ubicar juntos los objetos y los objetos remotos a los que apuntan sus aristas. El resultado es que el modelo se particiona fácilmente para lograr escalabilidad horizontal, pero los recorridos de grafos son ineficientes, ya que cualquier salto particular entre objetos puede requerir la recuperación de dos cuentas de Azure Cosmos DB completamente diferentes almacenadas en regiones distintas».
Lee eso dos veces. Un objeto y sus aristas directas están juntos. Las cosas a las que esas aristas apuntan pueden estar al otro lado del mundo. OpenAI añade el límite explícitamente: «Las relaciones resultantes se asemejan a un grafo, pero Habitat en sí no admite consultas típicas de recorrido de grafos fuera de la consulta de aristas directas de un objeto en particular».
Cualquier cosa más complicada se traslada por completo fuera de la ruta en tiempo real: «Para los clientes con necesidades de consulta más complejas, proporcionamos una vista secundaria fuera de línea de Habitat expuesta a través de Rockset». Los cambios se transmiten mediante captura de datos modificados (change data capture), cada equipo ejecuta su propia instancia, y OpenAI es claro sobre el porqué: «Este diseño aísla nuestro almacenamiento en línea de las cargas de trabajo analíticas y de búsqueda con un alto volumen de lectura».
Lo que esto cambia y lo que no
No cambia nada sobre cómo se comporta ChatGPT hoy en día. Este es un artículo de ingeniería sobre una capa de infraestructura, no un anuncio de producto, y OpenAI no afirma lo contrario.
Tampoco te dice dónde viven los datos de ninguna función en particular. El artículo nombra a ChatGPT, la API, Codex y los servicios internos como clientes de Habitat, y da como ejemplo de solicitud «iniciar una nueva conversación en ChatGPT». No publica un esquema para ninguna función de producto, y este artículo no va a inventar uno.
Lo que sí cambia es la calidad de la suposición que puedes hacer. Antes de este artículo, el «¿por qué mi asistente recuerda datos individuales pero nunca parece conectarlos?» era mera especulación. Ahora existe una razón arquitectónica documentada de por qué conectar cosas es la operación costosa en la capa de almacenamiento, declarada por las personas que la construyeron: las búsquedas de un solo objeto con sus aristas directas son el caso barato y de trabajo constante, y los saltos entre objetos son el caso que puede cruzar regiones.
La brecha descrita en por qué el contexto largo no es memoria suele plantearse como un problema del modelo. Aquí tenemos la misma forma un nivel más abajo, en la capa de almacenamiento, publicada por un proveedor sobre su propio sistema.
Hay una frase más que vale la pena recordar, porque explica toda la filosofía de diseño en pocas palabras: «Cuando la solicitud promedio de un usuario resulta en cientos de llamadas a la base de datos, la llamada más lenta es la que el usuario siente».
Lo que la gente concluirá de esto, y no debería
Que OpenAI escatimó recursos en el almacenamiento. El artículo argumenta lo contrario, detalladamente y con razones. Limitar la API es lo que hace que un sistema a esta escala sea predecible; OpenAI califica las consultas ilimitadas como «operativamente peligrosas» y describe el desequilibrio de costos directamente: «es barato y fácil escribir consultas SQL que son costosas y difíciles de ejecutar». Una plataforma que se niega a permitir que un equipo de producto escriba una consulta que tumbe la base de datos para mil millones de personas es una plataforma que está haciendo su trabajo.
Que esto es exclusivo de OpenAI. No lo es. OpenAI nombra a TAO como inspiración, que es un diseño publicado por una empresa diferente a una escala distinta, y el compromiso que codifica (ubicar un objeto junto con sus aristas, aceptando que los saltos remotos son costosos) es la forma estándar de hacer que un almacén con forma de grafo se particione horizontalmente. Cualquiera que opere un almacén de datos en línea muy grande se enfrenta a la misma aritmética.
Que una copia fuera de línea te lo soluciona. La vía de escape de Habitat es real y OpenAI es honesto al admitir que cuesta algo: «Este aprovisionamiento de Rockset introduce fricción adicional para nuestros clientes», y cada equipo es «responsable de escalar su propia instancia de Rockset». Esa es una opción de ingeniería interna con un responsable y un presupuesto. No es una función de cara al usuario, y nada en el artículo sugiere que lo sea.
Que la solución es una ventana de contexto más larga. El costo de recorrido y la longitud del contexto son problemas distintos. Una ventana más grande cambia la cantidad de información que se le puede mostrar a un modelo en una sola solicitud; no cambia qué búsquedas la capa de almacenamiento considera baratas. La versión de recuperación de esta confusión se aborda en por qué RAG no es memoria: encontrar un documento no es lo mismo que sostener una conclusión.
La solución: mantén las conexiones en un lugar cuyo único trabajo sean las conexiones
Si las búsquedas de un solo objeto son el caso barato en todas partes, entonces la estrategia duradera es dejar de esperar que la conexión se derive bajo demanda y comenzar a registrarla como su propio objeto.
Paso 1: Separa los hechos de las relaciones entre ellos
Revisa aquello en lo que realmente confías que un asistente sepa y clasifícalo en dos montones.
El primer montón son los hechos. «Facturamos por días completos». «La base de datos de pruebas (staging) está en Frankfurt». «Priya es la responsable de la integración de pagos». Cada uno de ellos es independiente y es algo barato de recuperar para cualquier sistema.
El segundo montón son las relaciones, y aquí es donde se esconde el valor. «Facturamos por días completos porque el sistema financiero rechaza los parciales». «La base de datos de pruebas está en Frankfurt debido a la cláusula de residencia de datos en el contrato de 2025». «Priya es la responsable de pagos desde la reorganización, razón por la cual el manual de procedimientos antiguo nombra a otra persona».
El segundo montón es el que nadie escribe, porque cada mitad parece obvia en su momento. También es el montón que más cuesta reconstruir, y el que cualquier almacén optimizado para búsquedas individuales de trabajo constante tendrá más dificultades para reensamblar por ti.
Paso 2: Escribe la relación como una frase, no como dos entradas y una esperanza
Una relación escrita como una sola frase es un único objeto. Una relación que se deja implícita entre dos entradas es un recorrido, y acabas de leer la descripción de un proveedor sobre por qué los recorridos son el camino costoso.
Así que escribe «Frankfurt, debido a la cláusula de residencia de 2025» como un solo registro, no como un registro de ubicación y un registro de contrato que esperas que algo una por ti. Esta es una pequeña disciplina con una gran recompensa, y es el mismo instinto que genera un buen mensaje de commit: el diff es el hecho, el mensaje es la relación.
Cuando dos registros entren genuinamente en conflicto, dilo en el propio registro en lugar de dejar que la contradicción sea descubierta más tarde. El modo de fallo cuando nadie hace eso es el tema de detección de conflictos de memoria.
Paso 3: Dale a esa capa una dirección a la que cada asistente pueda acceder
Una relación que escribiste en la memoria de un producto es una relación que el siguiente producto no puede ver. Mantén la capa fuera del almacén de cualquier proveedor individual para que cambiar de herramientas, o usar tres a la vez, no signifique tener que escribir tus relaciones de nuevo desde cero. La versión práctica de ese problema se analiza en una sola memoria para ChatGPT, Claude y Gemini.
Configuración de esto en MemoryLake
MemoryLake está diseñado para el segundo montón. Tú mismo escribes las decisiones y las razones detrás de ellas, con tus propias palabras, y cada asistente que conectas lee el mismo conjunto. No se extrae nada del almacén de ningún proveedor; la capa contiene lo que tú pones en ella.
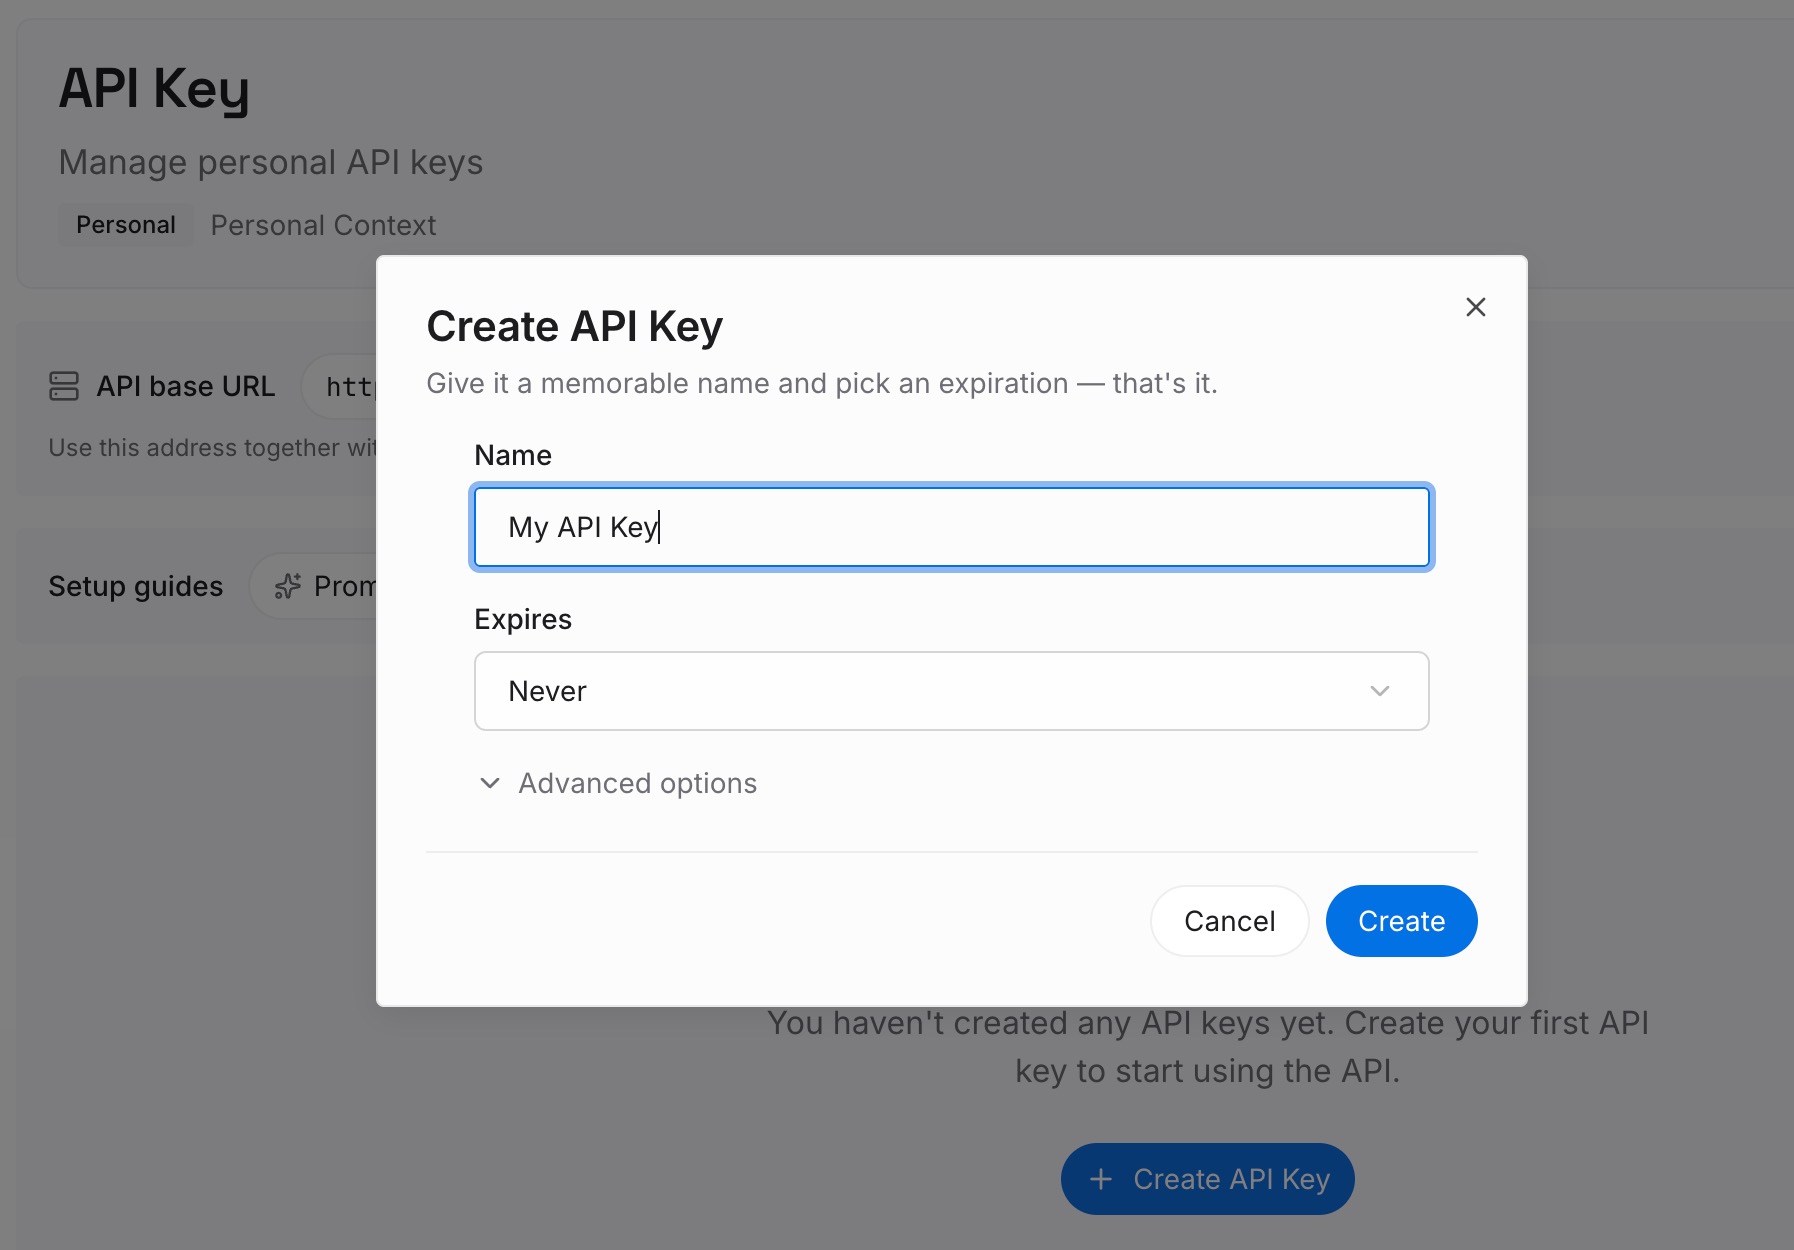
Paso 1: Crea una clave API
Inicia sesión, abre la configuración de tu espacio de trabajo y genera una clave API. Esta es la credencial que tus asistentes utilizan para leer la misma capa, así que créala una vez y mantenla accesible desde cada herramienta en la que trabajes.
Paso 2: Sube tus primeras memorias
Comienza con las relaciones, no con los hechos. Toma las cinco cosas que has explicado dos veces este trimestre y escribe cada una como una sola frase que contenga tanto la regla como la razón. Añade las restricciones que son costosas de redescubrir y baratas de registrar.
Paso 3: Conecta tu IA y agentes
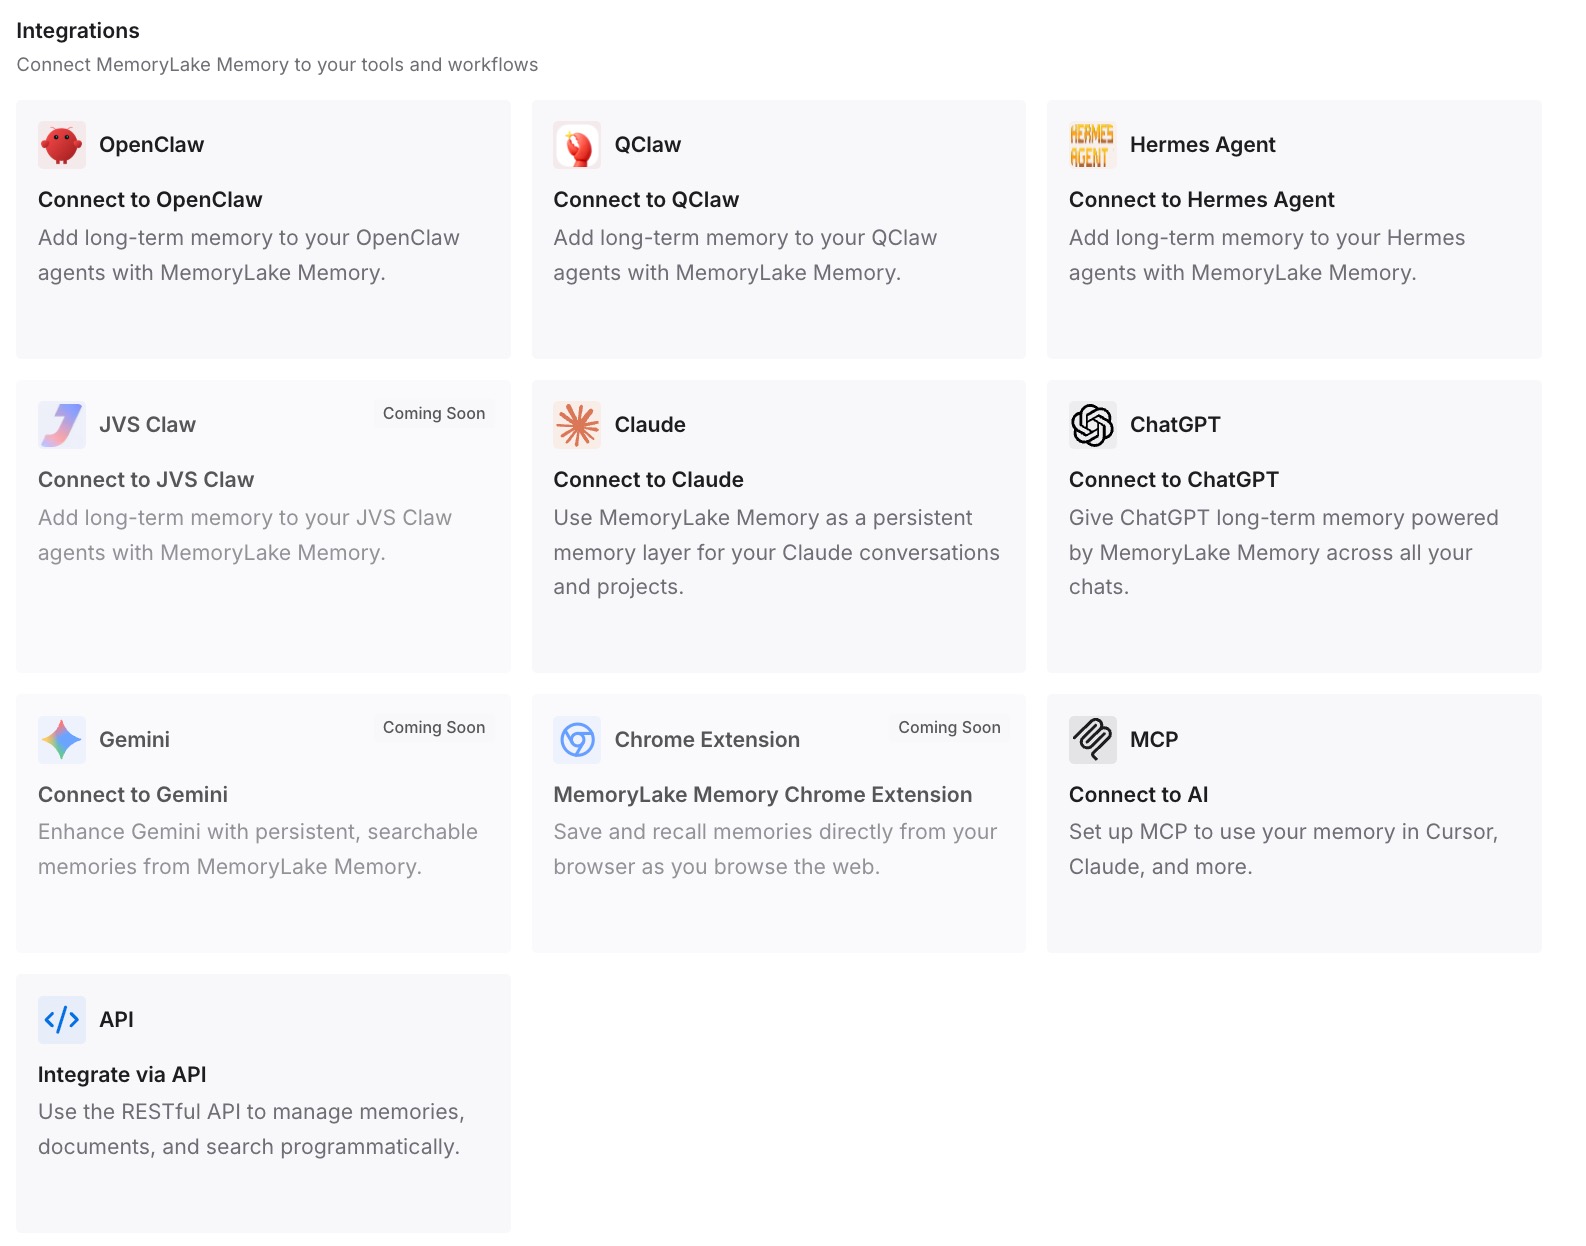
Conecta ChatGPT y cualquier otra cosa que uses. El mismo razonamiento llega a cada uno, por lo que una nueva conversación comienza a partir de lo que ya concluiste en lugar de empezar desde cero.
Lo que esto cambia en la práctica
La primera diferencia es que dejas de molestarte por la razón equivocada. Un asistente que recuerda tu ciudad pero no por qué te mudaste allí no está siendo descuidado; está siendo atendido por una capa que es muy buena recuperando un objeto y sus aristas directas. Saber esto convierte una queja vaga en un hábito específico.
La segunda es que tus notas se vuelven más cortas y útiles. Un registro que lleva su propia razón no necesita un segundo registro para tener sentido, lo que significa que sobrevive al ser leído de forma aislada, exactamente el patrón de acceso para el cual estos sistemas están optimizados.
La tercera aparece cuando las cosas cambian con el tiempo. Una vez que se escriben las razones, puedes volver atrás y comprobar si todavía se mantienen, lo cual es una actividad muy diferente a volver a leer una lista de hechos y preguntarse cuáles están obsoletos. Ese hábito de revisión es el tema de auditar lo que tu IA recuerda.
La cuarta es la continuidad entre sesiones. Esa sensación de desánimo descrita en cuando ChatGPT pierde el contexto entre sesiones es principalmente el costo de las relaciones que nunca se registraron en ningún lado, siendo deducidas de nuevo por ti, a mano, cada vez.
Buenas prácticas para trabajar con una memoria basada en búsquedas
Escribe un registro por decisión, con la razón dentro de él. Dos registros que solo tienen sentido juntos son un recorrido esperando a fallar.
Prefiere lo específico sobre lo estructurado. Una frase redactada de forma sencilla supera a un esquema inteligente que no vas a mantener. Los sistemas que realizan la recuperación son buenos devolviendo lo que almacenaste; no son buenos infiriendo lo que querías conectar.
Registra lo que cambió, no solo lo que es cierto. «Dejamos de usar la cuenta compartida en marzo» es más útil que «tenemos nuestra propia cuenta», porque le dice al lector de qué material antiguo desconfiar.
Vuelve a leer tus entradas más antiguas una vez al trimestre. Los hechos se deterioran silenciosamente. Las razones se deterioran ruidosamente y son más fáciles de identificar como incorrectas.
Mantén la capa fuera de cualquier producto individual. Los proveedores rediseñan su arquitectura. OpenAI acaba de publicar un artículo que describe un servicio que pasó de ser una biblioteca a un servicio y luego a una reescritura, y prometió una segunda parte sobre la capa de almacenamiento. Tu razonamiento no debería tener que preocuparse por eso.
No trates un artículo de ingeniería como una especificación de producto. Este describe una plataforma y sus compromisos. No documenta el modelo de datos de ninguna función, y asumir uno a partir de él sería mera especulación.
Conclusión
El artículo sobre Habitat es una buena pieza de redacción de ingeniería, y la parte que vale la pena conservar no es la reescritura. Es un proveedor que afirma, sin que se lo pregunten, que su almacenamiento en línea está diseñado deliberadamente para búsquedas simples, predecibles y de trabajo constante, que las relaciones entre objetos pueden terminar en diferentes regiones y que cualquier cosa que requiera un recorrido real va a una copia fuera de línea con su propio responsable.
Toma eso al pie de la letra y la conclusión para el resto de nosotros es mundana y liberadora. Deja de esperar que la conexión entre dos cosas que dijiste se vuelva a descubrir bajo demanda. Escribe la conexión una vez, como su propia frase sencilla, en un lugar donde cada herramienta que uses pueda leerla. Eso convierte la operación costosa en una barata, que es el mismo truco que utilizó el equipo de plataforma de OpenAI, un nivel más arriba.