
Por qué las tareas en la nube se inician sin tu contexto local
Comencemos con lo que es un entorno. "Un entorno de nube es la configuración reutilizable que usan las tareas: repositorios, dependencias, herramientas y ajustes de acceso". Codex inspecciona tus repositorios, instala lo que necesitan, prueba la configuración contigo y tú la publicas. "Cada nueva tarea obtiene su propio espacio de trabajo aislado a partir del entorno publicado".
La descripción general de los entornos de OpenAI establece el límite en dos frases: "Una tarea en la nube utiliza los archivos y servicios disponibles en su entorno de nube. Los archivos locales de tu ordenador, los procesos en ejecución, los inicios de sesión en el navegador y el acceso VPN no se transfieren automáticamente a ella".
Ahora veamos dónde guarda Codex local su contexto.
Instrucciones. "Codex lee los archivos AGENTS.md antes de realizar cualquier trabajo". Construye una cadena: un archivo global en tu directorio de inicio de Codex, que "por defecto es ~/.codex", luego los archivos desde la raíz del proyecto hasta tu directorio de trabajo. Los archivos del repositorio forman parte de la descarga (checkout). El archivo global reside en tu máquina.
Skills. Codex lee las skills de las ubicaciones del repositorio, del usuario, del administrador y del sistema. Las skills del repositorio residen en .agents/skills en el repositorio. Las skills del usuario residen en $HOME/.agents/skills. La página de entornos de nube es específica sobre cuáles ve una tarea: "Las skills almacenadas en tu repositorio están disponibles en las tareas en la nube. Las skills personales de tu ordenador local no se sincronizan con los entornos de nube".
Memorias. "ChatGPT web utiliza la memoria de ChatGPT, mientras que los clientes locales de Codex utilizan un almacenamiento y controles de memoria local independientes". Ese almacenamiento está en el disco: "Codex almacena las memorias en tu directorio de inicio de Codex". Cómo funciona localmente se detalla en activar las memorias locales de Codex.
Al juntar todo esto, una tarea en la nube obtiene de forma fiable lo que se ha confirmado (committed) en el repositorio y lo que configuraste en el entorno. Las directrices de tu carpeta de inicio, las skills personales y cualquier cosa que haya captado tu memoria local están vinculadas a tu ordenador.
Dos detalles más definen lo que recuerda una tarea. "Cada tarea en la nube tiene sus propios archivos de trabajo. Los cambios de archivos en una tarea no actualizan el entorno reutilizable". Y el estado guardado tiene una duración: "Por defecto, el estado guardado de la VM de una tarea se puede recuperar hasta siete días después de la última vez que iniciaste un turno o reanudaste la tarea".
Nada de esto es inusual. Las sesiones en la nube de Claude Code trazan una línea similar, como se describe en lo que tu configuración local deja atrás en el entorno de nube de Claude Code. Los agentes en la nube comienzan a partir de lo que se comparte, por diseño.
Qué intenta la gente en su lugar
Ejecutar la primera tarea en la nube y corregir lo que sale mal. Esto acaba funcionando, pero cada corrección reside en los archivos de trabajo de una sola tarea. Los cambios de archivos en una tarea no actualizan el entorno, por lo que la siguiente tarea comenzará desde el mismo lugar.
Confiar en las memorias de Codex. Las memorias son útiles localmente, y la propia guía de OpenAI es clara sobre su función: "Mantén las directrices obligatorias del equipo en AGENTS.md o en la documentación registrada. Trata las memorias como una capa de recuerdo útil, no como la única fuente para las reglas que siempre deben aplicarse".
Mantener las reglas clave en el AGENTS.md global. El archivo de tu carpeta de inicio es un buen lugar para los acuerdos de trabajo personales. Las reglas de las que depende todo el equipo pertenecen al repositorio, donde cada tarea, ya sea local o en la nube, las lee.
Poner todo en la conversación de configuración. El entorno registra un script de instalación y una skill de inicio, que contienen cómo preparar y ejecutar el proyecto. Son el lugar equivocado para decisiones de arquitectura o convenciones de código.
Asumir que la configuración de nube heredada se transfiere. OpenAI señala que "Codex Cloud (Legacy) sigue admitiendo Code Review y las integraciones de Linear y GitHub", y planea retirarlo. Los entornos para el nuevo Codex Cloud se crean por separado.
La solución: pon el contexto del proyecto en el repositorio y en el entorno, luego compruébalo en una tarea
Paso 1: Haz un inventario de lo que tu configuración local de Codex ofrece a cada tarea
Antes de crear el entorno, haz una lista de aquello de lo que dependen tus tareas locales. Cuatro lugares cubren la mayor parte.
Tu AGENTS.md global en ~/.codex. Léelo y marca cada línea como personal (cómo te gusta trabajar) o de proyecto (cómo funciona esta base de código).
Tus skills personales en $HOME/.agents/skills. Anota cuáles utilizas en este proyecto.
Tus memorias locales. Codex las guarda como archivos en ~/.codex/memories/, y OpenAI sugiere tratarlas como estado generado. Puedes leerlas para ver en qué se ha estado apoyando Codex y para encontrar datos del proyecto que nunca llegaron a guardarse en un archivo.
Tus propios hábitos. Piensa en el primer mensaje que sueles enviar al iniciar una tarea: qué comandos ejecutar, qué carpeta evitar, qué servicio iniciar primero. Eso también es contexto.
El resultado es una breve lista del contexto del proyecto que actualmente solo reside en tu máquina. Si Codex ha estado ignorando archivos del repositorio que pensabas que leía, por qué Codex omite las reglas de AGENTS.md cubre las causas más comunes.
Paso 2: Mueve el contexto del proyecto al repositorio y la configuración al entorno
Ahora dale a cada elemento un hogar compartido.
Las convenciones del proyecto van al AGENTS.md del repositorio. Codex concatena los archivos desde la raíz hacia abajo, así que coloca las reglas de todo el repositorio en la raíz y las reglas específicas de un área en carpetas anidadas. Mantén las preferencias personales en tu archivo global; son sobre ti, no sobre el proyecto.
Las skills del proyecto van a .agents/skills en el repositorio. Si una skill que usas en este proyecto reside en tu carpeta de inicio, cópiala en el repositorio para que las tareas en la nube y tus compañeros de equipo la tengan. Si antes usabas prompts personalizados, convertir prompts personalizados de Codex en skills cubre ese proceso.
Los datos duraderos del proyecto de tus memorias locales van a la documentación registrada en el repositorio. Escríbelos como declaraciones sencillas con el motivo adjunto y enlázalos desde AGENTS.md si cada tarea los necesita.
Luego crea el entorno. En la web o en la aplicación de escritorio, elige "Work in" (Trabajar en), luego "Cloud" (Nube), luego "Create environment" (Crear entorno) y selecciona tus repositorios. Deja que Codex los inspeccione y prepare la configuración. Usa la conversación para decirle qué cubrían tus hábitos del Paso 1: qué servicios iniciar, qué versiones fijar. Codex registra esto en un script de instalación y en una skill de inicio, siendo esta última "instrucciones para iniciar servicios y comprobar que están listos".
Maneja el acceso correctamente. Usa variables de entorno para los valores que los programas leen directamente, secretos de red para las credenciales enviadas a servicios HTTPS específicos y el cofre personal (Personal vault) para los valores que proporciona cada persona. Para entornos compartidos, OpenAI señala que compartir transmite los requisitos: "Compartir el entorno comparte estos requisitos, no tus credenciales personales".
Decide a qué puede acceder la tarea. Si tu flujo de trabajo necesita registros de paquetes o API internas, añádelos en la configuración de acceso a internet del entorno y pruébalos durante la preparación. OpenAI señala un límite que vale la pena recordar: "Permitir un destino no proporciona credenciales ni otorga permisos en ese servicio". Lo mismo ocurre con los repositorios y las aplicaciones conectadas: "El acceso al repositorio y las conexiones personales dependen de la cuenta que ejecuta la tarea". Un colega que use tu entorno compartido trabajará con su propio acceso, no con el tuyo.
Revisa el informe de configuración y luego publica. Recuerda la diferencia: "Guardar almacena la configuración; algunos ajustes se aplican al entorno activo de inmediato. Publicar captura el sistema de archivos preparado para nuevas tareas".
Paso 3: Inicia una tarea y pregunta qué ha cargado
Inicia una nueva tarea desde el entorno publicado y hazle algunas preguntas directas antes de darle trabajo real. Pídele que enumere las fuentes de instrucciones que ha cargado. Pregúntale qué skills están disponibles. Pídele que ejecute el comando de prueba del proyecto. La propia documentación de AGENTS.md de OpenAI utiliza esta misma comprobación localmente, pidiendo a Codex que enumere las fuentes de instrucciones que ha cargado.
Compara las respuestas con tu lista del Paso 1. Cualquier cosa que falte sigue estando en tu máquina.
Luego usa el entorno para una tarea real y presta atención a las correcciones repetidas. Si te encuentras diciéndole lo mismo dos veces a las tareas en la nube, ese dato pertenece al repositorio o al entorno, no a un mensaje de seguimiento.
Por último, protege los resultados. "Confirma (commit) el trabajo importante o guarda el resultado que necesites. El estado guardado no reemplaza al control de código fuente". El estado de una tarea es recuperable por un tiempo limitado; un commit es permanente.
Configuración de esto en MemoryLake
La solución coloca las convenciones en el repositorio y la configuración en el entorno. Hay contextos que no encajan en ninguno de los dos: por qué la arquitectura tiene ese aspecto, decisiones tomadas en varios repositorios y lecciones que se aplican tanto si una tarea se ejecuta en Codex Cloud, en una sesión local o en otro agente por completo. MemoryLake es un lugar para mantener esa capa, fuera de cualquier máquina o entorno individual.
Tú mismo escribes las entradas, con tus propias palabras. No se lee, escribe ni elimina nada de tus memorias de Codex, tus entornos de nube, tus repositorios ni del almacenamiento de ningún proveedor.
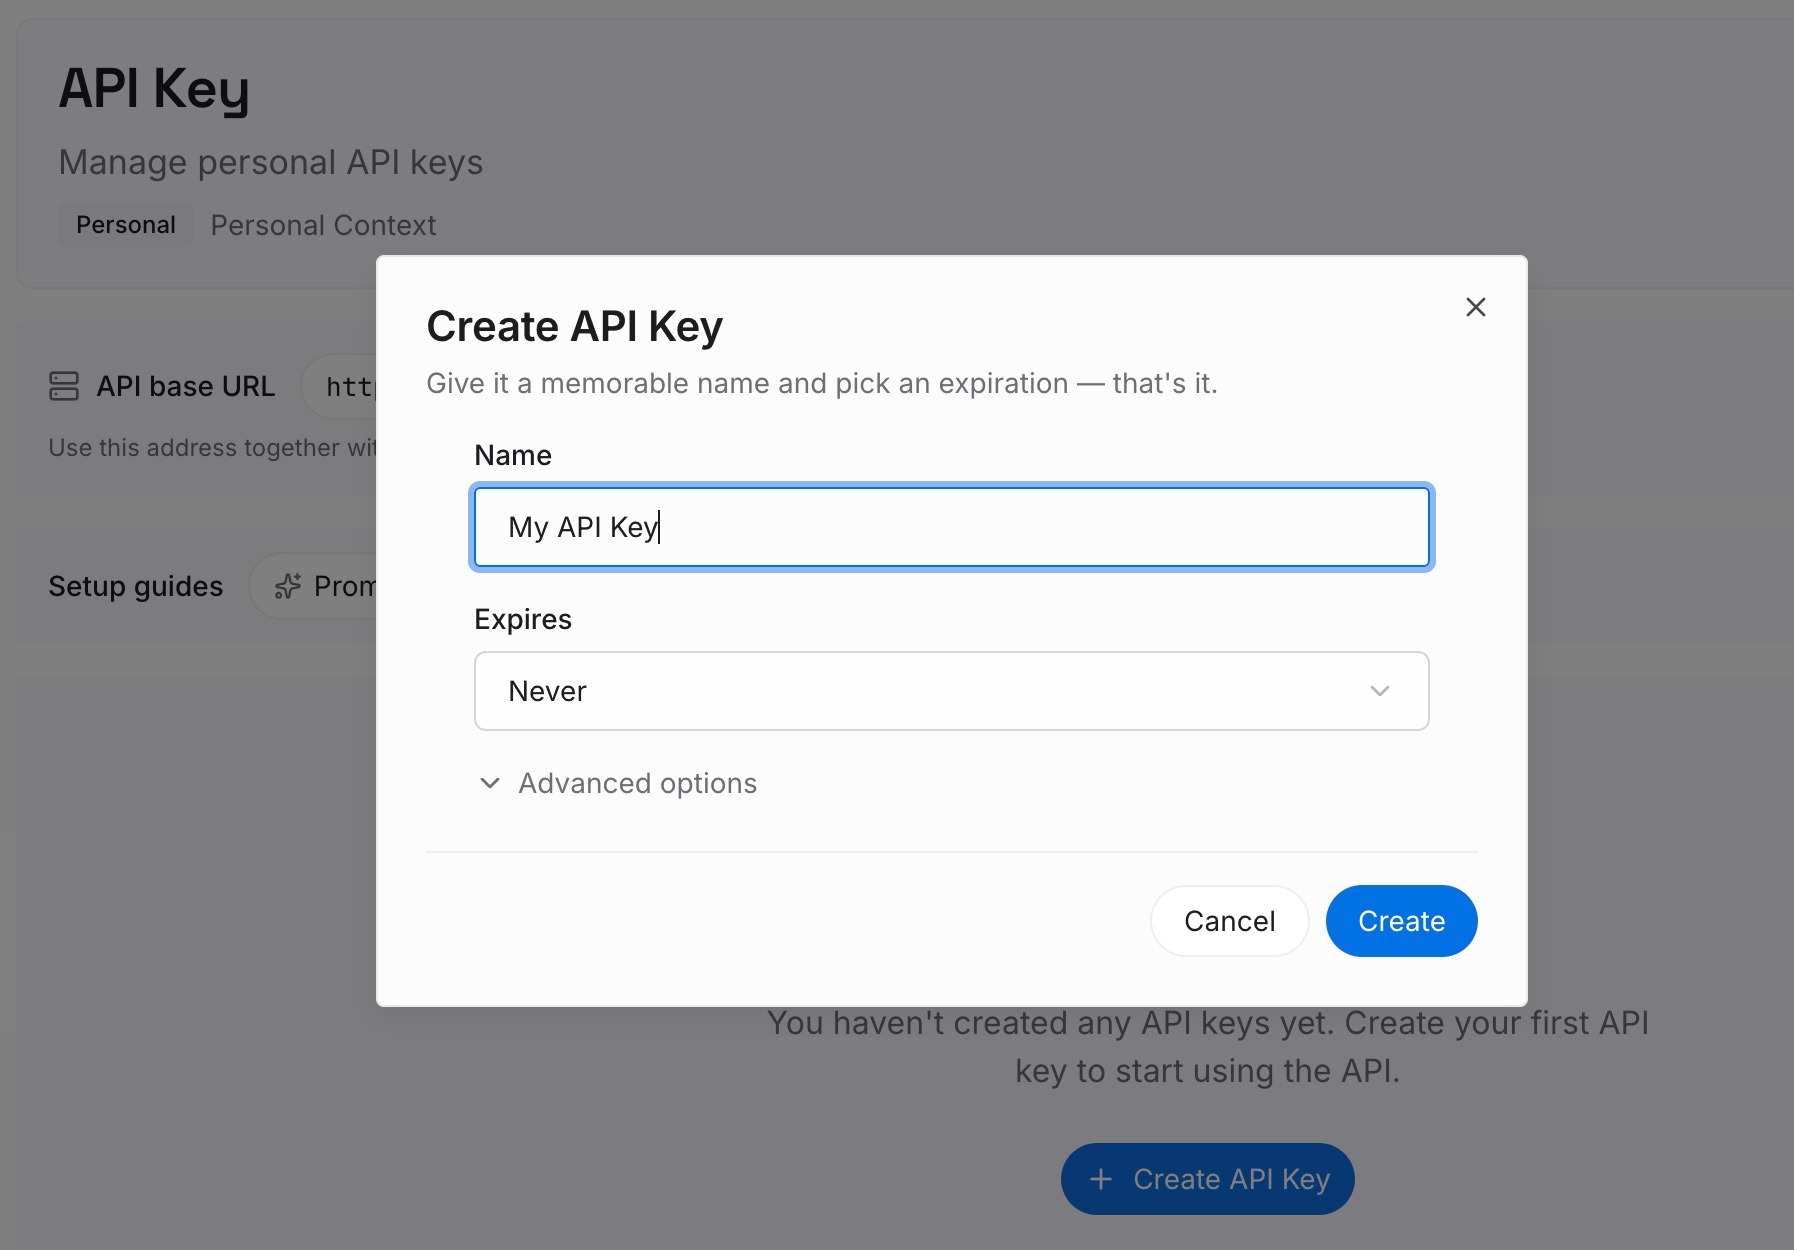
Paso 1: Crea una clave API
Inicia sesión y genera una clave desde el panel de control. Almacénala de la forma en que tu entorno espera las credenciales, para que se mantenga fuera de tu repositorio.
Paso 2: Sube tus primeras memorias
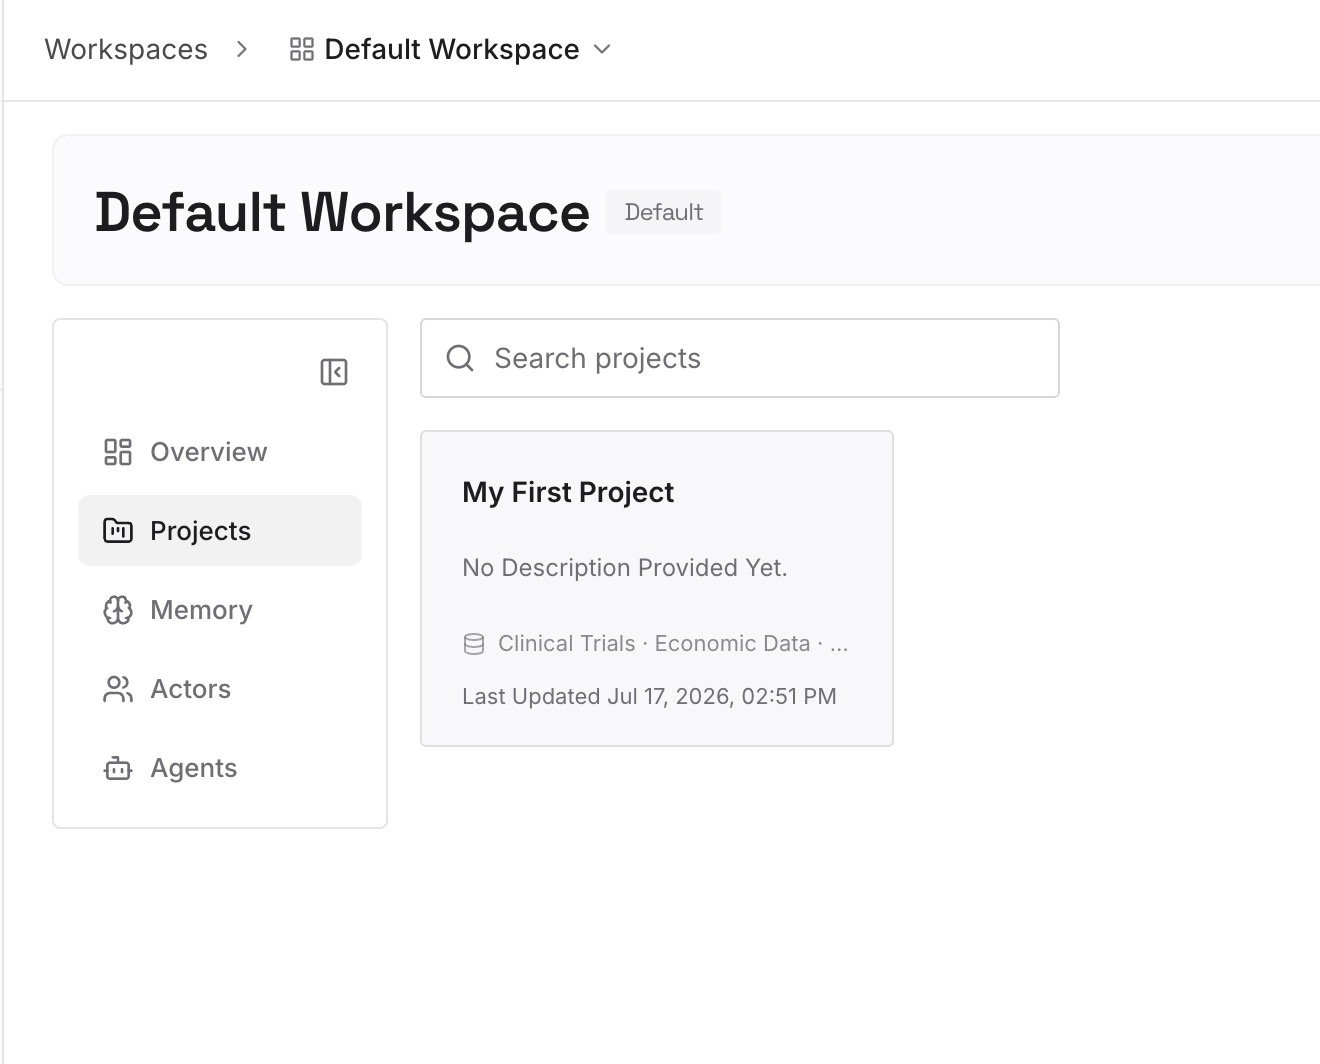
Comienza con los datos del proyecto del Paso 1 que se refieren a motivos en lugar de reglas: por qué se dividió un servicio, qué enfoque se abandonó, qué protege una restricción de dependencia. Una decisión por entrada, con fecha.
Paso 3: Conecta tu IA y tus agentes
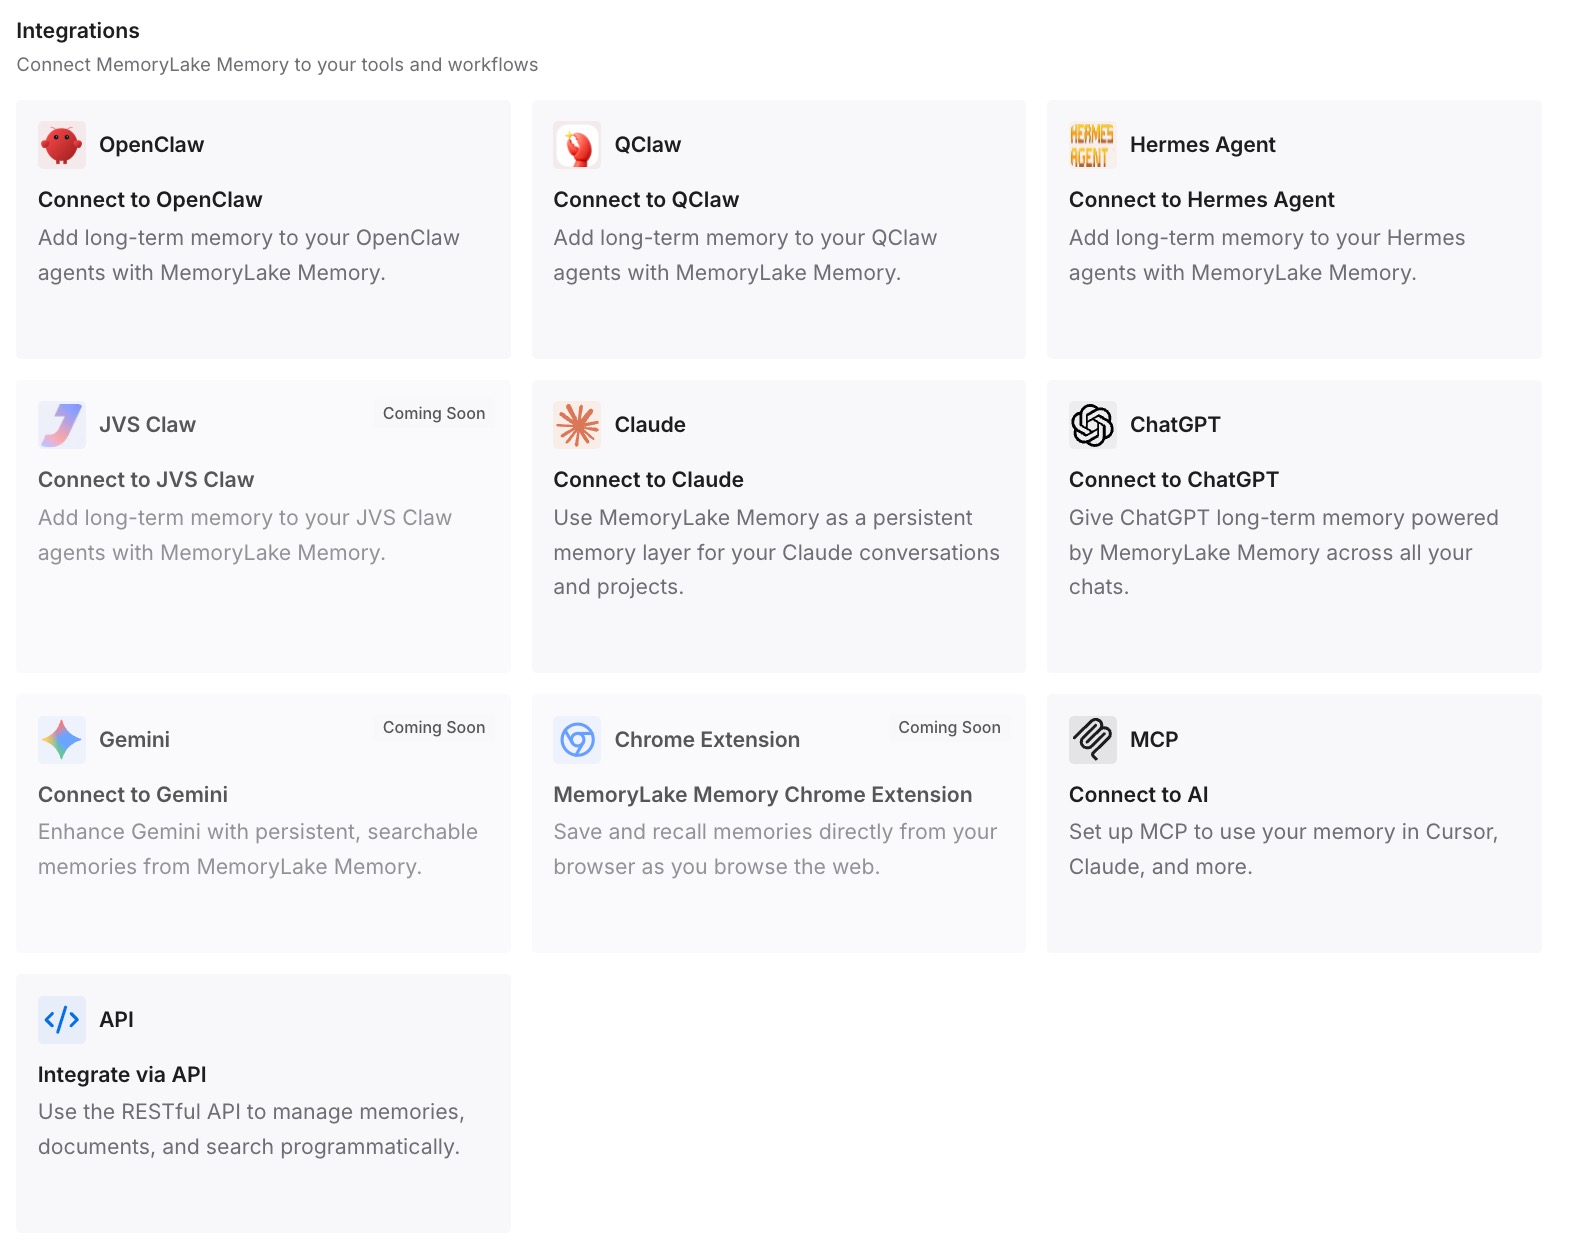
Conecta Codex y los demás agentes que utiliza tu equipo. El mismo contexto estará disponible tanto si una tarea se ejecuta localmente como en la nube.
Qué cambia esto en la práctica
La primera diferencia es que las tareas en la nube se comportan como las locales. Las directrices que necesitan están confirmadas (committed), por lo que el primer mensaje de cada tarea puede centrarse en el trabajo y no en la configuración.
La segunda es que los compañeros de equipo obtienen el mismo punto de partida. Un entorno compartido junto con instrucciones y skills a nivel de repositorio significa que la tarea de un colega comienza exactamente donde comienza la tuya.
La tercera es que la memoria local vuelve a ser una comodidad. Las reglas que siempre deben aplicarse residen en archivos, por lo que las memorias locales solo hacen que tus propias sesiones sean más fluidas. Para el problema más amplio, consulta por qué Codex olvida el contexto del proyecto.
La cuarta es que moverse entre plataformas deja de hacer que se pierda el contexto. ChatGPT Work, Codex local y Codex Cloud se ejecutan en lugares diferentes, un patrón que se trata en mantener el contexto entre la nube de ChatGPT Work y el entorno local. Cuando el contexto reside en archivos compartidos y en una capa de memoria compartida, la plataforma importa menos.
Buenas prácticas para entornos de nube de Codex
Confirma (commit) las reglas del equipo en el AGENTS.md del repositorio. Mantén el archivo global para las preferencias personales.
Mueve las skills del proyecto a .agents/skills. Las skills personales se quedan en tu ordenador.
Convierte las memorias locales en documentos. Los datos duraderos pertenecen a los archivos.
Describe el inicio en el entorno. Deja que Codex lo registre como un script de instalación y una skill de inicio.
Usa el lugar adecuado para cada secreto. Variables, secretos de red o el cofre personal (Personal vault).
Vuelve a publicar después de cambiar la configuración. Luego inicia una nueva tarea para usarla.
Comprueba cada nuevo entorno con una tarea corta. Pregúntale qué ha cargado antes de darle trabajo real. Para saber qué cargan realmente los agentes a través de las herramientas, consulta qué leen realmente los agentes de programación.
Conclusión
Los entornos de nube de Codex facilitan la ejecución de tareas de forma remota desde una configuración compartida y reutilizable. Una tarea comienza con lo que proporcionan el entorno y el repositorio. Tu AGENTS.md global, tus skills personales y tus memorias locales están vinculados a tu máquina, y OpenAI dice claramente que las skills personales no se sincronizan y los archivos locales no se transfieren.
Por lo tanto, mueve el contexto del proyecto a donde las tareas puedan leerlo. Coloca las convenciones en el AGENTS.md del repositorio, las skills en .agents/skills, los datos duraderos en documentos registrados y la configuración en el entorno. Luego, comprueba cada nuevo entorno preguntándole a una tarea qué ha cargado.
Mantén los motivos detrás de tu proyecto en una capa a la que todos los agentes puedan acceder, y la nube dejará de ser un lugar donde las tareas comiencen con menos información de la que tú tienes.