
Por qué un wiki.json puede reducir tu DeepWiki
Comienza con lo que hace el archivo. "Si se encuentra un archivo .devin/wiki.json en el directorio raíz de tu repositorio durante la generación de la wiki, utilizaremos las repo_notes y pages proporcionadas para dirigir la generación de la wiki. Ambos campos son obligatorios, y pages debe listar al menos una página".
Los dos campos realizan tareas diferentes. Cognition lo resume en una línea: "Las notas guían cómo se escribe cada página; pages determina qué páginas se crean". Las notas son contexto. Las páginas son el esquema.
Y el esquema es literal. La referencia de configuración dice que las páginas "se tratan como instrucciones explícitas: solo se generarán las páginas que definas en el JSON, ni más ni menos". La sección de resolución de problemas recalca este punto dos veces más, lo cual es una buena señal de la frecuencia con la que la gente comete este error. "La wiki genera solo las páginas que listes, por lo que cualquier carpeta sin una página no aparecerá". Y: "Recuerda: DeepWiki generará solo las páginas incluidas en este array, así que asegúrate de que todas las páginas estén presentes, no solo la página que falta".
Así que el movimiento más natural — "la wiki omitió nuestra carpeta testing/, agreguemos una configuración que la mencione" — reemplaza la wiki planificada automáticamente por una wiki con exactamente las páginas que escribiste.
También hay límites estrictos que debes planificar: "Máximo 30 páginas (80 para enterprise)", "Máximo 100 notas en total" entre las notas del repositorio y de las páginas, y "Máximo 10,000 caracteres por nota". Los títulos de las páginas "deben ser únicos y no estar vacíos". Un archivo sin páginas tampoco vuelve silenciosamente al plan automático: un wiki.json "que omita pages (o lo deje vacío) es rechazado".
Dos detalles más deciden qué refleja la wiki. Ramas: "Devin indexa la rama por defecto de cada repositorio", y el consejo de Cognition es "indexar las ramas en las que tu equipo desarrolla activamente". Esfuerzo: la generación de la wiki se ejecuta en uno de tres niveles de esfuerzo, y "Las organizaciones Enterprise siempre se ejecutan con un nivel de esfuerzo bajo; la configuración no es parametrizable para ellas".
Luego está la audiencia. DeepWiki no es solo algo que la gente navega. "Ask Devin utilizará la información de la Wiki para comprender mejor y encontrar el contexto relevante en tu base de código". Y a través del servidor MCP de DeepWiki, los agentes externos la leen con herramientas llamadas read_wiki_structure, read_wiki_contents y ask_question. Una página que no se genera es una página que ninguno de ellos puede leer.
Qué intenta la gente en su lugar
Agregar un wiki.json con solo la página que falta. Esta es la trampa mencionada anteriormente. Obtienes la página que querías y pierdes todas las páginas que no listaste.
Usar repo_notes para solicitar cobertura. Las notas definen cómo se escriben las páginas, no qué páginas existen. Una nota que diga "documentar la carpeta de scripts" no hace nada a menos que haya una página para ella en pages.
Dejar que la wiki automática permanezca y esperar que los agentes busquen en el código el resto. Los agentes pueden buscar en el código, pero la documentación generada de una carpeta es algo muy diferente a encontrar un archivo por su nombre. Lo que los agentes realmente cargan es un conjunto más estrecho de lo que la mayoría de los equipos asume, un patrón analizado en lo que los agentes de programación realmente leen.
Apuntar el servidor MCP a DeepWiki y asumir que los repositorios privados están cubiertos. El servidor MCP público se describe como "un servicio gratuito, remoto y que no requiere autenticación, el cual proporciona acceso a repositorios públicos". Para código privado, Cognition señala al servidor MCP de Devin con una clave API de Devin.
Copiar la configuración MCP de un cliente en otro. Cognition advierte esto explícitamente: "Devin Desktop utiliza serverUrl, mientras que la mayoría de los otros clientes utilizan el campo estándar url. El uso de un nombre de campo incorrecto hace que el servidor MCP sea ignorado silenciosamente".
La solución: Registra la wiki que tienes, luego dirígela con una lista completa de páginas
El objetivo es una wiki que cubra las carpetas que te importan, mantenga todo lo útil que el plan automático ya produjo y llegue a cada agente que dependa de ella.
Paso 1: Registra la estructura actual de la wiki antes de agregar una configuración
Antes de tocar nada, anota lo que contiene la wiki automática hoy. Abre la wiki en Devin o en deepwiki.com y copia el árbol de páginas: cada página de nivel superior y cada página secundaria.
Si usas un cliente MCP, puedes pedirle que llame a read_wiki_structure para el repositorio, que Cognition describe como una forma de "Obtener una lista de temas de documentación para un repositorio de GitHub". Guarda el resultado en un archivo con el que puedas comparar más tarde.
Luego marca cada página con una de tres etiquetas: mantener, fusionar o descartar. Mantén las páginas que la gente y los agentes utilizan. Fusiona las páginas delgadas que cubren código vecino. Descarta las páginas que documentan código generado o de terceros (vendored) que nadie necesita que se explique.
Finalmente, enumera lo que falta: las carpetas que el plan automático omitió, los temas transversales que nunca creó (cómo se comunican los servicios entre sí, cómo funciona el despliegue) y las áreas donde el resumen generado es demasiado superficial para ser útil.
Paso 2: Escribe el wiki.json con cada página que desees y coloca las prioridades en repo_notes
Ahora construye el archivo a partir de tu lista, no solo de la brecha.
Coloca cada página que quieras "mantener" y cada página que falte en pages, cada una con un title único y un purpose específico. La guía de Cognition es "Mencionar directorios, archivos o conceptos específicos en los que enfocarse" y "Proporcionar suficiente detalle para que el sistema entienda tu intención". Usa parent para reconstruir la jerarquía, comenzando "con páginas de descripción general de alto nivel".
Haz un recuento antes de confirmar. Si tu lista supera el límite de páginas, fusiona páginas relacionadas hasta que quepa, conservando las que los agentes y los nuevos compañeros de equipo abren con más frecuencia.
Usa repo_notes para dar énfasis y definir relaciones. Cognition recomienda notas que indiquen "qué partes de tu base de código son las más importantes" y "Explicar las relaciones entre diferentes partes de tu sistema". Conserva la clave repo_notes incluso cuando no tengas nada que agregar; la referencia dice que se debe "usar un array vacío ([])". Para pautas que se apliquen a una sola página, usa page_notes.
Luego sigue la secuencia documentada: "Confirma el archivo y regenera tu wiki".
Paso 3: Regenera, compara y verifica que los agentes la reciban
Compara la wiki regenerada con el árbol que guardaste en el Paso 1. Cada página que decidiste "mantener" debería seguir existiendo, las páginas fusionadas deberían leerse de manera coherente y las carpetas que faltaban ahora deberían tener sus páginas. Si algo desapareció, es porque se omitió en pages.
Verifica la rama. Si la wiki describe la rama por defecto pero tu equipo trabaja en otra, agrega esa rama a la indexación, como sugiere el consejo de Cognition.
Luego verifica los agentes. En cada cliente MCP que use tu equipo, confirma que la entrada del servidor use el campo que ese cliente espera — serverUrl para Devin Desktop, url para la mayoría de los demás — y que apunte al endpoint recomendado; Cognition señala que "Se recomienda el endpoint /mcp ya que SSE está en proceso de depreciación". Haz a cada cliente una pregunta cuya respuesta se encuentre en una de las nuevas páginas. Si el cliente responde utilizando la wiki, el direccionamiento ha llegado a tus agentes.
Vuelve a revisar el archivo cuando la base de código cambie de forma. Un nuevo servicio o un módulo retirado significa que la lista de páginas necesita edición, porque la wiki generará lo que dice el archivo, ni más ni menos.
Configuración en MemoryLake
Una DeepWiki dirigida explica qué es el código y cómo encaja. Se genera a partir del repositorio, por lo que describe la estructura en lugar de la historia: por qué se dividió un módulo, qué enfoque se intentó y se abandonó, qué acordó el equipo sobre una API. Ese contexto vive en la cabeza de las personas y en hilos dispersos. MemoryLake es un lugar para mantenerlo junto a la wiki, de modo que los agentes obtengan tanto el mapa como las razones detrás de él.
Tú mismo escribes las entradas, con tus propias palabras. No se lee, escribe ni elimina nada de tu DeepWiki, tu wiki.json, tus repositorios ni del almacenamiento de ningún proveedor.
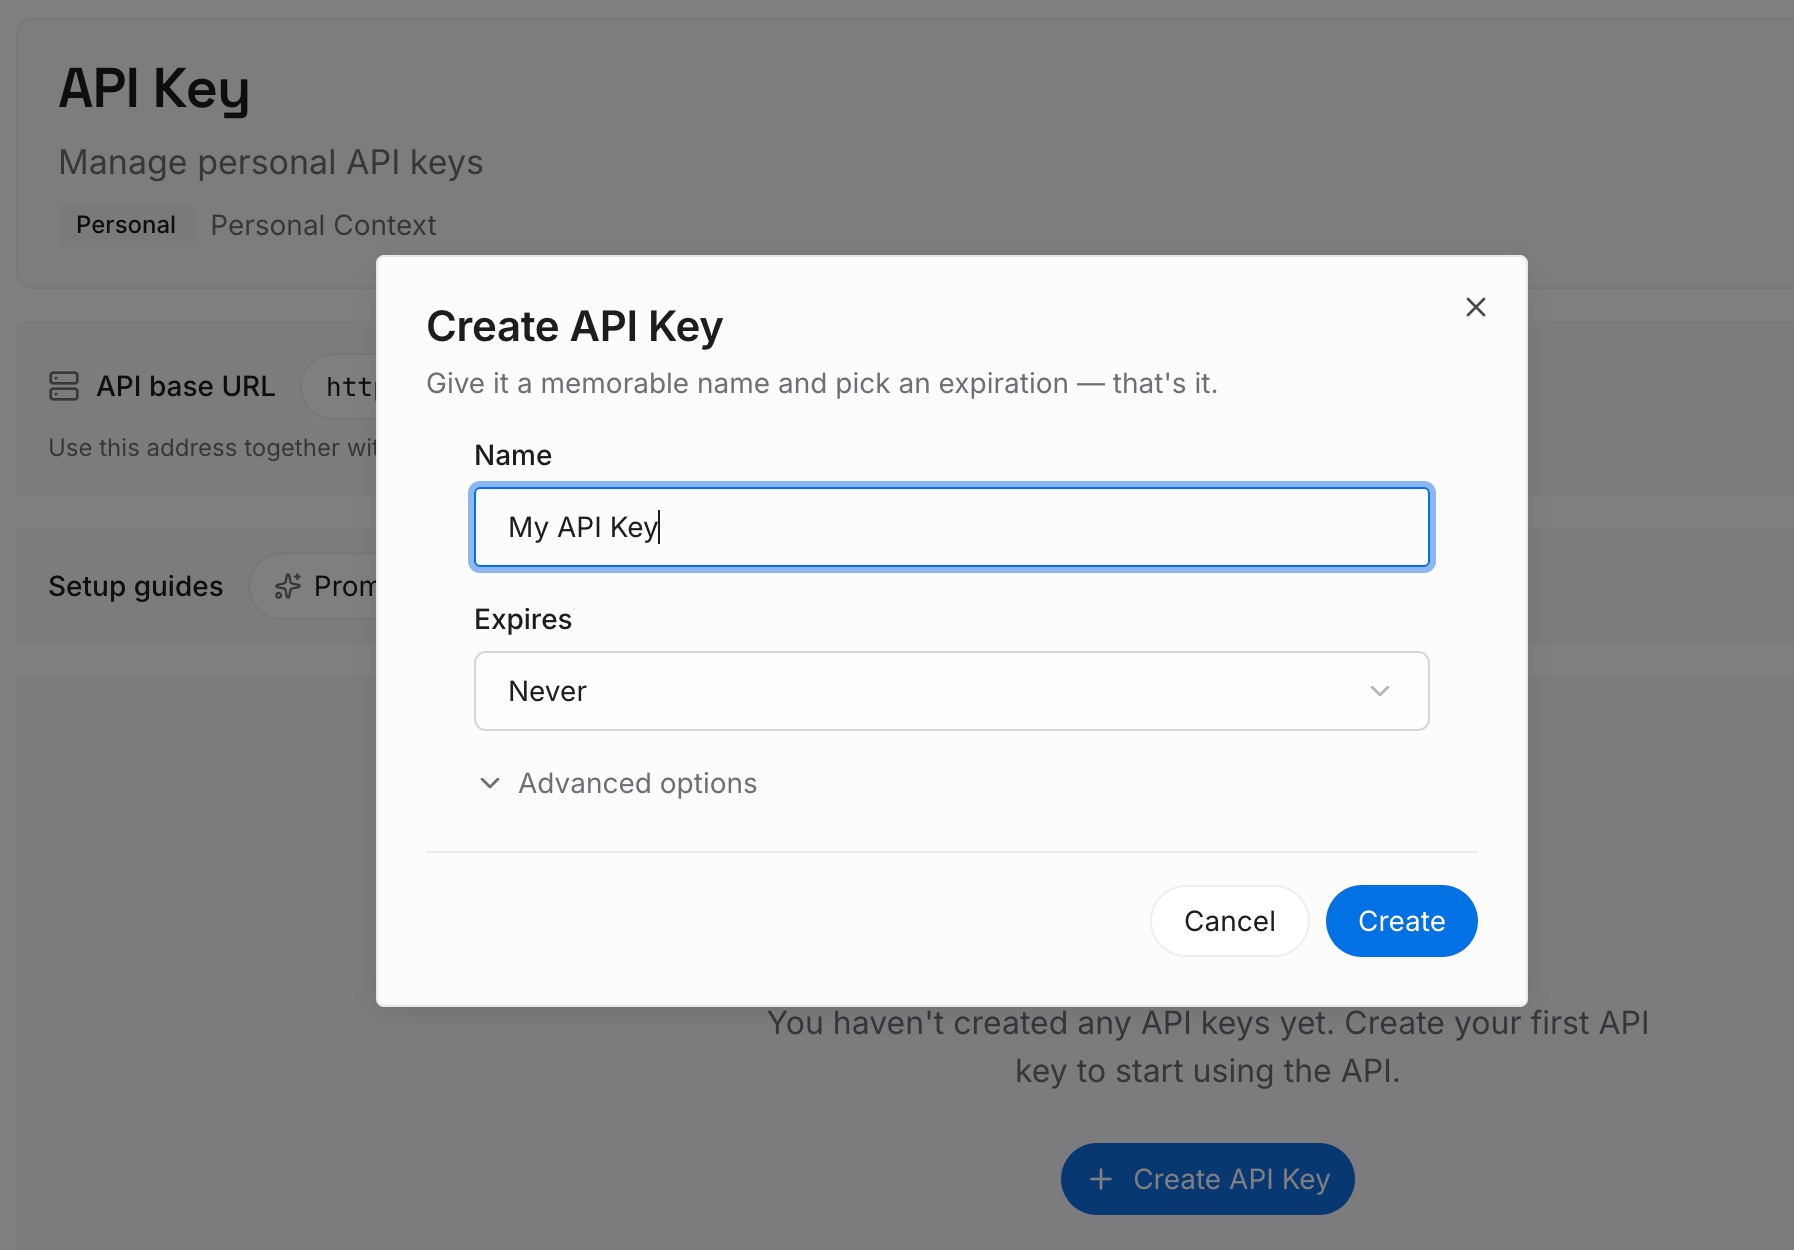
Paso 1: Crea una clave API
Inicia sesión y genera una clave desde el panel de control. La clave es lo que permite a tus agentes de programación leer las entradas que has escrito, en cualquier cliente que ejecuten.
Paso 2: Sube tus primeras memorias
Comienza con lo que el Paso 1 sacó a la luz pero ninguna página generada puede contener: las decisiones detrás de la estructura, los errores conocidos y las convenciones que el código no hace obvias. Una decisión por entrada, con la razón adjunta.
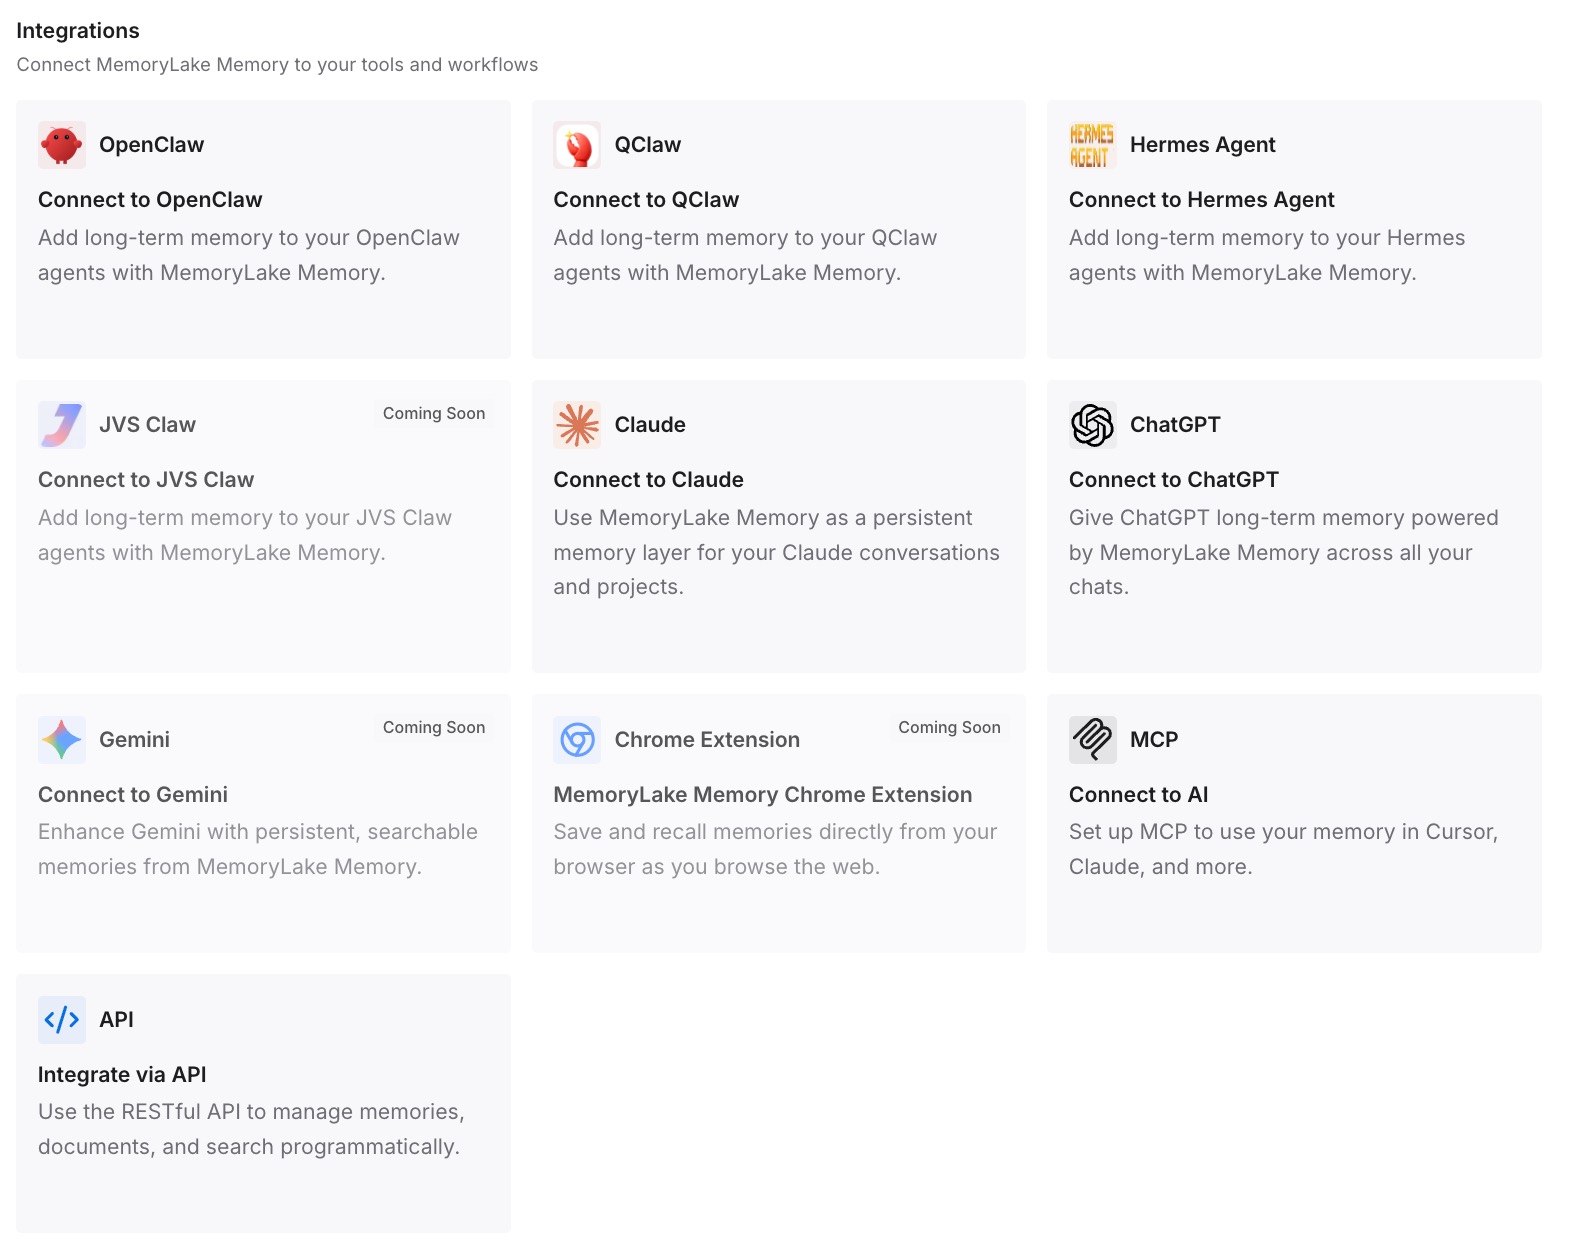
Paso 3: Conecta tu IA y agentes
Conecta los agentes de programación que utiliza tu equipo. Las decisiones se ubicarán junto a la wiki en cada sesión, incluyendo los agentes que leen DeepWiki a través de MCP.
Qué cambia esto en la práctica
La primera diferencia es que dirigir deja de ser riesgoso. Una vez que has registrado el árbol existente y construido la lista de páginas a partir de él, agregar un wiki.json amplía la cobertura en lugar de reemplazarla.
La segunda es que las notas del repositorio hacen el trabajo correcto. Cuando la cobertura vive en pages, las notas quedan libres para hacer aquello para lo que Cognition las diseñó: explicar prioridades y relaciones, lo que mejora cada página en lugar de solicitar páginas nuevas.
La tercera es que los agentes dejan de trabajar con un mapa parcial. La misma wiki alimenta a Ask Devin y a cada cliente MCP, por lo que una lista completa de páginas mejora las respuestas en todas partes a la vez. Esto es importante cuando, de lo contrario, los agentes tendrían que volver a leer la base de código en cada sesión para reconstruir el panorama.
La cuarta es que la documentación generada y el conocimiento del equipo dejan de confundirse. Una wiki regenerada a partir del código responde "qué es esto". Las decisiones responden "por qué es así". La recuperación sobre páginas generadas es útil, pero como explica por qué RAG no es memoria, es un trabajo diferente al de recordar lo que decidió un equipo.
Buenas prácticas para dirigir DeepWiki
Guarda el árbol de páginas actual antes de agregar una configuración. Es la única forma de saber qué eliminó un wiki.json.
Lista cada página que desees, no solo la que falta. La wiki genera exactamente el array de pages.
Usa repo_notes para dar énfasis, pages para cobertura. Las notas guían cómo se escriben las páginas; las páginas deciden cuáles existen.
Mantente dentro de los límites. Fusiona páginas en lugar de exceder el límite de páginas.
Indexa las ramas en las que trabaja tu equipo. Devin indexa la rama por defecto a menos que agregues otras.
Haz coincidir el campo MCP con el cliente. Un nombre de campo incorrecto hace que el servidor sea ignorado silenciosamente.
Mantén las razones fuera de la wiki y en un lugar duradero. Las propias entradas de Knowledge de Devin tienen sus propias reglas de recuperación, y el hecho de que Devin olvide el contexto de la tarea es un problema independiente de la cobertura de la documentación. Para los procedimientos, mover las memorias a habilidades (skills) es otra alternativa.
Conclusión
.devin/wiki.json es la herramienta adecuada cuando el plan automático de DeepWiki pasa por alto partes importantes de un repositorio grande. También es literal. Como dice Cognition, "solo se generarán las páginas que definas en el JSON, ni más ni menos".
Registra la wiki que tienes antes de dirigirla. Construye la lista de páginas a partir de ese registro más las brechas detectadas, usa las notas del repositorio para dar énfasis, mantente dentro de los límites y regenera. Luego verifica que la rama sea la correcta y que cada cliente MCP esté configurado con el campo que espera, de modo que los agentes que leen la wiki obtengan la versión que planeaste.
Mantén las razones detrás del código en su propia capa, porque una wiki generada describe la estructura, y las decisiones detrás de ella provienen de tu equipo. Para la cuestión más amplia de qué transmiten y qué no las conexiones MCP entre sesiones, consulta la capa de memoria que falta en MCP.