
De dónde viene el término
Los Requests for Startups de Verano 2026 de YC incluyen una entrada titulada Company Brain. Comienza con una afirmación sobre lo que está frenando a la IA: "El mayor bloqueador para la automatización de las empresas mediante IA ya no son los modelos, estos se volvieron muy buenos muy rápido. Ahora el bloqueador es el conocimiento del dominio".
La entrada describe el problema en términos ordinarios. "Cada empresa tiene conocimientos críticos dispersos por todas partes. Parte de ellos vive en la cabeza de las personas. Otra parte está enterrada en cuentas de correo electrónico antiguas, hilos de Slack, tickets de soporte y bases de datos". Y explica por qué eso funciona para las personas pero no para los agentes: "La empresa funciona porque los humanos recuerdan vagamente dónde está ese conocimiento y cómo aplicarlo".
Su conclusión: "Pero los agentes de IA no pueden operar así. Si queremos que cada empresa funcione con automatización de IA, necesitamos una nueva primitiva: un company brain".
Qué es un company brain
La entrada de YC lo define como "Un sistema que extrae el conocimiento de todas estas fuentes fragmentadas, lo estructura, lo mantiene actualizado y lo convierte en un archivo de habilidades ejecutable para la IA".
Esa frase tiene cuatro verbos, y cada uno es una tarea separada:
- Extraer conocimiento. Encontrarlo en correos electrónicos, chats, tickets, documentos y bases de datos.
- Estructurarlo. Convertir menciones dispersas en algo organizado.
- Mantenerlo actualizado. Actualizarlo a medida que la empresa cambia.
- Hacerlo utilizable por la IA. En palabras de la entrada, un archivo de habilidades ejecutable.
El objetivo del último paso es la acción, no la búsqueda. "Entonces los sistemas de IA pueden usar ese archivo de habilidades para realizar el trabajo de manera segura y consistente".
Lo que no es
La entrada es explícita sobre la diferencia con las herramientas que ya existen: "Esto no es una búsqueda en toda la empresa ni un chatbot sobre documentos. Es un mapa vivo de cómo funciona una empresa: cómo se manejan los reembolsos, cómo se deciden las excepciones de precios o cómo responden los ingenieros a los incidentes".
La búsqueda encuentra documentos. Se supone que un company brain captura cómo se hacen las cosas, incluidas las partes que nadie escribió.
Qué tiene que recordar un company brain
Los tres ejemplos de la entrada de YC apuntan a tres tipos de conocimiento que son difíciles de encontrar en documentos.
Cómo se hacen las cosas
Cómo se manejan los reembolsos es un procedimiento. Parte de ello está en una página de políticas. Gran parte está en la práctica: qué casos van a qué persona, qué se revisa primero, qué cuenta como una excepción.
Cómo se toman las decisiones
Cómo se deciden las excepciones de precios es una cuestión de juicio. Depende de precedentes, de quién tiene autoridad y de razones que pueden existir solo en hilos antiguos. Un company brain tiene que capturar la decisión y por qué se tomó, o un agente no podrá aplicarla al siguiente caso.
Cómo responde la gente
Cómo responden los ingenieros a los incidentes es práctica bajo presión. Los runbooks ayudan, pero la respuesta real también puede depender de saber qué sistema tiende a fallar y a quién llamar.
De dónde vino
Debajo de los tres está la procedencia. Un hecho sin una fuente es difícil de confiar y difícil de corregir. Los proyectos de código abierto en este espacio hacen esto explícito. GBrain, un proyecto de cerebro de código abierto al que la entrada de YC señala como modelo, dice que almacena "hechos explícitos con sus fuentes", admite "correcciones y retiros" y hace que "la misma memoria esté disponible en todos sus agentes".
Quién lo mantiene actualizado
Mantenerlo actualizado es la parte más corta de la definición y la más difícil de cumplir. Las empresas cambian constantemente: precios, propietarios, políticas, sistemas. Un company brain que era preciso en marzo puede engañar a un agente en octubre.
Tres cosas hacen que la actualidad funcione:
- Correcciones. Cuando un hecho es erróneo, debe haber una manera de corregirlo, y la corrección debe prevalecer sobre la versión antigua.
- Retiro. Cuando un hecho ya no se aplica, debe haber una manera de retirarlo, no solo de añadir uno nuevo encima.
- Fechas. Saber cuándo se registró un hecho le dice a un agente, y a una persona, cuánto confiar en él.
Alguien tiene que ser el dueño de esto. La extracción puede encontrar conocimiento, pero decidir qué versión es la actual es una decisión de juicio, y pertenece a las personas que dirigen el proceso. Nuestro análisis sobre cómo la memoria de los agentes se volvió más precisa al conservar menos explica por qué la poda importa tanto como la adición.
Dónde encaja la memoria de IA
Si su equipo utiliza asistentes con memoria, ayuda ver qué contiene cada tipo, porque ninguno de ellos es un company brain por sí solo.
Memoria personal en cada asistente
ChatGPT y Claude recuerdan cosas sobre la persona que los usa. Esa memoria es por cuenta. En los planes Team de Claude, Anthropic dice: "Los miembros individuales del plan Team gestionan sus propios ajustes de memoria directamente". Lo que aprendió el asistente de una persona no está disponible automáticamente para el de un colega.
Los agentes de programación también guardan memoria. La memoria automática de Claude Code es local de la máquina; Anthropic dice que sus archivos "no se comparten entre máquinas o entornos en la nube". Codex almacena memorias locales en su directorio de inicio, y el consejo de OpenAI es directo: "Trate las memorias como una capa de recuperación útil, no como la única fuente de reglas que deben aplicarse siempre".
Archivos de instrucciones en repositorios
Para el conocimiento de ingeniería, los equipos ya tienen una capa compartida: archivos registrados en el repositorio, como AGENTS.md y CLAUDE.md. La guía de OpenAI es "Mantener la guía necesaria del equipo en AGENTS.md o en la documentación registrada". Estos archivos son compartidos, versionados y revisables, que es la mayor parte de lo que necesita un company brain, para un repositorio. Para las decisiones que quedan fuera de cualquier repositorio, nuestra guía sobre por qué ChatGPT olvida las decisiones arquitectónicas cubre lo que se puede perder.
Una capa compartida entre personas y agentes
La pieza que falta es una capa que se sitúe entre personas, herramientas y proyectos. El README de GBrain traza una línea útil aquí: "Las preferencias y hechos duraderos se pueden compartir entre agentes; el estado transitorio de la tarea y la configuración del arnés permanecen locales". Un company brain es la parte duradera y compartida. Nuestra lista de soluciones de memoria compartida para sistemas multi-agente compara enfoques para esa capa.
Qué hace que un company brain sea confiable
Si los agentes actúan basándose en un company brain, sus errores se convierten en los errores de los agentes. Cuatro propiedades deciden si eso es aceptable:
- Procedencia. Cada hecho se remonta a su origen.
- Alcance. Las personas y los agentes ven lo que se les permite ver. El README de GBrain, por ejemplo, dice: "Los clientes remotos autenticados están limitados por las concesiones de origen y operación, además de los filtros de visibilidad".
- Actualidad. Los hechos llevan fechas, y los obsoletos se corrigen o se retiran.
- Revisabilidad. Las personas pueden leer lo que está almacenado y cambiarlo.
Estas son las mismas propiedades que hacen que cualquier memoria compartida sea útil. Nuestra guía sobre ingeniería de contexto explica por qué el contexto que recibe un agente importa tanto como el modelo.
Lo que la gente intenta primero
Indexar todo y llamarlo cerebro. Eso es búsqueda en toda la empresa. La entrada de YC lo descarta explícitamente.
Confiar en la memoria del asistente de cada persona. La memoria personal es por cuenta o por máquina. No suma un conocimiento compartido.
Tratar la extracción como todo el trabajo. Extraer el conocimiento es el primer paso. Mantenerlo actualizado es el continuo.
Omitir la procedencia. Los hechos sin fuentes son difíciles de confiar y más difíciles de corregir.
Empezar con toda la empresa. Un cerebro construido para todo a la vez es difícil de mantener específico. Un proceso, bien hecho, muestra lo que funciona.
La solución: Comience un company brain con un proceso que pueda mantener actualizado
Paso 1: Elija un proceso y escriba cómo funciona realmente
Elija un proceso en el que los agentes o las personas nuevas sigan fallando: reembolsos, un tipo de excepción, una respuesta a un incidente. Escriba cómo funciona realmente, incluidas las partes que viven en la cabeza de las personas. Pregunte a las personas que lo ejecutan.
Paso 2: Registre las decisiones con sus razones y fechas
Para las decisiones de juicio en ese proceso, registre cada decisión, por qué se tomó, quién la tomó y cuándo. Estos son los hechos que un agente no puede inferir. Nuestra guía para dar a Claude conocimiento de dominio permanente explica cómo estructurar este tipo de conocimiento para un asistente.
Paso 3: Asigne un propietario y un ritmo de revisión
Haga que una persona sea responsable de mantener ese proceso actualizado. Corrija los hechos que cambien, retire los que ya no se apliquen y ponga fecha a cada actualización. Si el conocimiento comienza en un chat grupal, nuestra guía para mover un chat grupal de ChatGPT a un proyecto compartido muestra una forma de darle un hogar.
Configuración en MemoryLake
Un company brain, en el sentido de YC, es un sistema grande. La parte por la que los equipos pueden empezar hoy es más pequeña: una lista compartida y mantenida de los hechos y decisiones que las personas y los agentes necesitan constantemente, con fuentes y fechas, que no esté ligada a la cuenta de una persona o a una herramienta.
MemoryLake es una capa de memoria para mantener esa lista en un lugar que usted mantiene, disponible para los asistentes que conecte, como ChatGPT, Claude Code y Codex.
Usted mismo escribe las entradas, con sus propias palabras. No se lee nada, ni se escribe, ni se borra de su correo electrónico, sus herramientas de chat, sus tickets, la memoria de sus asistentes o el almacén de cualquier proveedor. MemoryLake guarda lo que usted elija registrar; no extrae conocimiento de sus sistemas.
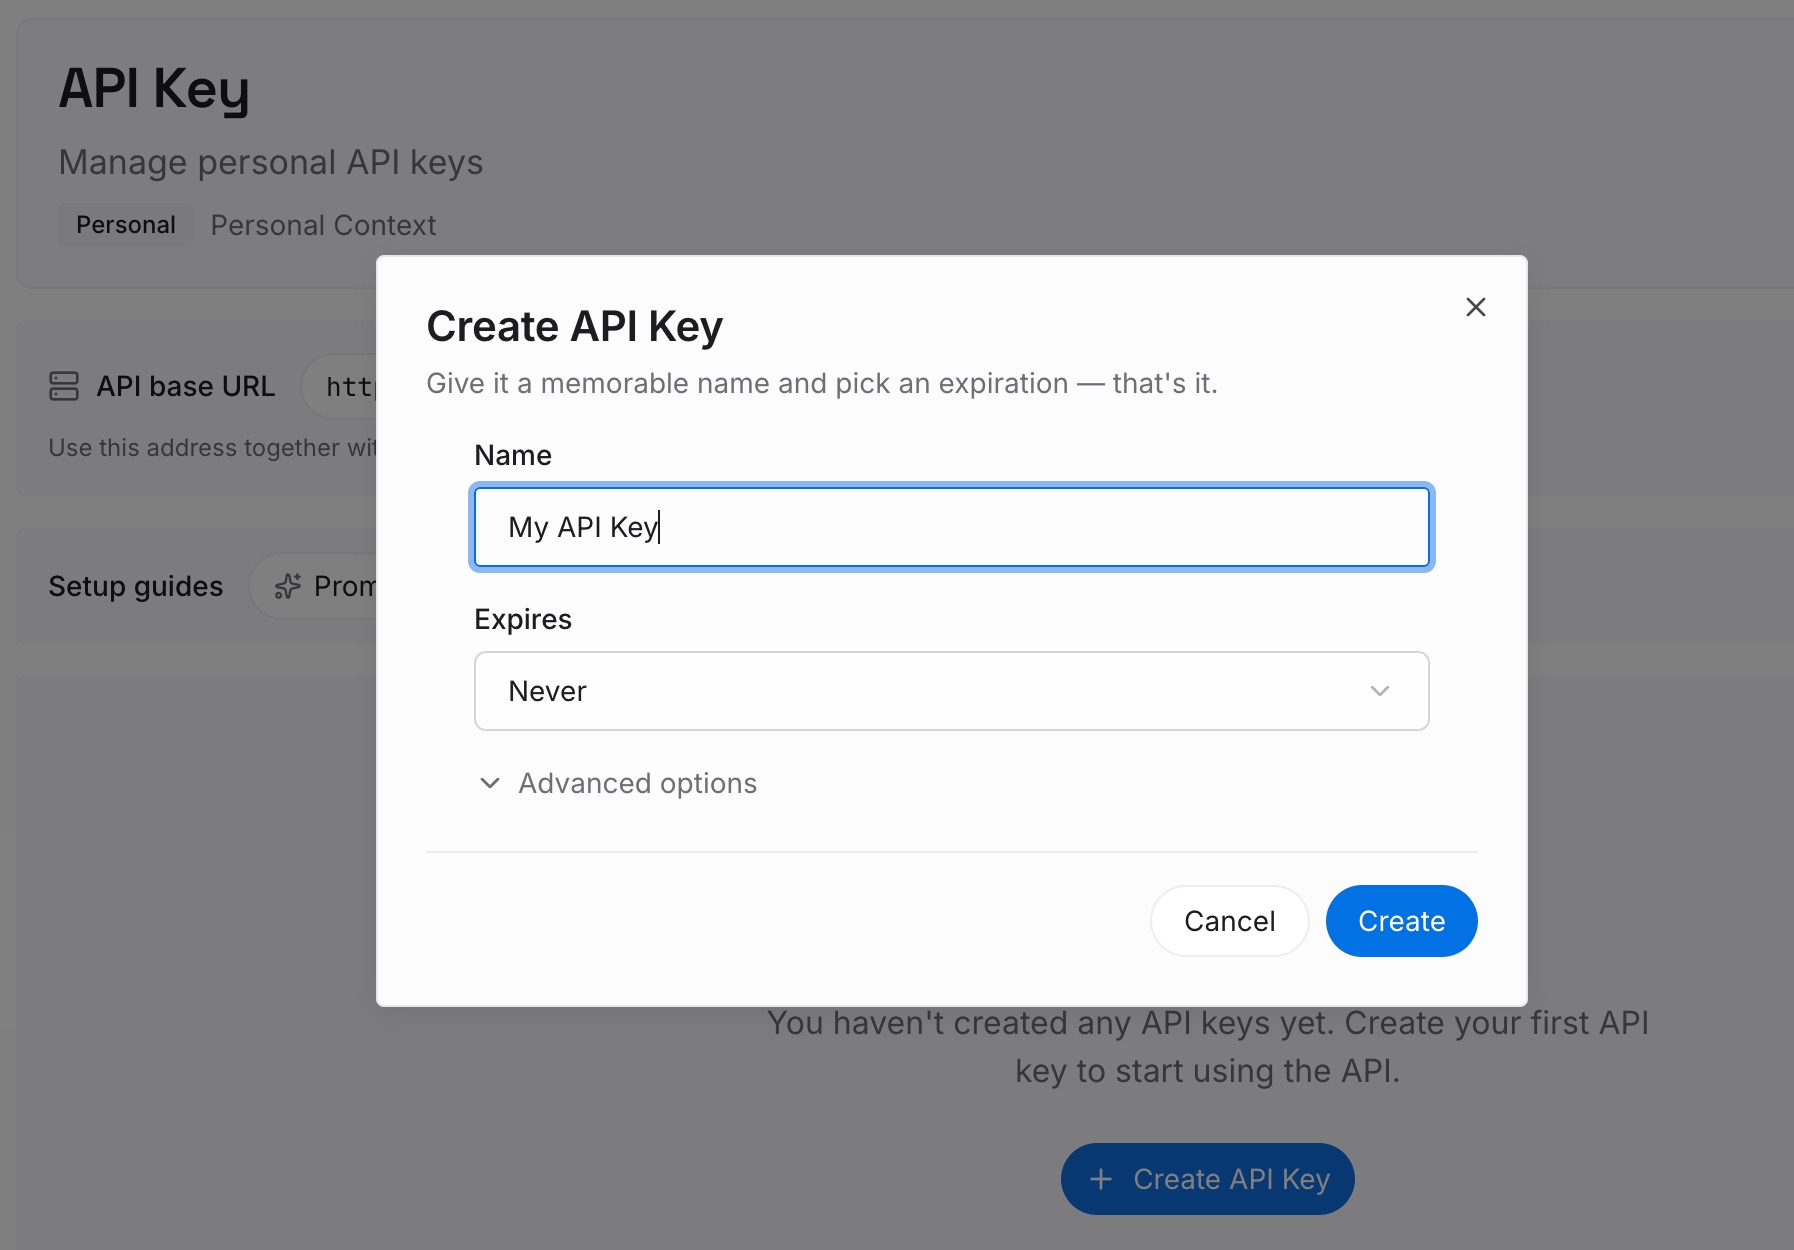
Paso 1: Crear una clave API
Inicie sesión y genere una clave desde el panel de control. La clave pertenece a su espacio de trabajo de MemoryLake y es independiente de sus otras cuentas.
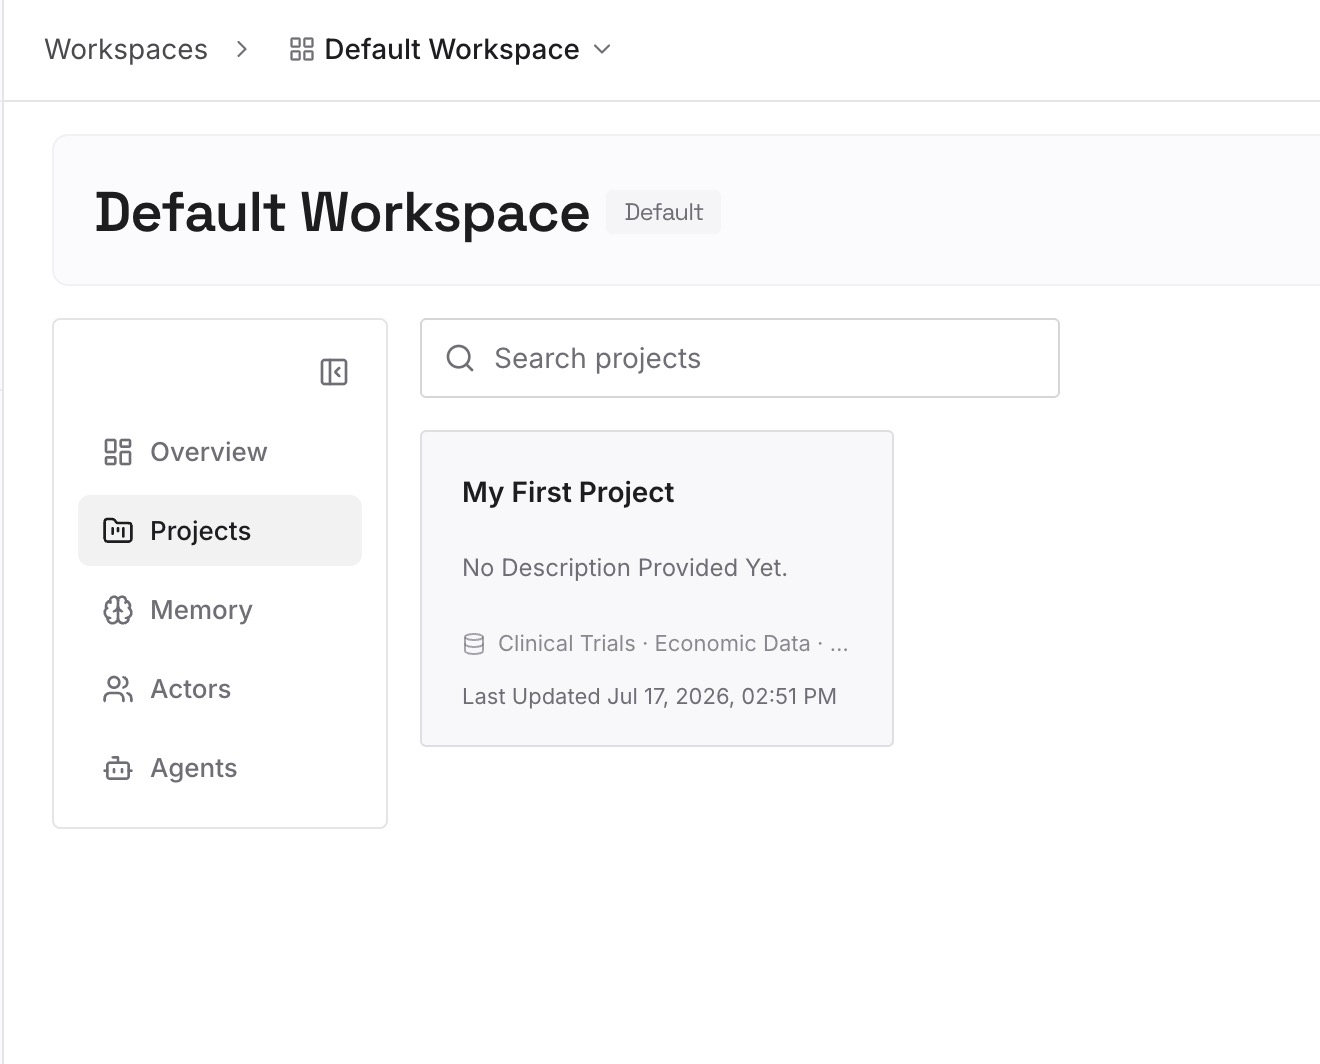
Paso 2: Subir sus primeras memorias
Comience con el proceso del Paso 1 de la solución y las decisiones del Paso 2. Un punto por entrada, con su fuente y fecha, y solo lo que la política de su organización le permita almacenar.
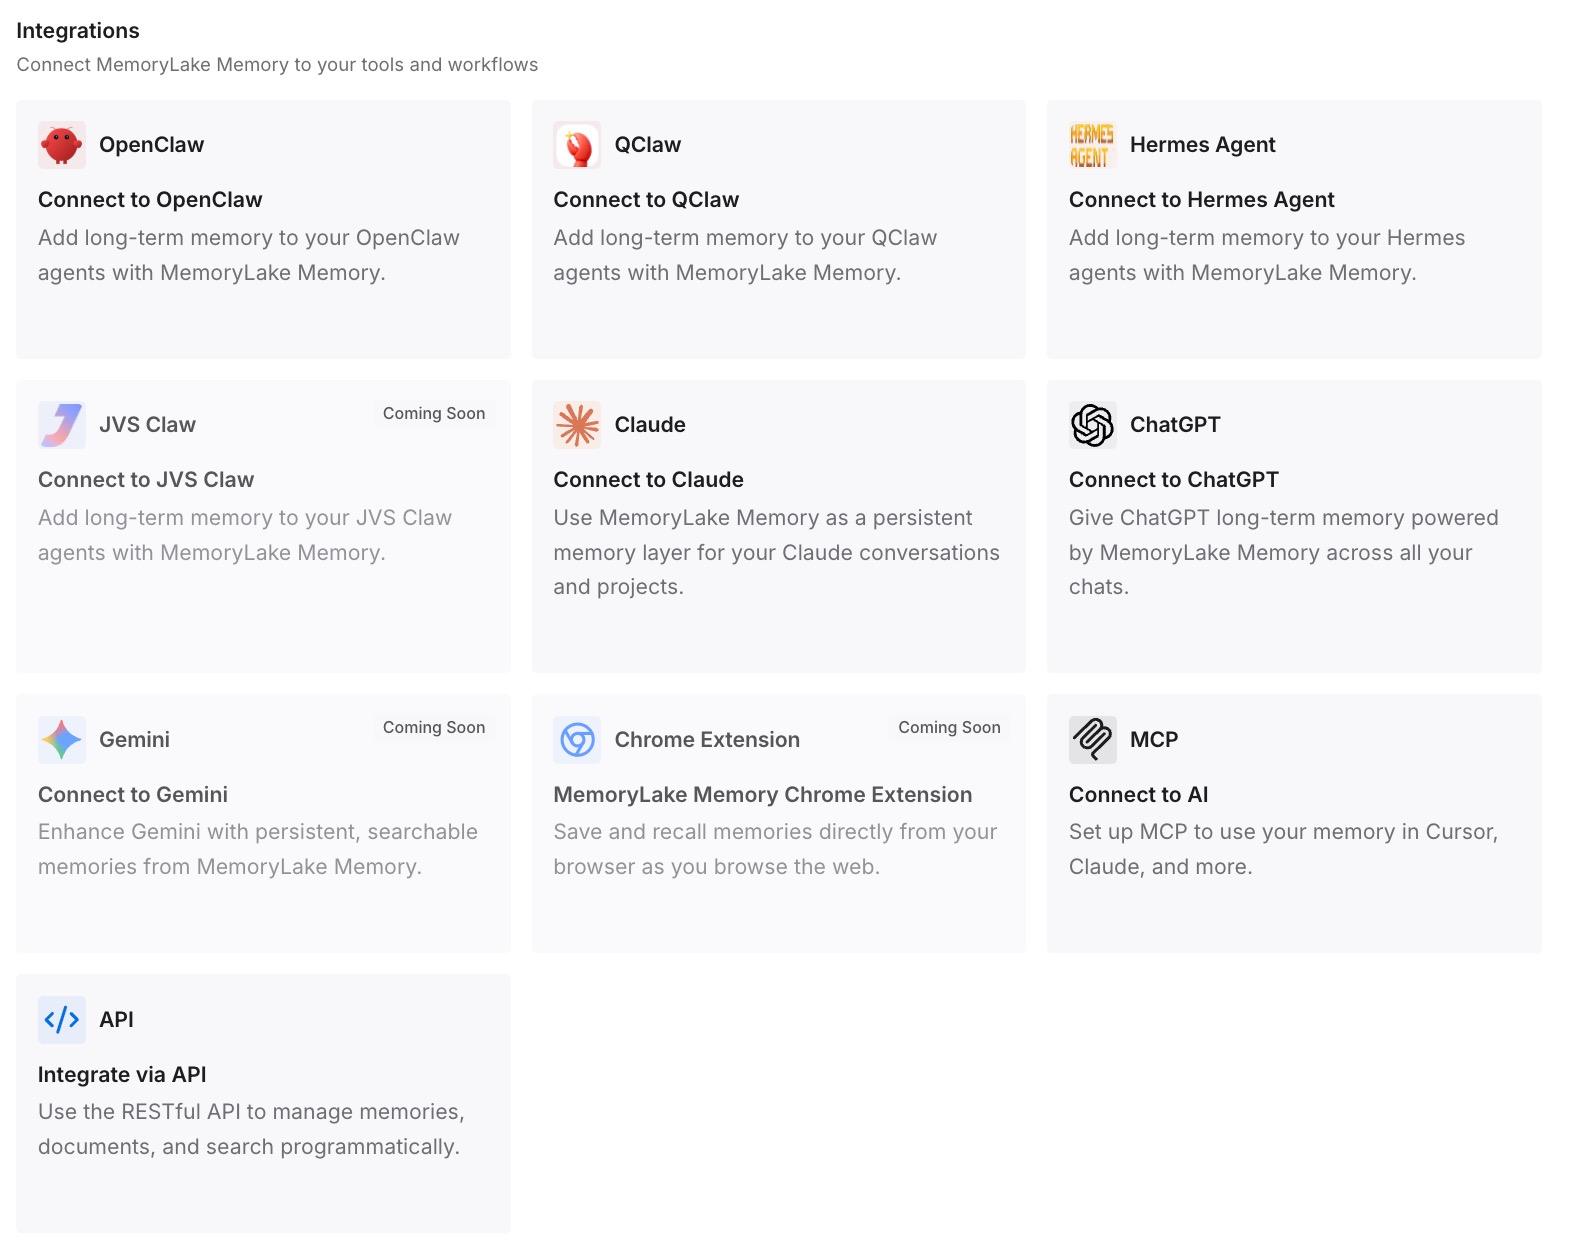
Paso 3: Conectar su IA y agentes
Conecte los asistentes que utiliza su equipo. Los mismos hechos mantenidos están disponibles en cada uno de ellos, y el propietario del Paso 3 los mantiene actualizados en un solo lugar.
Qué cambia esto en la práctica
La primera diferencia es la claridad sobre el término. Un company brain no es una búsqueda ni un chatbot sobre documentos. Es conocimiento mantenido sobre cómo funciona la empresa.
La segunda es un punto de partida realista. Un proceso, escrito con decisiones, fuentes y fechas, supera a un plan vago para capturarlo todo.
La tercera es que la actualidad tiene un dueño. La parte más difícil de la definición, mantenerlo actualizado, se convierte en el trabajo de alguien en lugar de ser el de nadie.
Mejores prácticas para construir un company brain
Comience con un proceso. Demuestre que funciona antes de expandirse.
Capture decisiones, no solo documentos. Las razones son lo que los agentes no pueden inferir.
Mantenga las fuentes en cada hecho. La procedencia hace posible la corrección.
Ponga fecha a cada entrada. La actualidad depende de saber cuándo algo era cierto.
Retire lo que esté obsoleto. No se limite a añadir hechos más nuevos encima.
Respete el alcance. No todos los hechos deben estar frente a cada persona o agente.
Mantenga las reglas del repositorio en el repositorio. Los archivos de instrucciones compartidos ya funcionan para el código.
Conclusión
Un company brain es un sistema que captura cómo funciona realmente una empresa, mantiene ese conocimiento actualizado y lo hace utilizable por la IA. Los Requests for Startups de Verano 2026 de YC popularizaron el término, definiéndolo frente a la búsqueda en toda la empresa y los chatbots sobre documentos, y señalando los procedimientos, las decisiones y las respuestas como lo que debe contener.
La memoria en los asistentes actuales cubre partes de esto: memoria personal por cuenta, memoria local por máquina y archivos de instrucciones por repositorio. La capa que falta es compartida, mantenida y con fuentes. Comience con un proceso, registre sus decisiones con razones y fechas, y asigne a alguien la tarea de mantenerlo actualizado.