
La respuesta corta
La ingeniería de contexto es la práctica de decidir qué información llega a un modelo de lenguaje en cada paso de su trabajo (instrucciones, herramientas, ejemplos, documentos recuperados, historial de conversación y memoria) para que tenga lo que necesita y poco más. La ingeniería de prompts es una parte de ella. La memoria es de donde proviene el contexto cuando el trabajo abarca más de una sesión.
De dónde proviene el término
El equipo de ingeniería de Anthropic ofreció una de las definiciones más claras en una publicación de septiembre de 2025. "En Anthropic, vemos la ingeniería de contexto como la progresión natural de la ingeniería de prompts". La ingeniería de prompts, escribieron, consiste en escribir y organizar instrucciones. La ingeniería de contexto "se refiere al conjunto de estrategias para curar y mantener el conjunto óptimo de tokens (información) durante la inferencia del LLM, incluyendo toda la demás información que pueda llegar allí fuera de los prompts".
El cambio ocurrió porque los agentes trabajan en bucles. La misma publicación explica que "un agente que se ejecuta en un bucle genera cada vez más datos que podrían ser relevantes para el siguiente turno de inferencia, y esta información debe refinarse cíclicamente". Eso hace que el trabajo sea continuo: "La ingeniería de contexto es el arte y la ciencia de curar lo que entrará en la ventana de contexto limitada a partir de ese universo de información posible en constante evolución".
Por lo tanto, la diferencia entre ambos radica en el alcance y el momento. La ingeniería de prompts es algo que se hace una vez, antes de una conversación. La ingeniería de contexto ocurre cada vez que el agente decide qué mirar a continuación.
Qué entra en el contexto de un agente
Anthropic enumera las piezas con las que trabaja un agente: "instrucciones del sistema, herramientas, Model Context Protocol (MCP), datos externos, historial de mensajes, etc.". En la práctica, la mayoría de los agentes recurren a cinco tipos de contexto.
Instrucciones. El prompt del sistema, además de archivos como CLAUDE.md o AGENTS.md que los agentes de programación cargan al inicio de una sesión.
Herramientas. Las definiciones de lo que el agente puede hacer, que en sí mismas ocupan espacio. Anthropic advierte que "uno de los modos de fallo más comunes que vemos son los conjuntos de herramientas inflados que cubren demasiada funcionalidad o conducen a puntos de decisión ambiguos sobre qué herramienta usar".
Ejemplos. Un pequeño conjunto de ejemplos canónicos, en lugar de una lista exhaustiva de casos límite.
Información recuperada. Documentos, resultados de búsqueda y datos que se extraen cuando es necesario.
Historial y memoria. Lo que sucedió antes en esta sesión y lo que se aprendió en las anteriores.
Una buena ingeniería de contexto consiste principalmente en lograr un equilibrio entre estos elementos. El principio rector de Anthropic es que "una buena ingeniería de contexto significa encontrar el conjunto más pequeño posible de tokens de alta señal que maximicen la probabilidad de obtener un resultado deseado".
Por qué más contexto no es la respuesta
Es tentador asumir que las ventanas de contexto más grandes hacen que todo esto sea innecesario. Anthropic sostiene lo contrario, señalando lo que llama deterioro del contexto: "a medida que aumenta el número de tokens en la ventana de contexto, disminuye la capacidad del modelo para recordar con precisión la información de ese contexto". Su conclusión es que "el contexto, por lo tanto, debe tratarse como un recurso finito con rendimientos marginales decrecientes".
La documentación de la Claude Developer Platform sobre la edición de contexto plantea el mismo punto en términos de producto: "el contexto es un recurso finito con rendimientos decrecientes, y el contenido irrelevante degrada el enfoque del modelo". Y la publicación de ingeniería de Anthropic añade que "es probable que, en el futuro previsible, las ventanas de contexto de todos los tamaños estén sujetas a la contaminación del contexto y a problemas de relevancia de la información".
Alibaba llegó a la misma conclusión desde el lado empresarial. En la conferencia magistral de Yunqi, el argumento fue que no se pueden volcar los datos de una empresa en un agente y esperar que funcione; sobrecargar la ventana desperdicia el espacio que el agente necesita para la tarea, por lo que los datos deben comprimirse primero en capas.
Esta es también la razón por la que los prompts más cortos por sí solos no resuelven los problemas de costo o calidad, un punto explorado en por qué los prompts más cortos no son suficientes. La pregunta no es qué tan poco envías, sino si lo que envías es lo correcto.
Tres técnicas para el trabajo que supera una sola ventana de contexto
Para tareas largas, Anthropic describe tres enfoques: "compactación, toma de notas estructurada y arquitecturas multiagente".
Compactación. "La compactación es la práctica de tomar una conversación que se acerca al límite de la ventana de contexto, resumir su contenido y reiniciar una nueva ventana de contexto con el resumen". Mantiene el trabajo en marcha, con un riesgo conocido: "una compactación demasiado agresiva puede resultar en la pérdida de un contexto sutil pero crítico cuya importancia solo se hace evidente más tarde".
Toma de notas estructurada. "La toma de notas estructurada, o memoria agéntica, es una técnica en la que el agente escribe regularmente notas que persisten en la memoria fuera de la ventana de contexto. Estas notas se vuelven a incorporar a la ventana de contexto más adelante". Una lista de tareas pendientes o un archivo NOTES.md son las versiones sencillas.
Subagentes. "Los subagentes especializados pueden encargarse de tareas enfocadas con ventanas de contexto limpias", devolviendo solo un resultado condensado al agente principal.
También existe un patrón de recuperación que atraviesa los tres enfoques. En lugar de cargar todo por adelantado, los agentes "mantienen identificadores ligeros (rutas de archivos, consultas almacenadas, enlaces web, etc.) y utilizan estas referencias para cargar datos dinámicamente en el contexto en tiempo de ejecución mediante herramientas". Claude Code es el propio ejemplo de Anthropic de un híbrido: "los archivos CLAUDE.md se introducen de forma ingenua en el contexto por adelantado, mientras que primitivas como glob y grep le permiten navegar por su entorno y recuperar archivos justo a tiempo".
La recuperación no es lo mismo que la memoria, aunque a menudo se confunden. Memoria de IA frente a RAG cubre la diferencia en detalle.
Por qué "el contexto es todo lo que necesitas" se convirtió en un argumento empresarial
En septiembre de 2026, la ingeniería de contexto pasó de ser un tema de blog de ingeniería a una estrategia corporativa. Alibaba Cloud describió su nube agéntica como "construida en torno a tres escenarios principales: modelo, arnés y contexto", y lanzó un servicio de Agent Context "que brinda a los agentes de IA contexto en tiempo real y memoria a largo plazo". Qianwen Office lanzó un producto complementario llamado Enterprise Context, que es el aspecto que tiene una capa de contexto para agentes de IA cuando el alcance es toda una empresa.
La conferencia magistral de Qianwen Office enmarcó la versión empresarial del problema en tres partes: agentes que no conocen el negocio, conocimientos útiles que se quedan en las personas y dudas sobre la seguridad de los datos. La respuesta propuesta fue conectar los datos de la empresa, comprenderlos y hacerlos reutilizables, con la compresión en el centro.
La frase más interesante provino de una entrevista posterior. Shu Junliang, vicepresidente de Qianwen Office, dijo que el contexto "está desacoplado del Agent que finalmente utilizas" y que el contexto de una empresa "debe pertenecer a esta empresa". Añadió que esta infraestructura "aún no se ha estandarizado como la base de datos".
Esa es la forma empresarial de un principio que todo ingeniero de contexto encuentra tarde o temprano. El contexto se ensambla por paso, pero el conocimiento a partir del cual se ensambla tiene un propietario, y ese propietario rara vez es el agente.
Dónde encaja la memoria y por qué debe sobrevivir al agente
La ingeniería de contexto decide qué entra en la ventana. La memoria es de donde proviene gran parte de ello una vez que el trabajo abarca más de una sesión. Algunos autores llaman ahora a esta segunda mitad ingeniería de memoria: la ingeniería de contexto opera en el momento de la inferencia, la memoria a lo largo del tiempo.
El inconveniente es que la mayoría de los mecanismos de memoria actuales están vinculados a una sola herramienta o a un solo lugar.
La memoria automática de Claude Code es un buen ejemplo de un diseño sensato con un límite claro: "La memoria automática es local de la máquina" y "Los archivos no se comparten entre máquinas ni entornos de nube". La herramienta de memoria de Anthropic para desarrolladores va más allá al ponerte a ti a cargo: "La herramienta de memoria funciona en el lado del cliente: Claude solicita operaciones de archivos y tu aplicación las ejecuta. Tú controlas dónde y cómo se almacenan los datos a través de tu propia infraestructura". En la misma página, el límite se establece claramente: "La memoria reside completamente en tu aplicación". La forma en que las tiendas gestionadas de Anthropic abordan esto se cubre en explicación de los almacenes de memoria de agentes de Claude.
Las herramientas de consumo también trazan sus propias líneas. En ChatGPT, por ejemplo, los proyectos compartidos "no tienen acceso al contexto de un miembro individual, a las instrucciones personalizadas ni a las memorias fuera del proyecto".
Ninguno de estos son fallos. Cada límite protege algo: privacidad, alcance, previsibilidad. Pero juntos significan que el conocimiento que necesita un agente está deprimido en tantos lugares como herramientas utilices. Un equipo que ejecuta tres agentes tiene tres memorias parciales, cada una moldeada por las reglas de un producto.
Ese es el vacío que señaló la entrevista de Alibaba. Si el contexto debe desacoplarse del agente, entonces la memoria de la que se nutre también debería estarlo. Qué tipos de memoria importan es un tema en sí mismo, expuesto en los seis tipos de memoria de IA; el punto práctico aquí es dónde residen.
Cómo aplicar la ingeniería de contexto a tus propios agentes
No necesitas un framework para empezar. Tres pasos cubren la mayor parte del valor.
Paso 1: Separa el contexto permanente del contexto de trabajo
Haz una lista de lo que debería comenzar cada sesión: para quién es el trabajo, las convenciones, las decisiones acordadas, las definiciones que ningún modelo puede adivinar. Eso es el contexto permanente. Luego, haz una lista de lo que una tarea atrae a medida que avanza: archivos, resultados de búsqueda, historial reciente. Eso es el contexto de trabajo.
El contexto permanente pertenece a las instrucciones y a la memoria. El contexto de trabajo debe recuperarse justo a tiempo. Mezclar ambos es la razón más común por la que los agentes omiten datos clave o se ahogan en datos irrelevantes.
Paso 2: Comprime el contexto permanente en capas
Escribe primero un índice corto, luego una entrada compacta por proyecto, decisión o proceso, y después los documentos de origen. Pon fecha a las entradas para que las decisiones más recientes reemplacen visiblemente a las más antiguas. Mantén los ejemplos canónicos en lugar de exhaustivos.
Resiste la tentación de guardarlo todo. Si una mayor memoria ayuda en algo a un agente es una pregunta abierta, analizada en cuánta memoria darle a un agente de IA.
Paso 3: Almacena el contexto permanente donde cada agente pueda alcanzarlo
Este es el paso que la mayoría de las configuraciones omiten. Si tu contexto permanente reside en la memoria de una sola herramienta, todos los demás agentes comenzarán sin él. Manténlo en una capa externa a cualquier producto individual y pruébalo haciendo a dos agentes diferentes la misma pregunta sobre tu trabajo. Si solo uno sabe la respuesta, el contexto reside en esa herramienta.
Configuración de esto en MemoryLake
El Paso 3 describe una capa de memoria que te pertenece a ti en lugar de a un agente. MemoryLake está diseñado para ese trabajo: memoria a largo plazo para agentes de IA que se encuentra fuera de cualquier herramienta individual, de modo que el contexto permanente que diseñaste una vez esté disponible para cada asistente que utilices.
Tú mismo escribes las entradas, con tus propias palabras. No se lee, escribe ni elimina nada del directorio de memoria de Claude Code, de los almacenes propios de tus agentes ni del almacén de ningún proveedor.
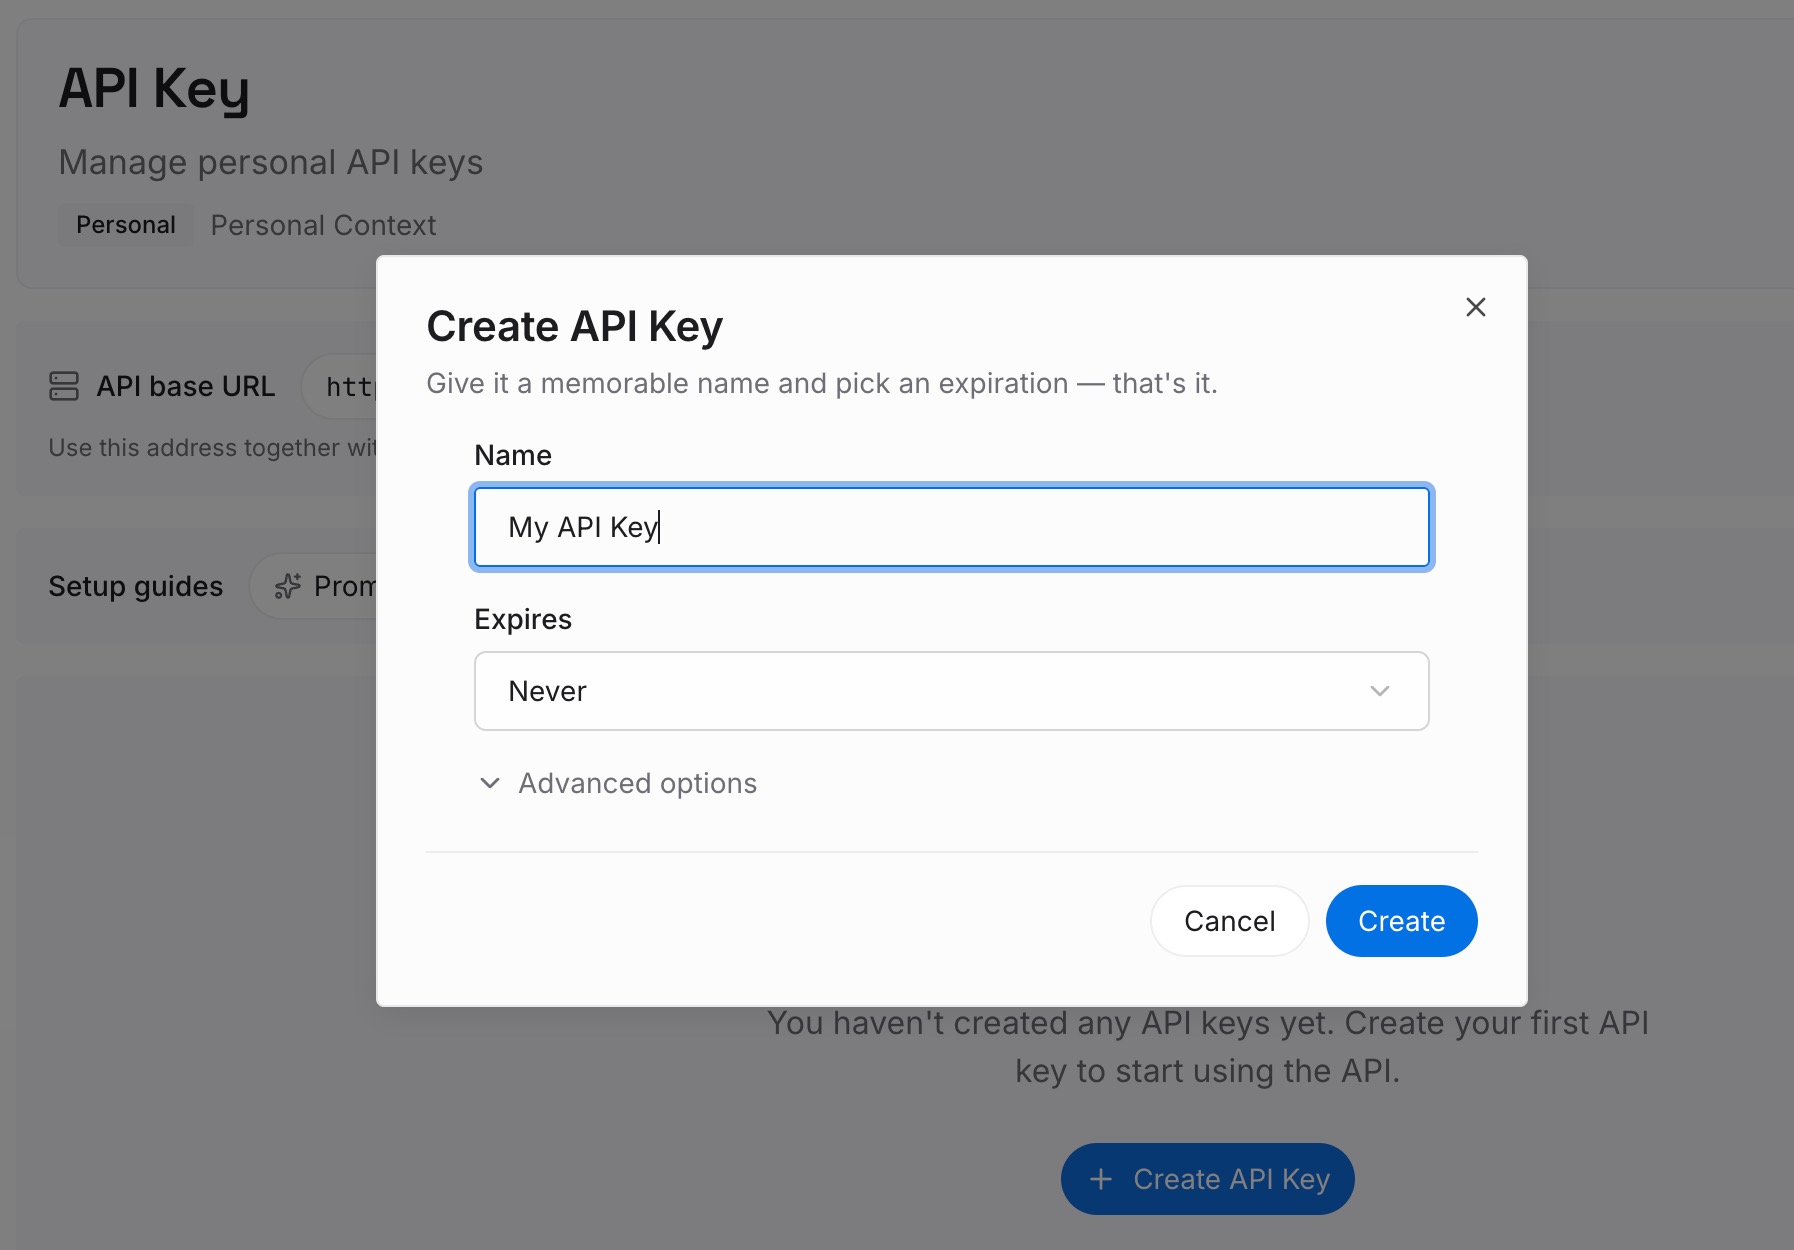
Paso 1: Crea una clave API
Inicia sesión y genera una clave desde el panel de control. La clave pertenece a tu espacio de trabajo en la capa de memoria, de forma independiente a cualquier agente o modelo.
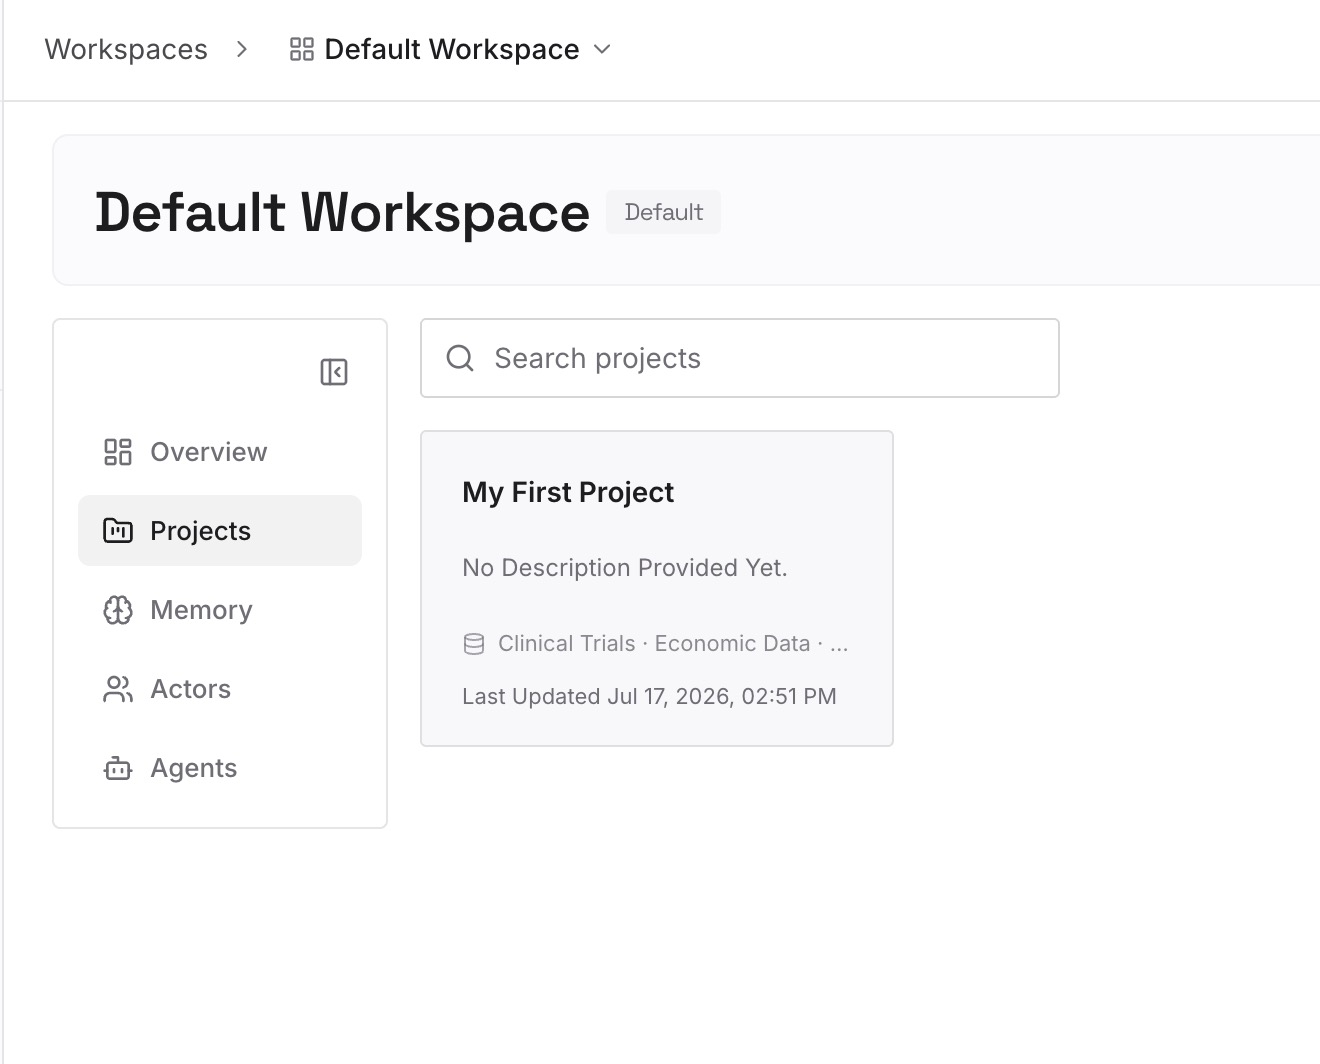
Paso 2: Sube tus primeras memorias
Comienza con el contexto permanente del Paso 1 y las entradas en capas del Paso 2: definiciones, decisiones acordadas, convenciones. Un dato por entrada, con fecha.
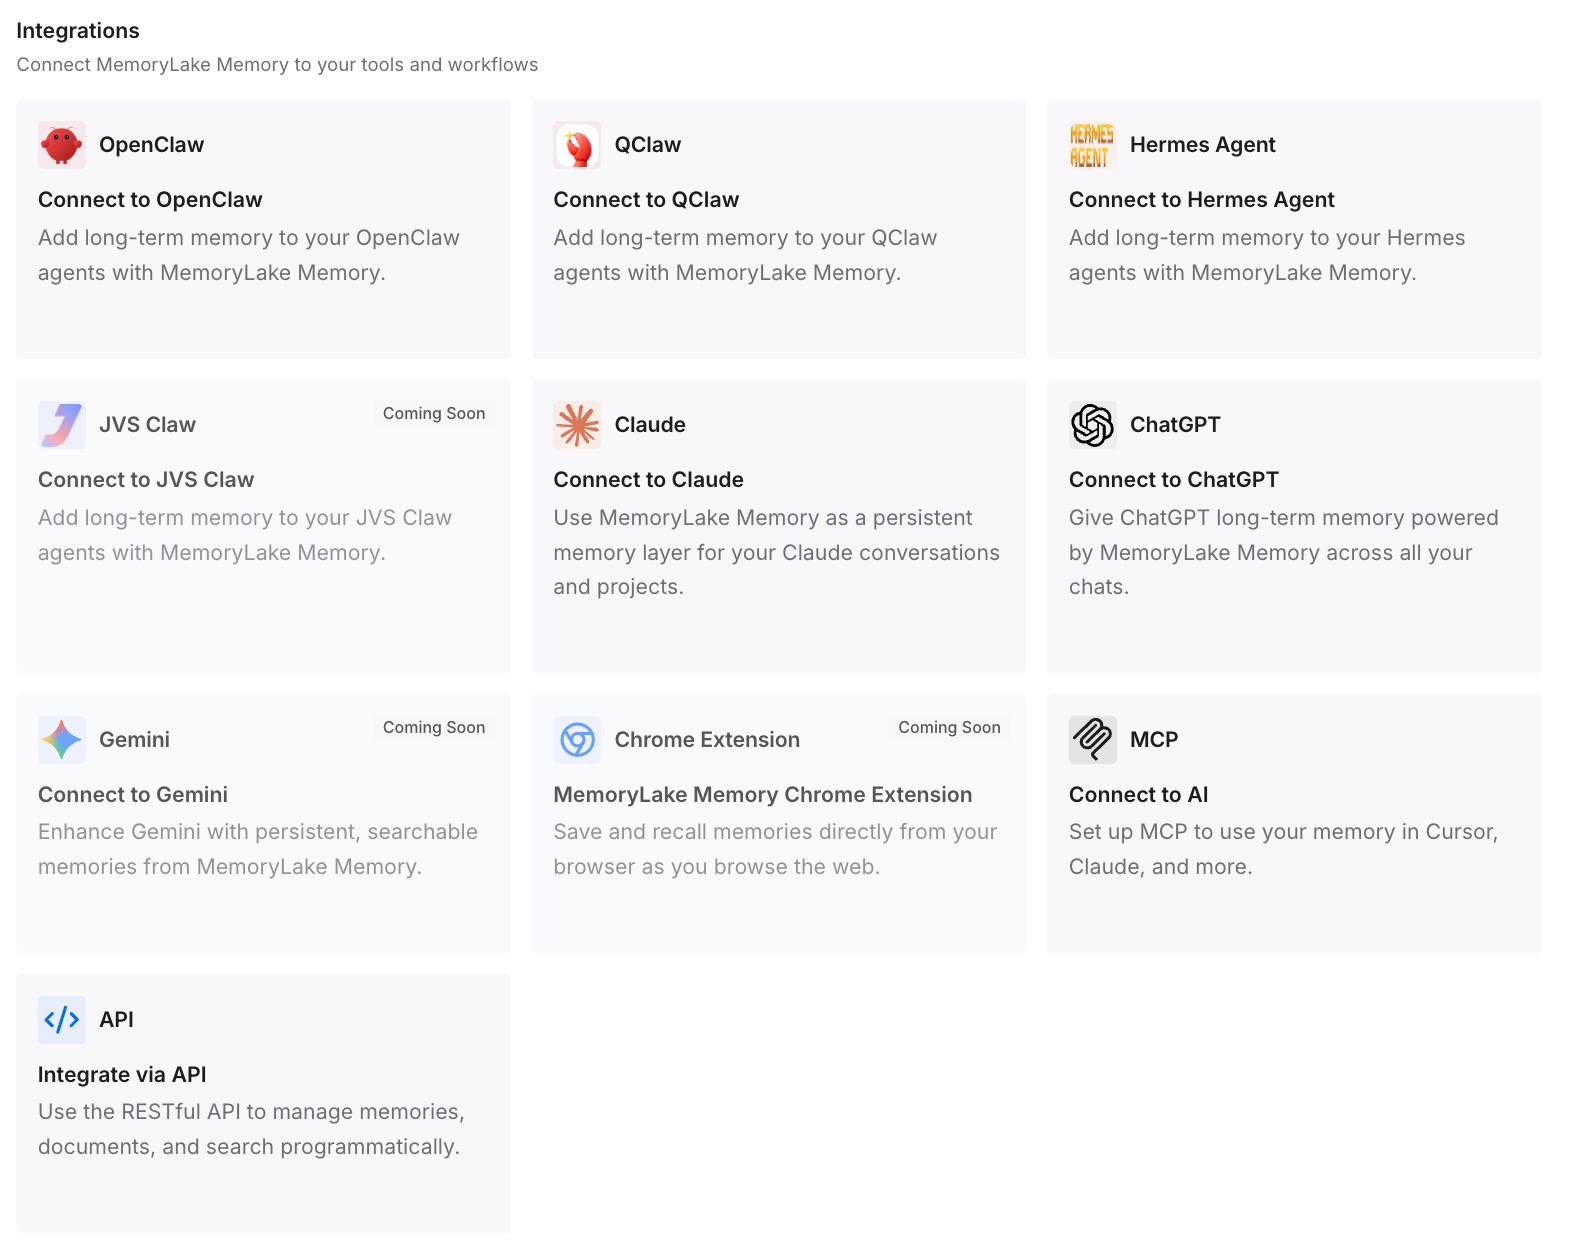
Paso 3: Conecta tu IA y agentes
Conecta los asistentes y agentes que utilizas. Cada uno de ellos podrá recurrir al mismo contexto permanente, superando así la prueba de desacoplamiento por diseño.
Buenas prácticas para la ingeniería de contexto
Trata el contexto como un presupuesto. Cada token compite por la atención del modelo; incluye solo lo que se gane su lugar.
Mantén las herramientas al mínimo y bien diferenciadas. Las herramientas que se superponen crean opciones ambiguas para el agente.
Recupera el contexto de trabajo justo a tiempo. Carga archivos y datos cuando la tarea los necesite, no por adelantado.
Compacta con cuidado. Los resúmenes mantienen el trabajo en marcha, pero pueden omitir detalles cuya importancia aparezca más tarde.
Escribe notas fuera de la ventana. Las notas estructuradas permiten que un agente retome el trabajo donde lo dejó.
Mantén el contexto permanente independiente de cualquier herramienta. La memoria que reside dentro de un solo producto solo ayuda a ese producto. Vale la pena tener en cuenta la distinción entre lo que dijo un agente y lo que hizo, tratada en memoria episódica para agentes de IA, al decidir qué guardar.
Conclusión
La ingeniería de contexto es el sucesor natural de la ingeniería de prompts: el trabajo continuo de decidir qué ve un agente en cada paso, dentro de una ventana que es grande pero finita. El principio de Anthropic lo resume: encontrar "el conjunto más pequeño posible de tokens de alta señal que maximicen la probabilidad de obtener un resultado deseado".
Las técnicas se comprenden bien: compactación, notas estructuradas, subagentes y recuperación justo a tiempo. Lo que está menos definido es dónde debe residir el conocimiento que respalda todo esto. La frase de Alibaba para referirse a ello, "Context is All You Need", viene acompañada de la admisión de que la infraestructura de contexto aún no está estandarizada.
Hasta que lo esté, la regla práctica es sencilla. Diseña el contexto por paso, pero mantén el conocimiento permanente del que se nutre en un solo lugar de tu propiedad, accesible para cada agente que utilices. Para una introducción más amplia a esa capa, consulta qué es la memoria de IA.