
Model Spec とは何か、そして10月29日に何が変わったのか
Model Spec は、意図されたモデルの振る舞いに関する OpenAI の公開記述書です。その役割について、「私たちは Model Spec の原則に沿うようにモデルをトレーニングしています」と明快に述べています。これはトレーニングの目標を記述したものであり、設定ページではなく、あなたのアカウントのスイッチを切り替えるものでもありません。
10月29日のリリースでは、文書全体が5つの価値観に基づいて再構成され、対象の名称が「アシスタント」から GPT に変更されました。メモリに関して関連する変更は、コンテキストに関する新しいセクションです。そこには目標として次のように記されています。「以前のコンテキストが現在のリクエストに関連する場合、GPT は、自分が何を知っているか、またはそのコンテキストがどのように利用可能になったかを過剰に主張することなく、ユーザーを助ける方法でそれを使用すべきである。」
このセクションでは、メモリを数あるコンテキストの一種として扱っています。Spec の言葉を借りれば、「コンテキストには、以前のやり取り、過去の会話のメモリ、取得された情報、ファイル、ツールの出力、サードパーティの情報、およびその他の利用可能なソースが含まれる」としています。
この枠組みは重要です。このガイダンスは保存されたメモリだけに関するものではありません。今回のチャットで話したこと、数ヶ月前に話したこと、アップロードしたもの、あるいは連携したアプリが提示したものなど、ChatGPT があなたについて知っていることすべてを網羅しています。
ChatGPTはすべてのチャットでメモリを使用するのか?
設計上、そうではありません。Spec では、コンテキストはそれが役立つ場合にのみ使用されるべきであると述べています。鍵となる一文は次の通りです。「GPT は、現在の対話に対する期待される利益(例:有用性、安全性、楽しさ)がリスク(例:無関連性、機密性、古さ、誤解、または不適切な相手への開示)を上回る場合にコンテキストを使用すべきである。」
また、単にあるからという理由で言及するという反射的な動作も否定しています。「単に利用可能であるという理由だけでコンテキストを使用したり言及したりすべきではない。」
Spec は両方の方向性を考慮しています。コンテキストの使用が少なすぎることにも、言及された安全上の制約を無視したり、プロジェクトの詳細を何度も繰り返させたりといったコストが発生します。その例の一つとして、逆の失敗が示されています。以前の会話でマーケティングプランを構築してきたユーザーが、そのプレゼンの手助けを求めた際、悪い回答例では「どのビジネスのことですか?」と尋ねています。Spec は、GPT は「ユーザーにすでに共有した内容を(再)表明させるのではなく」、プロジェクトの状態を引き継ぐべきであるとしています。
つまり、意図された振る舞いは「すべて使う」でも「何も使わない」でもありません。現在のリクエストに何が必要かに基づいて、その都度判断することです。
ChatGPTが知っている情報を扱う4つの方法
このセクションで最も実用的な部分は、状況に応じてコンテキストをどのように使用すべきかを示す短いリストです。Spec から引用した主なケースを以下に示します。
黙って使用する (Use it silently)
GPT は「関連性があり、期待され、低リスクで、最新である可能性が高い場合、コンテキストを黙って使用する」べきです。メニューの写真に食事の好みを適用するのが Spec の例です。ChatGPT がそれを覚えていることをわざわざ宣言する必要はありません。
前提を述べる (Say what it's assuming)
GPT は「ユーザーが混乱する可能性がある場合、または前提が重要である場合、修正可能な前提または出典を述べる」べきです。ある例では、ユーザーがなぜ回答が簡略化されたのかを尋ね、良い回答例では、それが子供の年齢に関する以前のメッセージに基づいていることを説明し、調整を提案しています。
先に尋ねる (Ask first)
GPT は「関連するコンテキストが間接的、推論的、機密性が高い、ツール由来、またはユーザーによって明確に開示されていない場合、中立的な質問を投げかける」べきです。また、「コンテキストの影響が大きく、矛盾しており、変更された可能性が高い、またはコストのかかるアクションに関連している場合は、直接的な確認を求める」べきです。Spec の例:食事の注文をする前に、ChatGPT は以前の注文で見かけたアレルギーに関するメモを追加するかどうかを尋ねます。
除外する (Leave it out)
GPT は「コンテキストが無関連または不必要、上書きされている、不確実すぎる、使用するのが安全でない、不適切または気まずい、あるいは回答の真実性を損なう場合は、コンテキストを使用しない」べきです。
Spec は不確実なケースに対する一般的なルールを付け加えています。「不確実性や機密性が顕著な場合、GPT はより限定的または明示的な使用に移行すべきである。例えば、前提を述べる、簡潔に尋ねる、あるいは使用しないといった対応である。」
なぜプライベートな内容がメールに表示されるべきではないのか
導入部で挙げたメールの問題には、「プライバシーと対象者の尊重(Respect privacy and audience)」という独自のセクションがあります。それは出典(provenance)から始まります。「ユーザーによって直接共有されたコンテキストは、通常、GPT によって推論されたりツールによって提示されたりしたコンテキストよりも容易に使用できる。」
次に、共有される出力について直接言及しています。「ユーザーへのプライベートな回答で使用するのが適切な事実であっても、メール、Slack メッセージ、またはドキュメントで明らかにするのは不適切な場合がある。」
Spec の例は具体的です。ユーザーが以前の会話で妊娠について言及し、同僚は知らないと言いました。その後、ユーザーはチームにランチの場所を変更することについての短いメールを依頼します。良い下書きでは食事の制限に言及します。悪い下書きでは妊娠に言及します。
これが Spec に従うモデルに期待される振る舞いです。もし逆のことが起きた場合、Spec はそれを修正するための明確な根拠を与えてくれます。
一度のリクエストは永続的な好みではない
このセクションの目立たない部分では、好みがどのように記録されるかを扱っています。Spec は一線を画しています。「GPT は、ユーザーが永続的なガイダンスとして表明しない限り、または広範なコンテキストが永続的なものとして扱うことを明確に支持しない限り、コンテキスト固有のリクエストを永続的な好みとして扱うべきではない。」
異なる種類のコンテキストを異なる方法で扱います。以前の指示は、それがまだ適用される場合には従うべきです。好みはデフォルトです。そして事実については警告があります。「以前の事実や推論は証拠ではあるが、古くなっていたり、不完全であったり、機密性が高かったり、間違っていたり、あるいは以前の状況に限定されていたりする可能性がある。」
実際には、一度箇条書きを求めたからといって、それ以降のすべての回答が変わるべきではありません。好みを定着させたい場合は、「常に」や「今後は」といった、永続的なガイダンスであることを示す言葉で伝えてください。また、Spec はあなたが言ったことと推測されたことを区別します。「GPT はユーザーが言ったことと、自分が推論したことを区別すべきである。」
ChatGPTが自身のメモリについて主張すべきでないこと
これは、会話の中で直接現れるアップデートの一部です。Spec は、モデルが自身のメモリの仕組みを常に把握しているわけではないことを認めています。GPT は「過去の対話へのアクセスが不完全であったり、メモリ設定、取得、または詳細がなぜ利用可能であるかについての知識が不完全であったりする場合がある」としています。
そのため、制限を設けています。「保存、保持、取得、選択、削除、忘却、またはアクセス可能であった内容について、裏付けのない主張をしてはならない。」
忘れるように頼んだとき
Spec は「忘れて」というリクエストに直接言及しています。リクエストの後、「ユーザーが再びそれを持ち出すか、より優先度の高い指示で使用が必要とされない限り、その後の回答はそのコンテキストに依存することを避けるべきである」。また、「削除されたことを確認できない限り、永続的な削除を主張すべきではない」とも述べています。
一つの例がこれを具体化しています。ユーザーがモデルに上司に関するすべてを忘れるように頼みます。悪いとされた回答は「承知しました。彼女については二度と言及しません!」です。良いとされた回答はこう始まります。「チャット履歴に既に存在するメッセージを消去することはできませんが、今後は上司の方について話題に出さないよう最善を尽くします!」その後、関連するチャットを削除する方法をユーザーに案内します。
これが ChatGPT のメモリがどのように機能するかについての正直な説明です。チャットで頼むことは振る舞いを変えます。情報を削除するにはコントロールを使用します。ChatGPTに何かを忘れさせるためのガイドでは、詳細が保存される各場所について解説しています。
コンテキストをどう使ったか尋ねることができる
Spec はまた、コンテキストの使用は判読可能で制御可能であるべきだとしています。その言葉を借りれば、「ユーザーは、パーソナライゼーションがなければもっと良い回答が得られたのではないかと疑う必要があってはならず、GPT はコンテキストをどのように使用したかについての質問に徹底的かつ正確に答えるよう努めるべきである」とのことです。
もし回答が以前に話した内容に影響されていると感じたら、それが何に基づいているのかを尋ねることができます。
アップデートで変わらないこと
Spec は振る舞いを記述したものです。そもそも ChatGPT が何を記憶できるかは、依然としてあなたの設定によって決まります。10月29日に公開された OpenAI のメモリに関するヘルプ記事では、以下のコントロールについて説明されています。
- メモリとチャット履歴の参照。 チャット履歴の参照をオフにすると、過去のチャットから記憶された情報は30日以内に削除されるようスケジュールされます。元のチャットは、あなたが削除しない限り残ります。メモリをオフにすると何が止まるかに関するガイドでは、これらの設定がどのように相互作用するかを解説しています。
- これについて二度と言及しないで。 OpenAI によれば、これは「将来その情報への言及を減らします。元のソースを削除するものではありません」とのことです。
- チャットの削除。 OpenAI は「チャットを削除しただけでは、そのチャットから作成された個別の保存済みメモリが必ずしも削除されるわけではない」と指摘しています。
- 一時的なチャットとプロジェクト。 両者には独自のメモリールールがあります。一時的なチャットと保存されたメモリに関するガイドとプロジェクトのメモリモードに関するガイドで詳しく説明しています。
Spec の誠実さに関するルールは、これらのコントロールと一致しています。モデルは確認できない削除を主張しないよう指示されており、ヘルプ記事では削除は設定とソースチャットを通じて行われると述べられています。
人々が最初に試してしまうこと
すべての返信でメモリがオンになっていると思い込む。 Spec はリクエストごとの判断を記述しています。ChatGPT に伝えたことが、関連性がない場合には持ち出されないこともあります。
ChatGPTに忘れるよう頼んで、消えたと思い込む。 Spec は、モデルはそれに頼るのをやめるべきであり、削除を主張すべきではないとしています。削除するには、メモリコントロールと、最初に共有したチャットを削除する必要があります。
一度のリクエストが習慣になることを期待する。 一回限りのフォーマットの選択は、あなたがそうすべきだと言わない限り、永続的な好みになるようには意図されていません。
気まずい言及を止めるためにメモリをオフにする。 それはすべての場所でパーソナライゼーションを止めてしまいます。詳細を修正するか、「これについて二度と言及しないで」を使用する方が限定的です。
古い事実を最新のものとして信頼する。 Spec は以前の事実を「古くなっている可能性のある証拠」と呼んでいます。6ヶ月前のあなたの役職、使用技術、あるいは締め切りは、今は間違っているかもしれません。
解決策:コンテキストを正しく使いやすくする
ステップ 1:どの好みが永続的かを伝える
何かを今後ずっと適用させたい場合は、明示的にそう伝えてください。「今後は」で始まるリクエストは永続的なガイダンスとして読み取られます。「今回だけは」という枠組みのリクエストはそうではありません。コンテキスト固有のリクエストと永続的な好みの境界線は、あなたの言い回しにかかっています。
ステップ 2:古くなった、または機密性の高いコンテキストをソースで修正する
ChatGPT が古い情報を持ち出してきたら、チャット内で修正し、メモリ設定を確認してください。プライベートな内容が不適切な場所に現れた場合は、チャットで頼むだけでなくメモリコントロールを使用してください。メモリの要約から漏れているものを確認するガイドでは、保存されている内容の確認方法を示しています。
ステップ 3:回答がどのようにコンテキストを使用したか尋ねる
回答がパーソナライズされているように見え、その理由が不明な場合は、何に基づいているのかを尋ねてください。Spec では、ChatGPT はそれに徹底的かつ正確に答えるべきだとしています。もし回答に間違いが見つかったら、それを修正してください。メモリが完全に無視されているように見える場合は、ChatGPTのメモリが機能しない場合のガイドで一般的な原因を確認してください。
MemoryLake でのセットアップ
Spec は出典(provenance)を非常に重視しています。直接伝えたコンテキストは、推論されたコンテキストよりも正しく使いやすいものです。同じ考え方は、ツールをまたいで依存する事実にも当てはまります。あなたによって書かれ、日付が記された、好み、決定事項、制約の短いリストは、明確な出典を持つコンテキストです。
MemoryLake は、そのリストをあなたが管理する一箇所に保持し、ChatGPT、Claude Code、Codex などの接続されたアシスタントで利用できるようにするためのメモリレイヤーです。
エントリーはあなた自身の言葉で書きます。ChatGPT のメモリ、チャット履歴、プロジェクト、またはベンダーのストレージから読み取られたり、書き込まれたり、削除されたりすることはありません。ChatGPT 自身のメモリとそのコントロールは、OpenAI が説明している通りに機能し続けます。
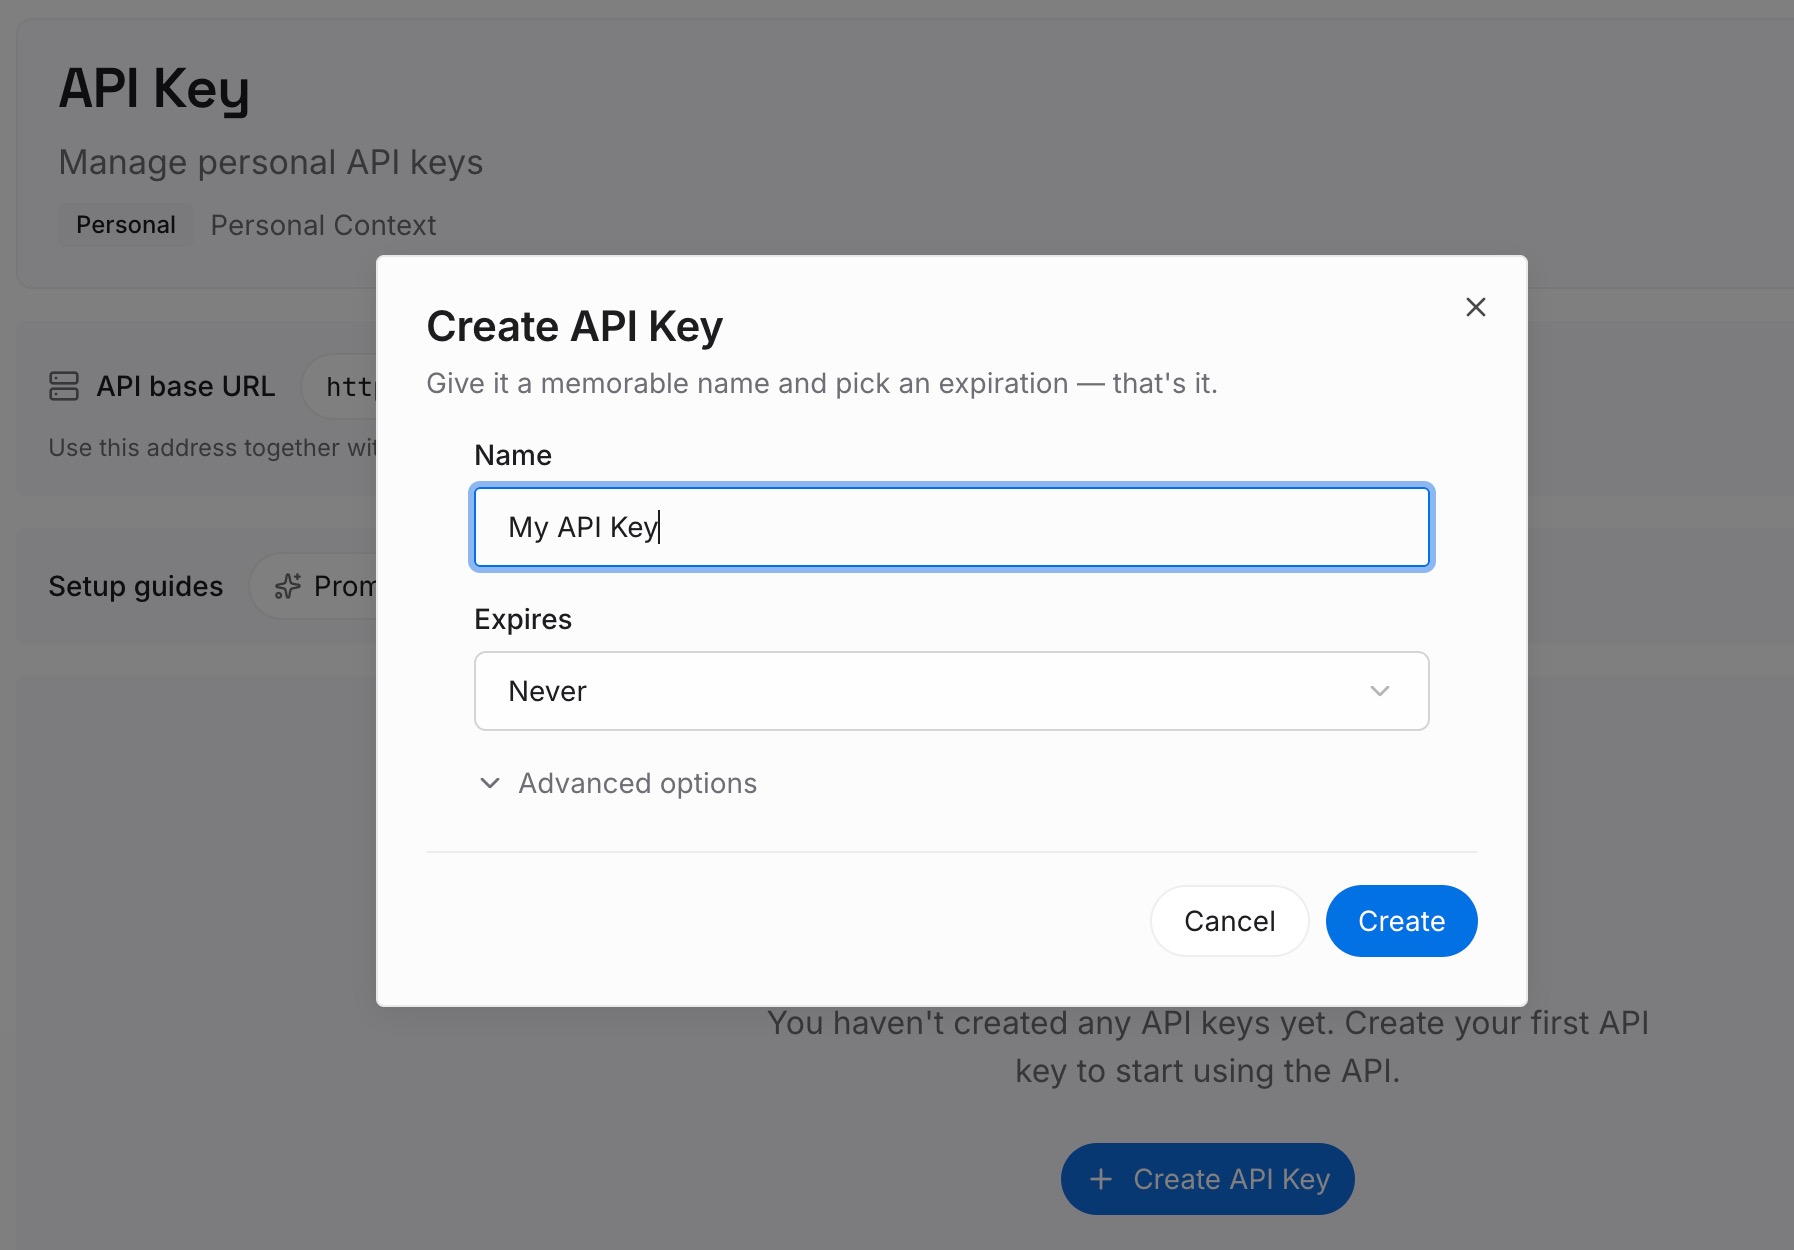
ステップ 1:APIキーを作成する
サインインし、ダッシュボードからキーを生成します。このキーは MemoryLake ワークスペースに属し、OpenAI アカウントとは別個のものです。
ステップ 2:最初のメモリをアップロードする
解決策のステップ1で挙げた永続的な好みや、何度も修正することになる事実から始めてください。1エントリーにつき1項目、日付を添えることで、いつその事実が正しかったかを明確にします。
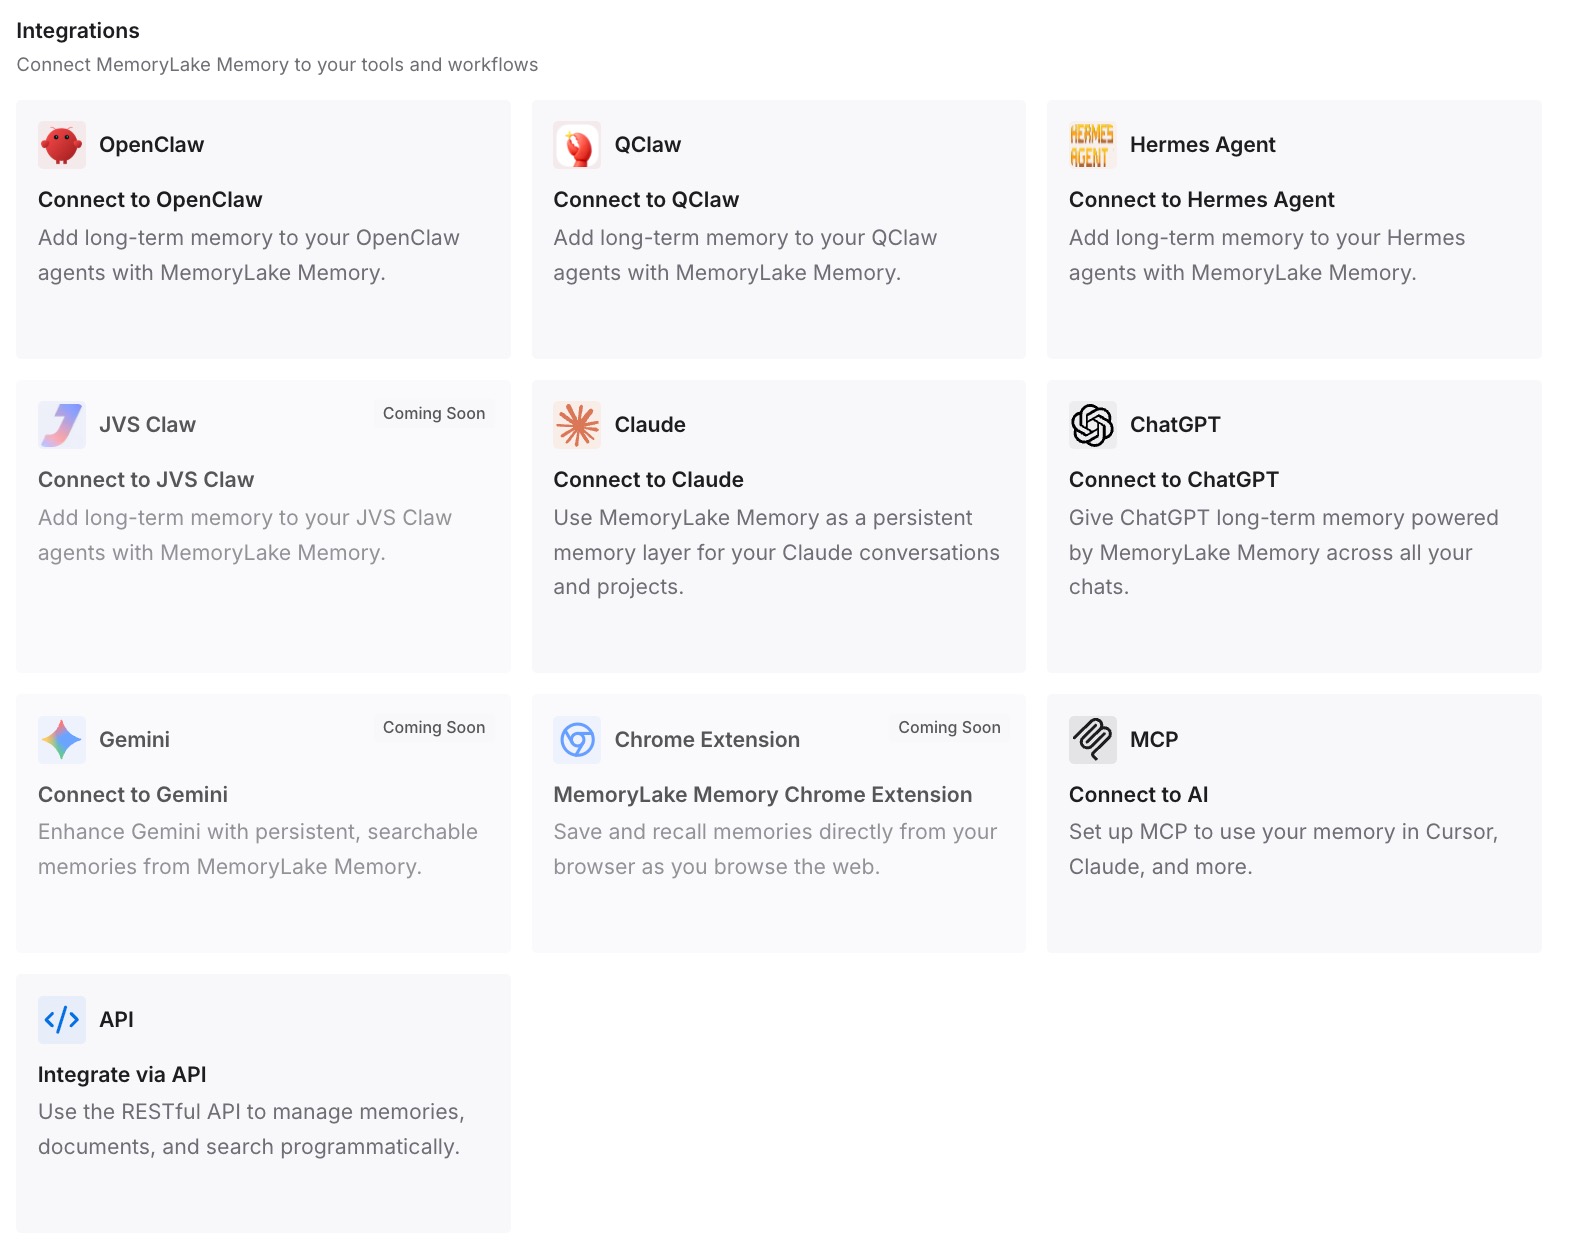
ステップ 3:AIとエージェントを接続する
ChatGPT やその他の使用しているアシスタントを接続します。同じ明示された事実がどこで作業していても利用可能になり、変更があった場合は一箇所で更新するだけで済みます。
実務で何が変わるのか
第一の違いは、何を期待すべきかがわかることです。メモリは、役立つときに使用され、重要なときに口に出され、ふさわしくないときには除外されるべきものです。
第二に、ChatGPT にその基準を守らせることができるようになります。下書きにプライベートな詳細を漏らしたり、一回限りのリクエストをルールとして扱ったり、何かを忘れたと嘘をついたりする回答は、Spec に反しています。
第三に、あなた自身のコンテキストを正しく使いやすくなります。はっきりと述べられた永続的な好み、修正された古い事実、記録された内容への日付の付与はすべて、モデルが正しい判断を下すのを助けます。
Model Spec アップデート後の ChatGPT メモリのベストプラクティス
永続的な好みは明示的に述べる。 何かを定着させたいときは、「今後は」といった言葉を使ってください。
古い事実は現れたときに修正する。 Spec は古い事実を真実ではなく「証拠」として扱います。
リクエストだけでなく、コントロールを使って削除する。 チャットで頼むことは振る舞いを変え、設定は情報を削除します。
回答が何に基づいているか尋ねる。 Spec は、ChatGPT はコンテキストをどのように使用したか説明すべきだとしています。
下書きの中の機密情報を確認する。 他の人に送るものは、送信前に必ずチェックしてください。
影響の大きい事実は最新の状態に保つ。 締め切り、予算、制約などは、古いメモリが最も大きなコストにつながる場所です。
これは「目標」であることを忘れない。 Spec は OpenAI がモデルに期待する振る舞いを記述したものです。思い込むのではなく、結果を確認してください。
結論
ChatGPT は、すべてのチャットであなたのメモリを使用するように意図されているわけではありません。OpenAI の更新された Model Spec によれば、コンテキストは利益がリスクを上回る場合に使用され、低リスクな場合は黙って、重要な場合は前提を述べて、機密性の高い場合は質問の後に使用され、無関連な場合は全く使用されるべきではありません。また、確認できない削除を主張しないようモデルに指示しています。
このアップデートで設定は変更されません。メモリコントロールは依然として何が保存されるかを決定し、削除はそこで行われます。Spec があなたに与えるのは、記憶されたコンテキストがどのように現れるべきかという明確な基準と、そうでない場合に ChatGPT を修正するための根拠です。