
11월 2일에 변경된 사항
Threads 도입 전에는 모든 Messages API 요청에 전체 대화 내용이 포함되어야 했습니다. 발표 자료에서는 그 비용을 다음과 같이 설명합니다. "코딩 에이전트는 한 세션에서 수백 개의 요청을 보낼 수 있으며, 각 요청은 이전의 모든 메시지와 도구 결과를 다시 전송합니다."
스레드를 사용하면 Messages API 요청에 thread라는 매개변수 하나만 추가하면 됩니다. 문서는 이 패턴을 세 단계로 설명합니다.
- 생성(Create). 첫 번째 요청에는 전체 대화,
system,tools와 함께 create 타입의thread필드가 포함됩니다. "API는 Claude의 응답을 포함한 대화를 응답id아래에 저장합니다." - 계속(Continue). "이전 응답 이후의 메시지만 전송"합니다. 또한 이전 응답의
id를 전달하며, 스레드가 생성 요청의 값을 유지하므로system과tools는 제외합니다. - 재생(Replay). 스레드를 계속할 수 없는 경우, 새로운 생성 요청에 전체 대화를 다시 보냅니다.
Threads는 네이티브 Claude Platform, AWS 기반 Claude Platform, Microsoft Foundry의 Claude, Google Cloud의 Claude 모델(Anthropic 관리형)에서 사용할 수 있습니다. Anthropic은 "표준 Claude 토큰 요율 및 기존 속도 제한이 적용됩니다"라고 명시했습니다.
서버가 보관하는 내용 및 기간
문서의 요약은 다음과 같습니다. "Message thread는 서버에 대화를 짧은 시간 동안 유지합니다."
마지막 요청 후 5분. "스레드는 최선형(best-effort) 서비스입니다. 마지막 요청 후 5분이 지나면 만료되며, 마지막 사용 후 1시간 이내에 API에서 삭제됩니다. API가 저장하는 각 응답은 5분의 시간을 재시작합니다."
디스크가 아닌 메모리에 저장. 발표 내용에 따르면 "턴 사이에 각 스레드를 메모리에 보관하며, 암호화되어 디스크에 기록되지 않습니다." 데이터 보존 섹션에서는 API가 "내구성이 있는 저장소에 절대 기록하지 않는다"고 덧붙였습니다.
내부를 볼 수 없음. 제한 사항 목록은 단호합니다. "스레드를 나열, 읽기 또는 삭제하는 API는 없습니다."
호출자에 종속됨. 계속 요청이 실패하는 이유 중 하나로 문서는 "다른 조직 또는 워크스페이스"의 요청, 그리고 "스레드를 생성한 사용자와 다른 사용자 또는 서비스 계정"의 요청을 나열합니다.
즉, 서버는 단일 호출자를 위해 단일 대화를 몇 분의 비활성 시간 동안만 확장 가능한 형태로 유지합니다. 이는 빠른 에이전트 루프에는 유용하지만, 내일 다시 돌아올 수 있는 기록은 아닙니다.
스레드가 메모리가 아닌 이유
Anthropic은 해당 페이지에서 가장 중요한 지침을 통해 이 질문에 답합니다. "귀하의 애플리케이션이 대화의 신뢰할 수 있는 단일 소스(Source of Truth)로 유지되어야 합니다. 모든 메시지의 자체 복사본을 보관하고, 처음부터 재생 경로(Replay path)를 구축하십시오."
또한 왜 복사본을 생략할 수 없는지도 설명합니다. "생성 또는 계속 요청에 대한 어떤 응답도 API가 해당 턴을 저장했는지 여부를 알려주지 않습니다. 다음 계속 요청 때 알게 됩니다." 스레드는 제어할 수 없는 이유로 사라질 수 있습니다. 문서에는 "스레드 만료", API가 턴을 저장하지 않고 처리한 경우, 폴백 모델이 이전 응답을 작성한 경우 등 여러 이유가 나열되어 있습니다.
이를 Anthropic이 정보를 유지하기 위해 설명하는 도구들과 비교해 보십시오. 메모리 도구는 "애플리케이션에서 메모리 도구의 파일 작업을 구현하여 Claude가 대화 전반에 걸쳐 정보를 저장하고 검색할 수 있도록 하는 방법"으로 문서화되어 있습니다. 데이터 보존 노트에서는 이를 "데이터 보존을 사용자가 제어하는 클라이언트 측 메모리 저장소"라고 부릅니다. 지속되는 것은 사용자가 운영하는 저장소인 사용자 측에 있습니다.
이름 또한 오해를 불러일으킬 수 있습니다. 문서에는 다음과 같은 참고 사항이 있습니다. "Message threads는 Claude Managed Agents의 세션 스레드와 다릅니다." 세션 스레드는 Managed Agents 세션에 속하며, Anthropic은 이를 "상태 저장 리소스이며 삭제할 때까지 대화 내용이 유지됩니다"라고 설명합니다. 단어는 같지만 수명은 다릅니다.
긴 컨텍스트 창이 메모리가 아닌 이유에 대한 가이드에서 모델이 단일 요청에서 보유할 수 있는 것과 요청 사이에 유지하는 것 사이의 더 넓은 차이점을 다룹니다.
압축 시 새 스레드를 시작해야 하는 이유
긴 에이전트 세션은 결국 압축(Compaction)이 필요합니다. 대화가 컨텍스트에 맞도록 오래된 턴을 요약으로 대체하는 것입니다. Threads는 이 방식을 바꿉니다.
"스레드는 추가 전용(Append-only)이므로 이전 턴을 요약으로 대체할 수 없습니다. 대화를 압축하려면 요약본으로 새 스레드를 시작하십시오. 코드에서 요약을 작성하고, system 및 tools와 함께 새 생성 요청에 일반 메시지로 보내십시오."
서버 측 옵션도 사용할 수 없습니다. "Threads에서는 온디맨드 압축을 사용할 수 없습니다." thread를 포함하고 압축을 요청하는 요청은 400 에러를 반환합니다. 컨텍스트 편집도 마찬가지입니다. thinking-block 설정을 제외하고 Threads는 이를 지원하지 않습니다.
실제로 Threads를 사용하는 긴 세션은 체인과 같습니다. 대화 압축이 필요할 때까지 하나의 스레드가 실행되고, 코드가 요약을 작성하면 그 요약에서 새 스레드가 시작됩니다. 매번 이전 스레드는 몇 분 내에 만료됩니다. 앞으로 전달되는 것은 요약에 넣은 내용과 자체적으로 보관한 메시지 복사본뿐입니다.
편집에도 동일한 규칙이 적용됩니다. "이전 메시지를 편집하거나 분기하려면 생성 요청으로 새 스레드를 시작하십시오." system이나 tools를 변경하는 것도 계속 요청에서 제외되므로 새 스레드가 됩니다.
압축된 Claude Code 세션 텔레포팅 가이드는 대화가 압축된 후 요약이 전달하는 것과 전달하지 않는 것을 보여줍니다.
Threads가 하지 않는 다른 기능들
문서에는 Threads와 결합되지 않는 기능들이 나열되어 있습니다. 에이전트 빌더에게 중요한 몇 가지는 다음과 같습니다.
- 프롬프트 캐싱이 자동이 아닙니다. "스레드는 프롬프트를 대신 캐싱해주지 않습니다." 여전히 캐시 중단점(breakpoints)을 설정해야 하며, 최상위
cache_control이 매 턴마다 캐싱을 요청해야 합니다. - 배치(Batches) 및 토큰 카운팅.
thread가 포함된 배치 항목은 실패하며,thread가 포함된 토큰 카운팅 요청은 400 에러를 반환합니다. Anthropic은 대신 전체 대화의 토큰을 계산하라고 조언합니다. - 일부 조직. HIPAA 준수가 활성화되었거나 유추 후크(Inference hooks)가 켜져 있는 조직에서는 Threads를 사용할 수 없습니다.
요청이 Threads에서 지원하지 않는 기능을 사용하는 경우, API는 thread_unsupported_request 코드와 함께 400 에러를 반환하며, 문서는 다음과 같이 조언합니다. "인식하지 못하는 값이 반환되면 thread 없이 전체 대화를 보내십시오."
데이터 보존 및 제로 데이터 보존(ZDR)
데이터 보존 요구 사항이 있는 팀의 경우, 기능 메타데이터에 명시되어 있습니다. "Message threads는 ZDR 대상이 아닙니다. 이 기능을 사용해도 다른 ZDR 대상 기능의 사용에는 영향을 미치지 않습니다."
전체 참고 사항은 다음과 같습니다. "스레드 내용(대화, 시스템 프롬프트, 도구)은 메모리에 보관되고 서버 관리 키로 암호화되며, 내구성이 있는 저장소에 기록되지 않고 스레드의 마지막 사용 후 1시간 이내에 삭제됩니다."
조직이 제로 데이터 보존(Zero Data Retention)에 의존하는 경우, Threads를 활성화하기 전에 해당 정책 담당자에게 확인하십시오. SDK는 스레드 없는 요청으로 폴백할 수 있으며, 이는 문서의 복구 섹션에서 다루고 있습니다.
Claude Code를 사용하는 경우
발표 자료에는 Claude Code가 한 줄 언급되어 있습니다. "대부분의 Claude Code 사용자에게 Message threads가 기본으로 활성화됨"이라는 문구와 함께 긴 요청에 대한 지연 시간 수치가 이어집니다.
이로 인해 요청이 전달되는 방식은 바뀌지만, Claude Code 기록이 저장되는 위치는 바뀌지 않습니다. Claude Code 문서는 여전히 다음과 같이 명시합니다. "Claude Code는 세션을 ~/.claude/projects/<encoded-cwd>/*.jsonl 아래에 저장합니다." 이러한 로컬 트랜스크립트가 /resume이 읽는 내용이며, 자동 메모리는 디스크의 자체 폴더에 유지됩니다. 우리가 확인한 Claude Code 문서 페이지에는 Message threads에 대한 설정 설명이 없습니다.
Anthropic은 자리를 비운 사이 스레드가 만료되었을 때 Claude Code가 이를 어떻게 처리하는지 설명하지 않습니다. API에서 문서화된 만료 후 경로는 재생(Replay)입니다. 즉, 다음 요청이 전체 대화를 다시 보내고 새 스레드를 시작하는 것입니다. Claude Code 세션 간 컨텍스트 공유 가이드에서는 세션 간에 지속되는 부분을 다룹니다.
사람들이 흔히 하는 실수
스레드 ID를 대화 ID로 취급하는 것. 스레드는 마지막 요청 후 몇 분 만에 만료됩니다. 자체적인 대화 ID와 메시지를 저장하십시오.
클라이언트 측 복사본을 삭제하는 것. 문서는 어떤 응답도 턴이 저장되었는지 알려주지 않는다고 말합니다. 복사본이 없으면 재생할 수 없습니다.
스레드에서 압축을 호출하는 것. 400 에러를 반환합니다. 코드에서 압축하고 요약본으로 새 스레드를 시작하십시오.
스레드가 프롬프트를 캐싱할 것이라 기대하는 것. 캐싱에는 여전히 직접 설정한 중단점이 필요합니다.
ZDR 설정이 스레드에도 적용된다고 가정하는 것. Threads는 ZDR 대상이 아닙니다.
스레드를 다시 읽을 방법을 찾는 것. Anthropic의 표현을 빌리자면, 스레드를 나열, 읽기 또는 삭제하는 API는 존재하지 않습니다.
해결책: 기록을 사용자 측에 보관하기
1단계: 메시지를 보내기 전에 모든 메시지 저장하기
직접 제어하는 저장소에 system 및 tools를 포함한 대화 복사본을 보관하십시오. 이를 사용하여 404 에러 시 재생하고 스레드 만료 후 복구하십시오. Anthropic은 "SDK 스레드 헬퍼는 헬퍼 객체가 존재하는 동안 이 복사본을 메모리에 유지하며 다른 곳에는 저장하지 않는다"고 언급하므로, 프로세스가 재시작될 수 있다면 복사본을 내구성 있는 곳에 기록하십시오.
2단계: 새 스레드로 압축하기
대화가 길어지면 코드에서 요약을 작성하고, 이를 포함한 생성 요청으로 새 스레드를 시작하며, 전체 기록은 자체 저장소에 유지하십시오. 요약에 반드시 포함되어야 할 내용을 미리 결정해 두십시오.
3단계: 지속적인 사실을 대화 외부에 보관하기
사용자나 프로젝트에 대한 결정, 컨벤션, 사실들이 단일 대화의 생존 여부에 의존해서는 안 됩니다. 각 새 스레드가 시작될 때 에이전트가 로드할 수 있는 곳(예: 자체 저장소 기반의 메모리 도구 또는 리포지토리의 파일)에 보관하십시오. Claude Code에서는 CLAUDE.md와 자동 메모리가 그 역할을 합니다. Claude Code 자동 메모리 가이드에서 각 세션 시작 시 로드되는 내용을 설명합니다.
MemoryLake에서 설정하기
Threads는 활성 턴을 더 빠르게 만듭니다. 하지만 세션, 압축, 도구 전반에 걸쳐 에이전트가 필요로 하는 사실들은 5분간의 정적 상태 후에도 만료되지 않는 보금자리가 필요합니다.
MemoryLake는 이러한 사실들을 직접 관리하는 한 곳에 보관하여 ChatGPT, Claude Code, Codex 등 연결된 어시스턴트가 사용할 수 있게 해주는 메모리 레이어입니다.
사용자는 자신의 언어로 직접 항목을 작성합니다. 메시지 스레드, API 대화, Claude Code 세션, 메모리 도구 파일 또는 벤더의 저장소에서 아무것도 읽거나 쓰거나 삭제하지 않습니다. Message threads는 Anthropic이 설명한 방식 그대로 계속 작동합니다.
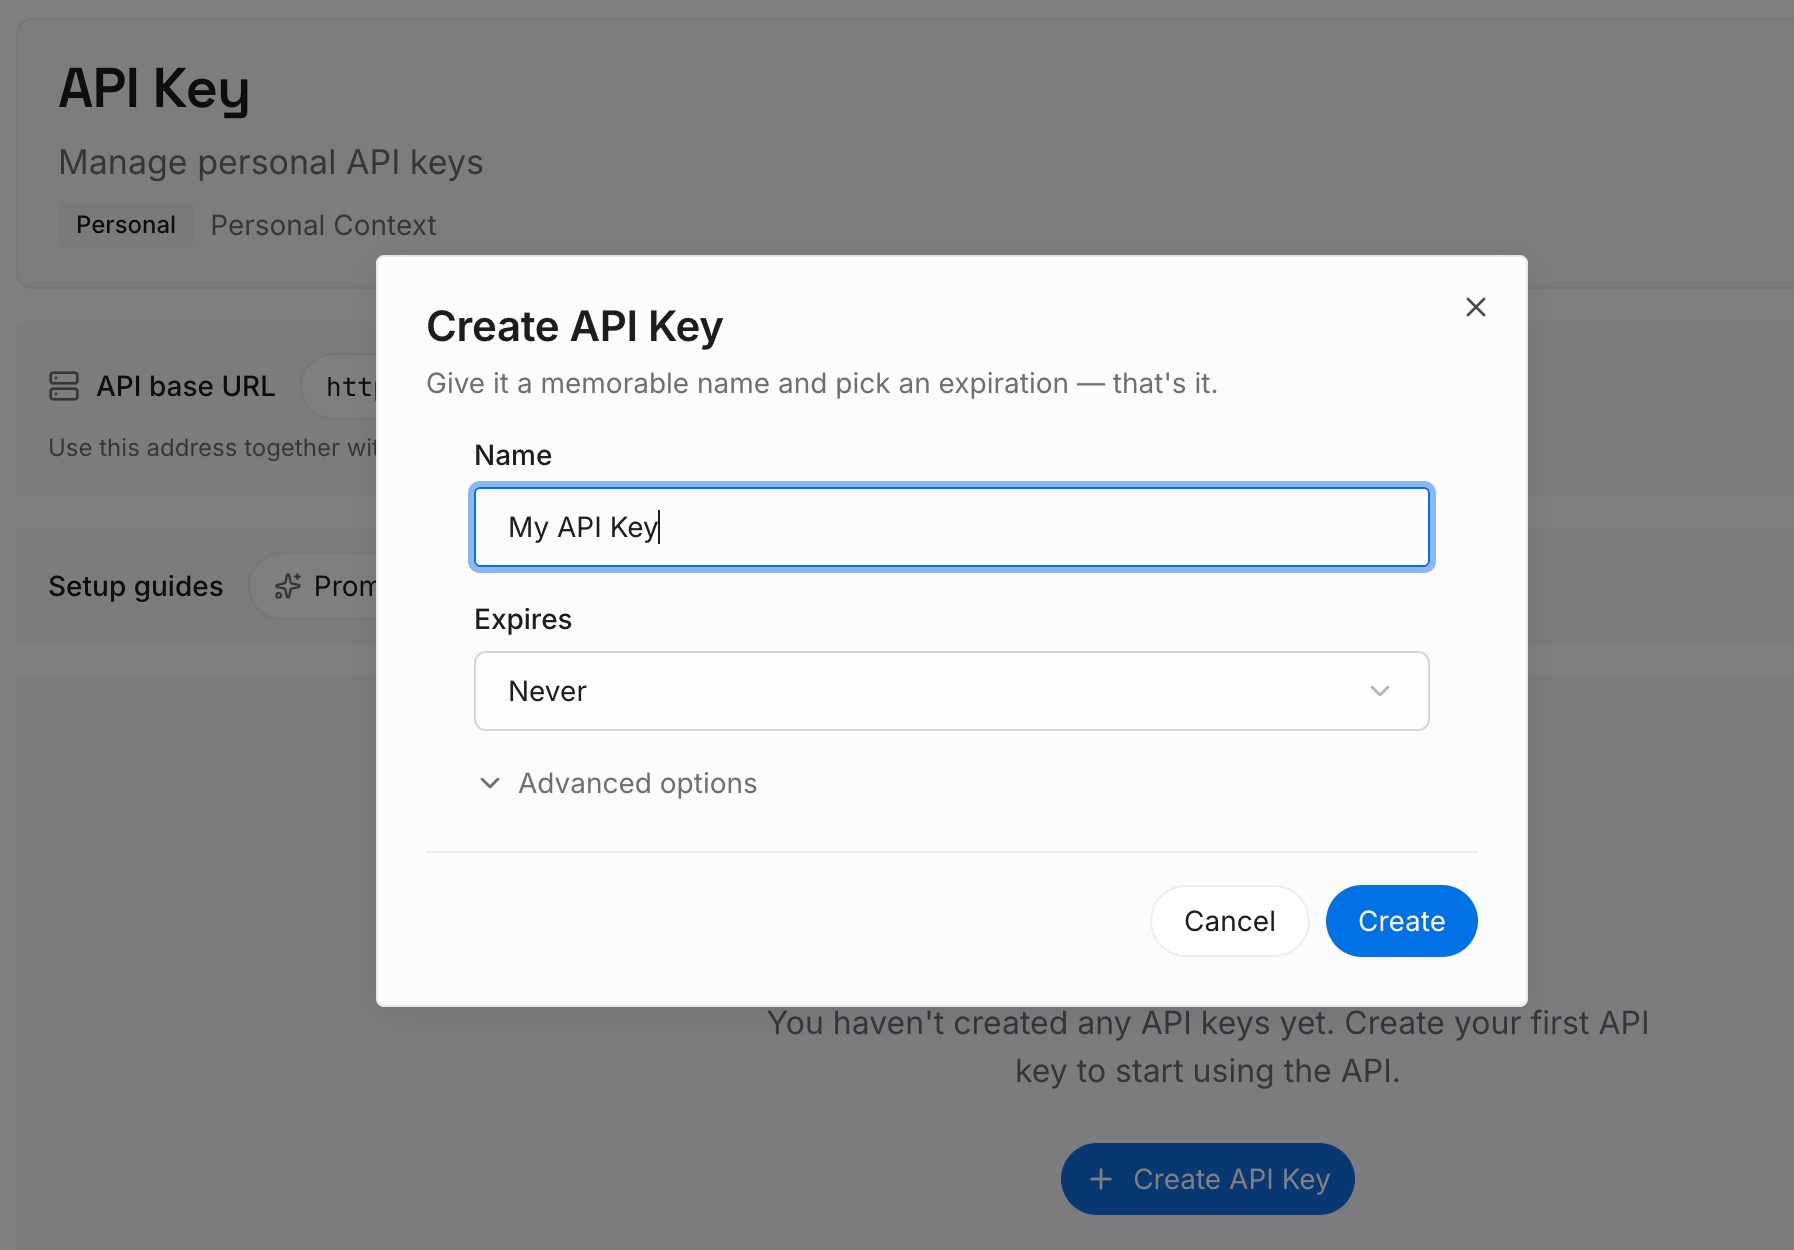
1단계: API 키 생성
로그인 후 대시보드에서 키를 생성합니다. 이 키는 MemoryLake 워크스페이스에 속하며 Claude Platform 키와는 별개입니다.
2단계: 첫 번째 메모리 업로드
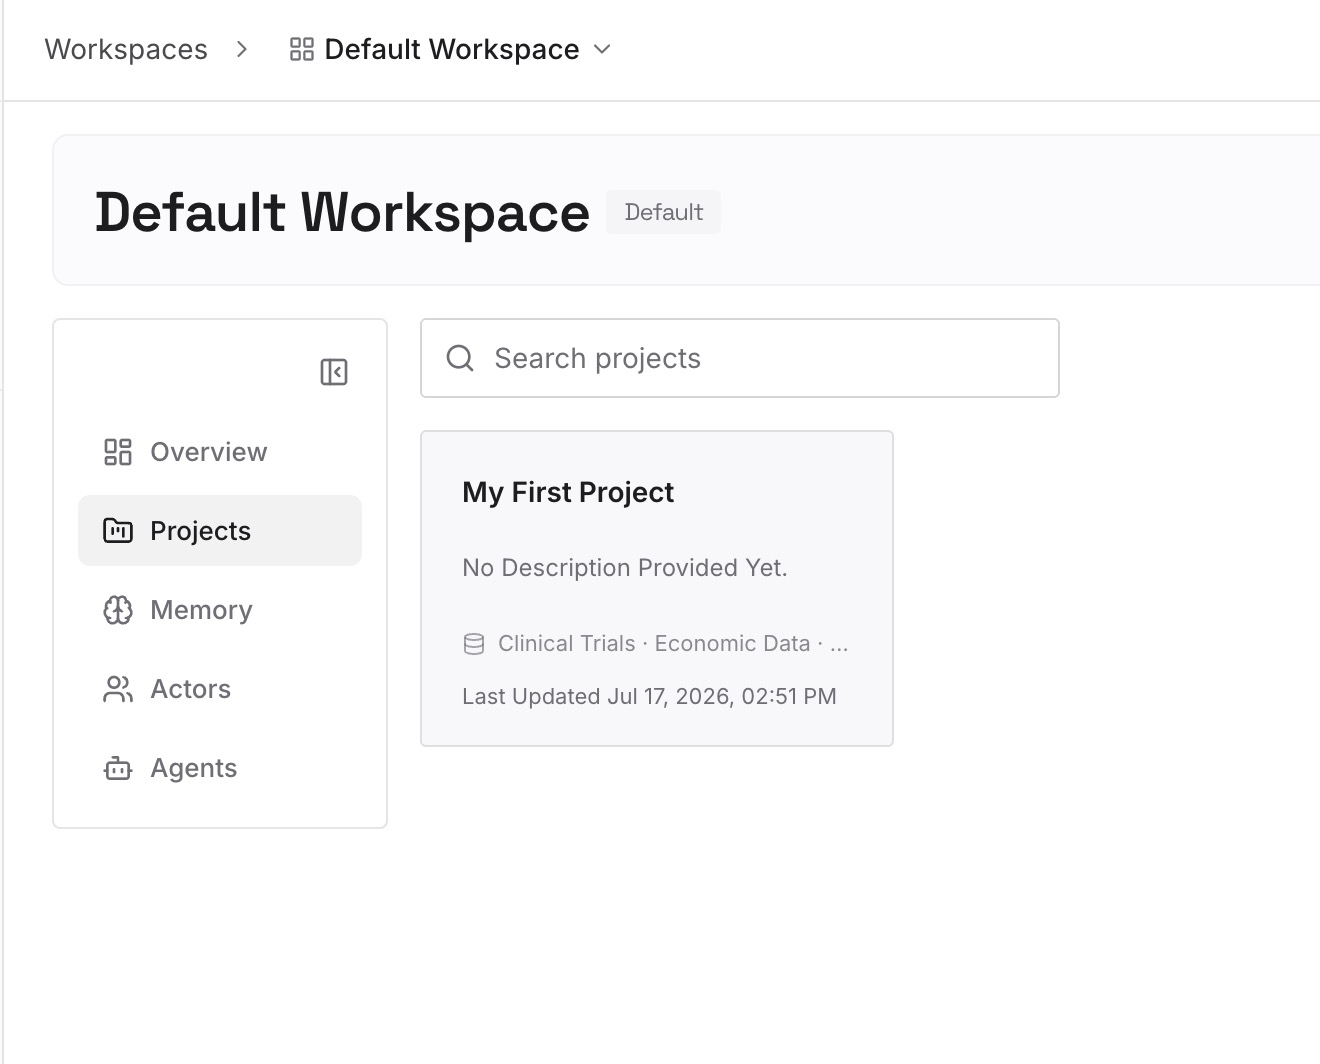
각 새 스레드가 첫 번째 턴부터 알아야 할 내용(프로젝트 결정 사항, 제약 조건, 컨벤션)으로 시작하십시오. 항목당 한 점씩, 날짜를 기입합니다.
3단계: AI 및 에이전트 연결
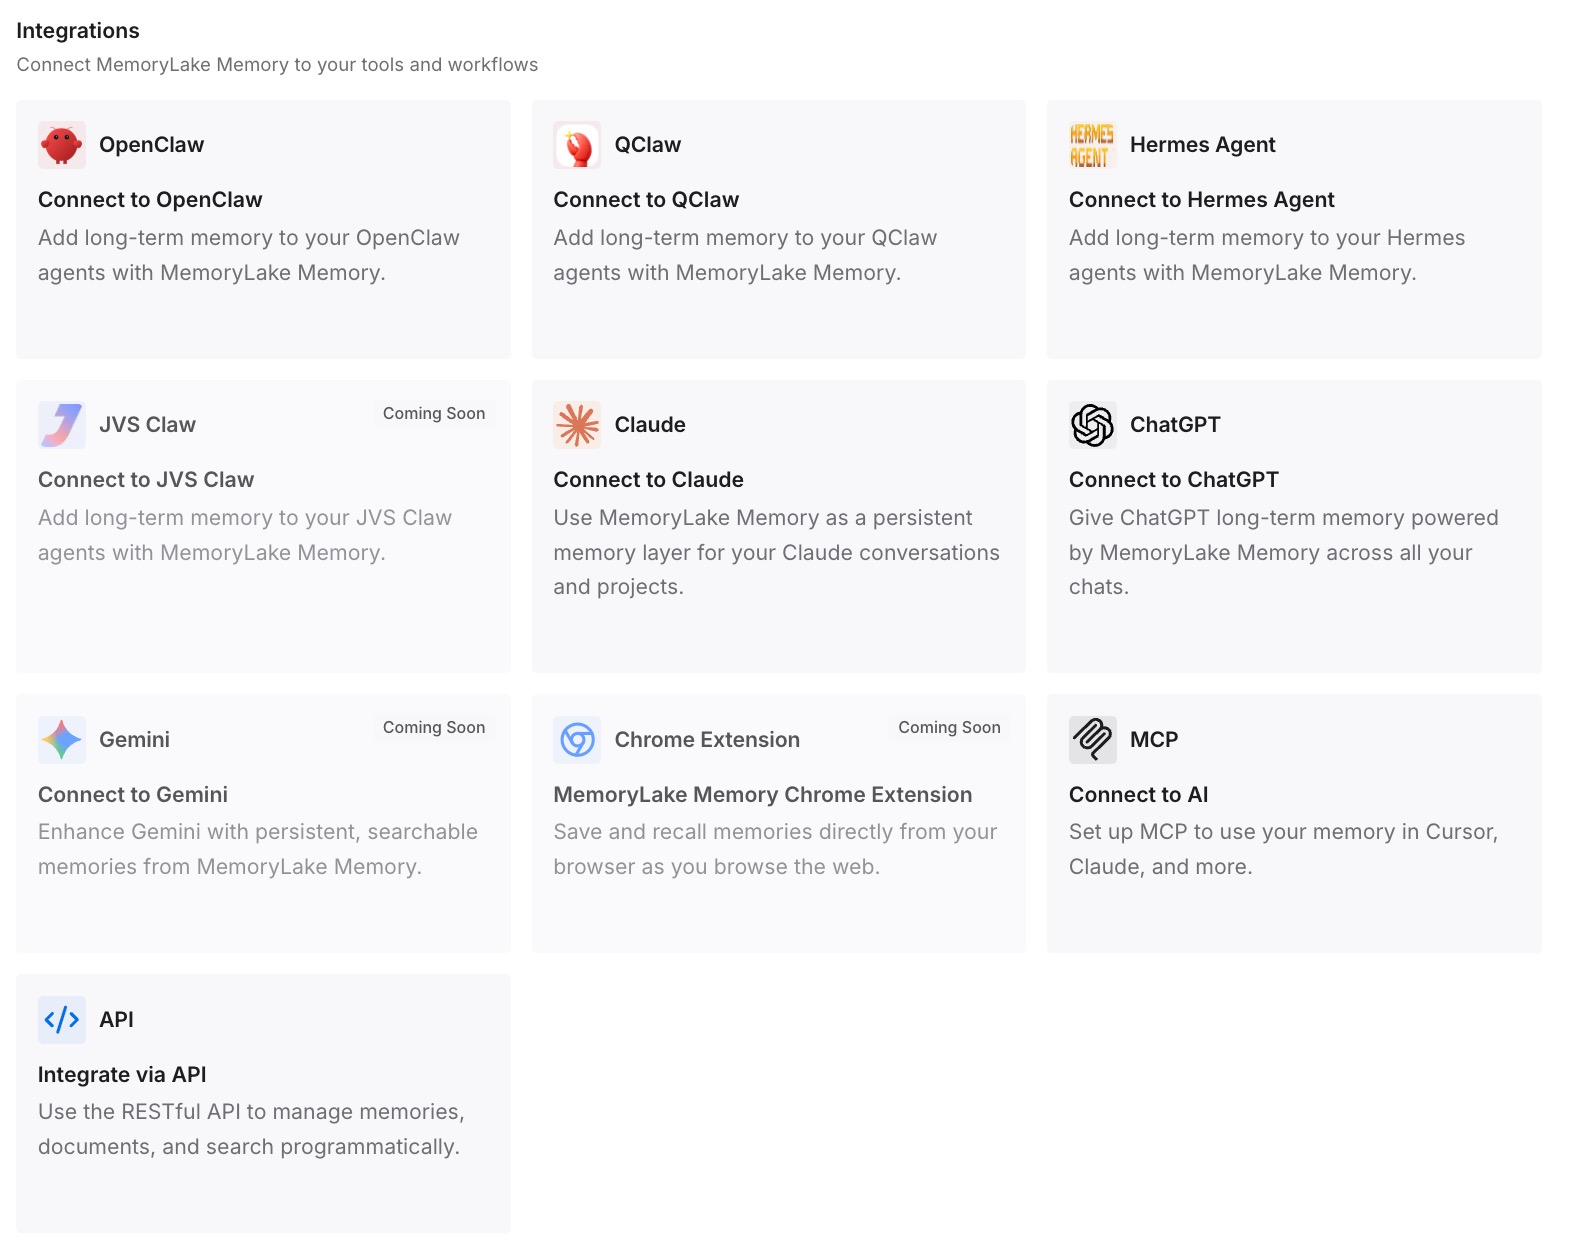
Claude Code 및 사용하는 다른 어시스턴트를 연결합니다. 스레드가 시작될 때, 압축 후, 또는 다른 도구에서도 동일한 항목을 사용할 수 있습니다.
실제 변화하는 점
첫 번째 차이점은 역할의 명확화입니다. 스레드는 활성 루프의 속도를 담당하고, 메시지 저장소는 기록이 되며, 장기적인 사실은 자체 레이어에 위치합니다.
두 번째는 더 안전한 압축입니다. 모든 압축이 새 스레드를 시작하므로, 중요한 사실들이 요약이 얼마나 잘 작성되었는지에만 의존하지 않게 됩니다.
세 번째는 도구 간의 반복 설명 감소입니다. 동일한 프로젝트가 Claude Code와 Codex에서 실행되는 경우, Claude Code와 Codex를 함께 사용하는 가이드에서 두 도구가 동일한 컨텍스트에서 작동하도록 유지하는 방법을 다룹니다.
Message Threads를 위한 모범 사례
스레드를 단기 캐시로 취급하십시오. 마지막 요청 후 5분이면 만료됩니다.
재생 경로를 먼저 구축하십시오. 404 에러를 예상하고 복사본에서 다시 전송하십시오.
전체 스레드에 동일한 키와 워크스페이스를 사용하십시오. 다른 호출자는 이를 계속할 수 없습니다.
코드에서 압축하십시오. 요약본으로 새 스레드를 시작하십시오.
캐시 중단점을 직접 설정하십시오. 스레드는 대신 캐싱해주지 않습니다.
보존 요구 사항을 확인하십시오. Threads는 ZDR 대상이 아닙니다.
지속적인 사실은 외부에 두십시오. 각 스레드 시작 시 로드하십시오.
결론
Message threads를 사용하면 에이전트가 매 턴마다 새로운 내용만 보낼 수 있습니다. Anthropic은 마지막 요청 후 5분 동안 대화를 메모리에 암호화하여 보관하고 1시간 이내에 삭제합니다. 스레드를 다시 읽을 수 있는 API는 없으며, 문서는 모든 메시지의 자체 복사본을 보관하라고 안내합니다.
따라서 스레드는 메모리가 아니라 단일 활성 세션을 위한 속도 향상 기능입니다. 압축은 요약을 작성하고 새 스레드를 시작하는 것을 의미하므로, 앞으로 이어지는 것은 사용자가 보관하는 것, 즉 메시지 저장소, 요약, 그리고 단일 대화보다 오래 지속되는 곳에 저장한 사실들입니다.