
Codex Subagents란 무엇인가
OpenAI의 문서에서는 세 가지 용어를 사용합니다. Subagent 워크플로우는 Codex가 병렬 에이전트를 실행하고 그 결과를 결합하는 방식입니다. Subagent는 특정 작업을 처리하기 위해 Codex가 시작하는 위임된 에이전트입니다. 에이전트 스레드는 Subagent가 작업을 수행하는 곳이며, 지원되는 클라이언트를 통해 이를 열 수 있습니다.
실행 위치
Subagents는 ChatGPT 데스크톱 앱, Codex CLI, IDE 확장 프로그램 및 ChatGPT Work에서 작동합니다. OpenAI는 "현재 Codex 릴리스는 기본적으로 Subagent 워크플로우를 활성화합니다"라고 밝히고 있습니다. ChatGPT Work에서 에이전트는 ChatGPT의 호스팅 환경에서 실행되며, 채팅창에 활동 내용과 결과가 표시됩니다.
이 기능은 무료가 아닙니다. OpenAI는 "각 Subagent가 자체 모델 및 도구 작업을 수행하므로, Subagent 워크플로우는 유사한 단일 에이전트 실행보다 더 많은 토큰을 소비합니다"라고 명시합니다.
시작 방법
로컬 Codex에서 Subagents는 사용자가 요청하거나 지침에 따라 Codex가 위임을 요청할 때 시작됩니다. OpenAI는 현재 로컬 릴리스가 "직접 요청하거나 해당 AGENTS.md 또는 스킬 지침이 요청할 때" 위임한다고 설명합니다. 실제로 이는 '에이전트 두 개 생성', '이 작업을 병렬로 위임', 또는 '각 포인트당 하나의 에이전트 사용'과 같은 프롬프트를 의미합니다.
ChatGPT Work에서는 대부분의 지능 수준에서 요청할 수 있습니다. Ultra 모델에서는 별도의 요청 없이도 ChatGPT가 적절한 작업을 위임할 수 있습니다.
존재 이유
OpenAI가 밝힌 이유는 속도가 아니라 컨텍스트 때문입니다. 메인 채팅을 탐색 노트, 테스트 로그, 스택 추적 및 명령 출력으로 채우면 "시간이 지남에 따라 세션의 신뢰성이 떨어질 수 있습니다." OpenAI는 두 가지 효과를 언급합니다. 유용한 정보가 묻히는 컨텍스트 오염(context pollution)과 덜 관련 덜한 세부 정보로 채팅이 채워지면서 성능이 저하되는 컨텍스트 부패(context rot)입니다.
Subagents는 이러한 노이즈를 메인 스레드 밖으로 옮깁니다. OpenAI의 가이드는 메인 에이전트를 "요구 사항, 결정 및 최종 출력에 집중"하게 유지하고, 가공되지 않은 중간 출력 대신 Subagents로부터 요약본을 반환받는 것입니다.
각 Subagent가 시작할 때 갖는 것
이 부분은 Subagents가 사용자가 직접 여는 두 번째 채팅과 가장 크게 다른 점입니다. Subagent는 세션의 일부 항목을 자동으로 가져오고, 다른 항목은 제공된 경우에만 가져옵니다.
작업, 그리고 어쩌면 대화 내용
모든 Subagent는 작업을 부여받습니다. 대화 내용까지 함께 받을지 여부는 시작될 때 결정됩니다. Codex의 오픈 소스 코드에서 Subagent를 시작하는 도구에는 이에 대한 옵션이 있으며, 다음과 같이 설명되어 있습니다. "True는 현재 스레드 기록을 새 에이전트로 포크(fork)하고, false 또는 생략된 경우 초기 프롬프트로만 시작합니다."
따라서 Subagent는 작업 내용에 적힌 것만 알고 시작할 수 있습니다. 메인 채팅에 어떤 라이브러리를 선택했는지 또는 어떤 파일이 금지되었는지와 같은 결정 사항이 포함되어 있다면, Subagent가 이를 알고 있다고 가정하지 마십시오. 요청에 포함하거나 Codex가 위임할 때 이를 포함하도록 요청하십시오. OpenAI의 조언도 동일합니다. "좋은 Subagent 프롬프트는 작업을 나누는 방법, Codex가 계속하기 전에 모든 에이전트를 기다려야 하는지 여부, 그리고 어떤 요약이나 출력을 반환해야 하는지를 설명해야 합니다."
다른 방향으로 탐색하기 위해 대화의 전체 복사본을 원하는 경우, 이는 다른 기능입니다. Codex 채팅 포크 가이드에서 이를 다룹니다. Claude Code의 Subagents도 각 도우미가 무엇을 알고 있는지에 대해 동일한 의문을 제기하며, Claude Code Subagents가 메모리를 공유하지 않는 이유에 대한 가이드에서 그 측면을 다룹니다.
모델 설정
아무것도 구성하지 않으면 OpenAI는 "Subagent가 부모 에이전트의 모델과 추론 노력을 상속받는다"고 말합니다. 프롬프트에서 이를 변경하거나, config.toml의 [agents] 아래에 기본값을 설정하거나, 커스텀 에이전트 파일에서 설정할 수 있습니다. OpenAI는 좁고 반복 가능한 작업에는 더 빠른 모델을, 계획 및 검증이 필요한 에이전트에는 더 강력한 모델을 사용할 것을 권장합니다.
샌드박스 및 승인
Subagents는 현재 샌드박스 정책을 상속받습니다. 데스크톱 앱 및 IDE 확장 프로그램에서는 컴포저 아래에서 선택된 권한 모드를 상속받으므로, Codex에 위임을 요청하기 전에 이를 선택하십시오. CLI에서 OpenAI는 "Subagents는 /permissions 또는 --yolo로 변경된 사항을 포함하여 부모 턴의 현재 샌드박스 및 승인 설정을 상속받습니다"라고 설명합니다.
커스텀 에이전트가 이를 완화할 수는 없습니다. OpenAI는 명확하게 밝힙니다. "커스텀 에이전트 지침은 에이전트에게 편집을 피하도록 요청할 수 있지만, 별도의 읽기 전용 샌드박스를 생성하지는 않습니다."
스킬, MCP 서버 및 메모리
커스텀 에이전트는 "부모의 권한, 제공자 및 MCP 서버를 상속받으며, 커스텀 에이전트 파일은 이러한 설정을 재정의할 수 없습니다." 스킬 또한 부모로부터 상속받으며, 커스텀 에이전트는 skills.config를 통해 개별 스킬을 끌 수 있습니다.
메모리는 커스텀 에이전트가 끌 수 있는 기능 중 하나입니다. OpenAI는 에이전트의 기능을 제한하기 위해 false로 설정할 수 있는 기능 키 중 하나로 features.memories를 나열합니다. Codex의 로컬 메모리를 켠 경우, Codex 로컬 메모리 가이드에서 메모리에 무엇이 담기고 어떻게 제어되는지 설명합니다.
메인 채팅으로 돌아오는 내용
메인 스레드는 전체 작업 과정이 아닌 결과를 받습니다. 여러 에이전트가 실행될 때 OpenAI는 "Codex는 요청된 모든 결과를 사용할 수 있을 때까지 기다린 다음 통합된 응답을 반환합니다"라고 설명합니다.
작업 자체는 각 에이전트 스레드에 남아 있습니다. 데스크톱 앱에서 OpenAI는 "각 Subagent 스레드를 표시하여 작업 내용과 메인 채팅으로 반환된 요약을 검토할 수 있게 합니다"라고 말합니다. CLI에서는 /subagents를 통해 실행 중인 에이전트 스레드 사이를 전환할 수 있습니다. ChatGPT Work에서는 Subagents 패널에 읽기 전용인 Active 및 Done 목록이 표시되며, 완료된 Subagent를 열어 세부 정보와 결과를 확인할 수 있습니다.
이러한 설계는 메인 채팅을 깔끔하게 유지합니다. 또한 Subagent가 어떤 파일을 읽었는지 또는 어떤 접근 방식을 제외했는지와 같은 발견 뒤의 추론 과정은 사용자가 직접 열어봐야 하는 스레드 안에 존재한다는 의미이기도 합니다. 나중에 이 내용이 중요하다면 해당 스레드 외부의 어딘가에 기록해 두어야 합니다.
내장 및 커스텀 에이전트
Codex는 세 가지 내장 에이전트와 함께 제공됩니다.
default: 일반적인 목적의 폴백 에이전트worker: 구현 및 수정을 위한 에이전트explorer: 읽기 작업이 많은 코드베이스 탐색을 위한 에이전트
사용자는 TOML 파일로 자신만의 에이전트를 정의할 수 있습니다. 개인용 에이전트는 ~/.codex/agents/에, 프로젝트 범위 에이전트는 .codex/agents/에 에이전트당 하나의 파일을 둡니다. 각 파일은 name, description, developer_instructions를 정의해야 합니다. OpenAI의 문서에는 .codex/agents/reviewer.toml로 저장된 이 리뷰어 예시가 포함되어 있습니다.
name = "reviewer"
description = "정확성, 보안 및 누락된 테스트에 집중하는 PR 리뷰어."
model = "gpt-6.1-sol"
model_reasoning_effort = "medium"
developer_instructions = """
소유자처럼 코드를 리뷰하십시오.
파일을 편집하지 마십시오.
정확성, 보안, 동작 회귀 및 누락된 테스트 커버리지를 우선시하십시오.
구체적인 발견 사항을 먼저 제시하고, 가능한 경우 재현 단계를 포함하며, 실제 버그를 숨기지 않는 한 스타일 관련 코멘트는 피하십시오.
"""
커스텀 에이전트에 대한 OpenAI의 조언은 범위를 좁게 유지하는 것입니다. "가장 좋은 커스텀 에이전트는 범위가 좁고 주관이 뚜렷한 에이전트입니다." 커스텀 에이전트의 이름이 explorer와 같이 내장 에이전트와 일치하면 사용자의 설정이 우선순위를 갖습니다.
전역 설정
모든 Subagents에 적용되는 설정은 구성의 [agents] 아래에 위치합니다. agents.enabled는 기본값이 true이며, 멀티 에이전트 도구를 끄려면 false로 설정합니다. agents.max_concurrent_threads_per_session은 메인 스레드를 제외하고 한 번에 열 수 있는 생성된 에이전트 스레드 수를 제한하며, agents.max_threads는 레거시 별칭으로 여전히 작동합니다. agents.default_subagent_model 및 agents.default_subagent_reasoning_effort는 명시적 요청이 재정의하기 전까지의 기본값을 설정합니다.
실행 중인 Subagents 조종하기
기다릴 필요가 없습니다. 데스크톱 앱, CLI 및 IDE 확장 프로그램에서 실행 중인 Subagent를 조종하거나, 중지하거나, 완료된 스레드를 닫도록 Codex에 요청할 수 있습니다. CLI에서는 보고 있지 않은 에이전트 스레드에서 승인 요청이 올 수 있습니다. 오버레이에 어떤 스레드가 요청 중인지 표시되며, 답변하기 전에 o를 눌러 해당 스레드를 열 수 있습니다.
OpenAI는 또한 한 가지 작업 유형에 대해 경고합니다. 병렬 에이전트는 탐색, 테스트, 분류 및 요약과 같은 읽기 중심 작업에 적합합니다. "병렬 쓰기 중심 워크플로우는 주의해야 합니다. 여러 에이전트가 동시에 코드를 편집하면 충돌이 발생하고 조정 오버헤드가 증가할 수 있기 때문입니다."
사람들이 흔히 하는 실수
Subagent가 전체 대화 내용을 알고 있다고 가정하는 것. Subagent는 작업 내용만 가지고 시작할 수 있습니다. 중요한 결정 사항은 요청에 포함하십시오.
커스텀 에이전트 파일을 사용하여 에이전트를 읽기 전용으로 만들려는 것. 지침으로 편집하지 말라고 요청할 수는 있지만, 샌드박스는 여전히 부모 세션에서 가져옵니다.
커스텀 에이전트 파일에서 MCP 서버를 설정하는 것. 부모 설정을 재정의하지 않습니다. MCP 서버는 부모 세션에서 구성하십시오.
동일한 코드를 편집하는 여러 에이전트를 실행하는 것. OpenAI는 병렬 쓰기에 주의를 권장합니다. 병렬 에이전트는 주로 읽기 및 확인 용도로 사용하십시오.
실행 후 발견 사항을 잃어버리는 것. 메인 채팅은 요약만 받습니다. 세부 사항이 중요하다면 다음 단계로 넘어가기 전에 저장하십시오.
해결책: 각 Subagent에 브리핑하고, 메인 채팅은 결정용으로 유지하며, 학습한 내용을 기록하십시오
1단계: 작업뿐만 아니라 브리핑을 작성하십시오
Codex에 위임을 요청할 때 작업을 나누는 방법, 각 에이전트가 반환해야 하는 항목, 모든 에이전트를 기다릴지 여부를 명시하십시오. 제약 조건, 건드리지 말아야 할 파일, 이미 제외된 접근 방식 등 각 에이전트가 필요한 결정 사항을 포함하십시오. 지속적인 규칙은 AGENTS.md에 두어 Codex가 매번 따를 수 있게 하십시오. Codex가 AGENTS.md 규칙을 건너뛰는 문제에 대한 가이드에서 Codex가 이러한 파일을 찾는 방법을 다룹니다.
2단계: 위임하기 전에 권한 및 에이전트를 설정하십시오
Subagents가 이를 상속받으므로 부모 턴의 권한 모드를 먼저 선택하십시오. 반복하는 작업의 경우, 좁은 지침과 작업에 적합한 모델을 갖춘 커스텀 에이전트를 만들고, 작업에 필요하지 않은 기능은 끄십시오.
3단계: Subagents가 찾은 내용을 저장하십시오
통합된 답변이 도착하면 중요한 에이전트 스레드를 열어 유지할 가치가 있는 발견 사항(리스크, 결정, 막다른 길 등)을 추출하십시오. 다음 세션에서 볼 수 있는 곳에 기록하십시오. 명확한 끝이 있는 긴 작업의 경우, Codex Goal 모드 가이드에서 메인 채팅이 결과물을 향하도록 유지하는 방법을 설명합니다.
MemoryLake에서 설정하기
Subagents는 발견 사항을 생성하지만, 이를 유지하는 것은 사용자의 몫입니다. 각 발견 사항은 에이전트 스레드에 머물며, 누군가 기록하지 않는 한 다음 작업, 채팅 또는 도구는 그 내용 없이 시작됩니다.
MemoryLake는 이러한 발견 사항을 사용자가 관리하는 하나의 리스트로 유지하여 Codex 및 ChatGPT, Claude Code와 같이 연결된 다른 어시스턴트가 사용할 수 있게 해주는 memory 레이어입니다.
사용자는 자신의 언어로 직접 항목을 작성합니다. Subagent 스레드, AGENTS.md 파일, Codex memories 또는 공급업체의 저장소에서 아무것도 읽거나 쓰거나 삭제하지 않습니다. Subagents는 OpenAI가 설명한 방식 그대로 계속 작동합니다.
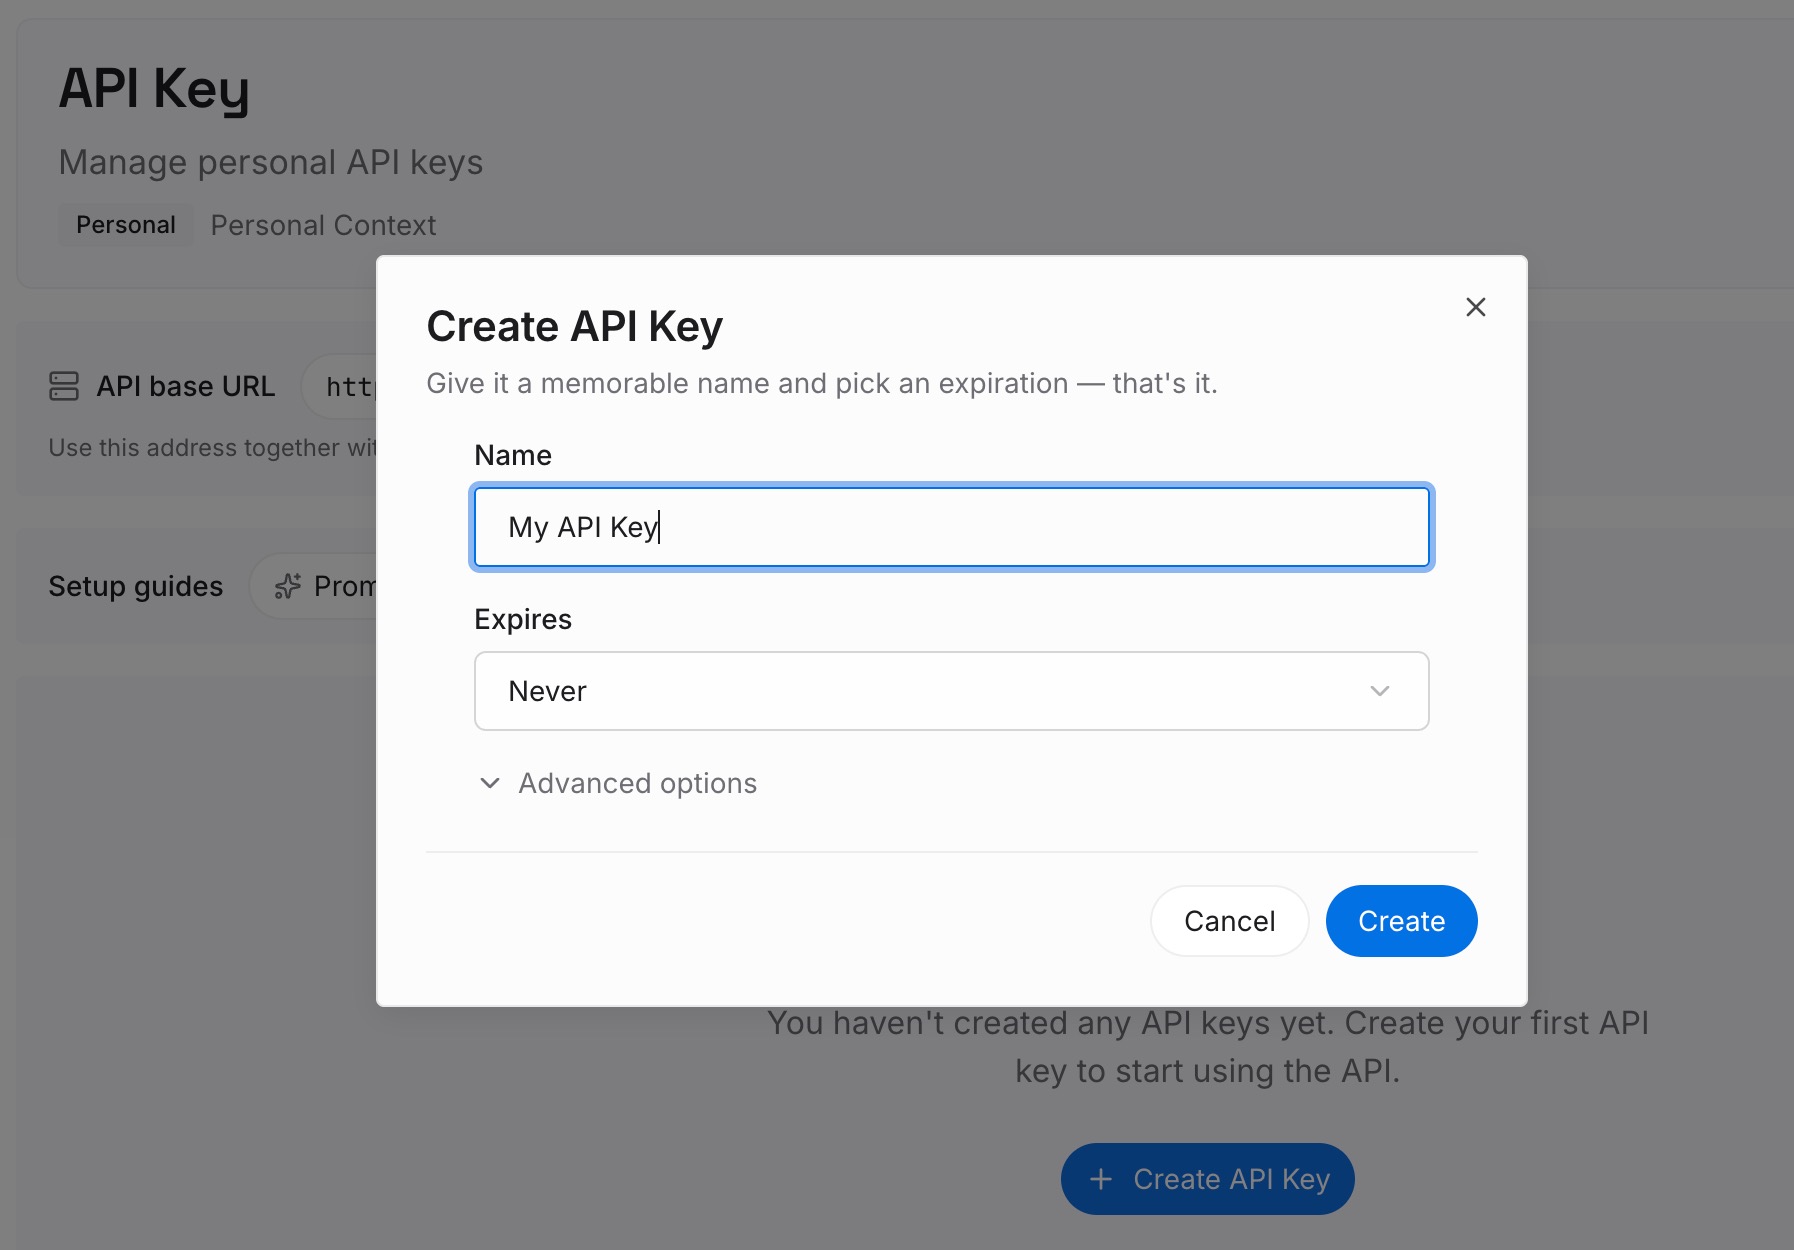
1단계: API 키 생성
로그인 후 대시보드에서 키를 생성합니다. 이 키는 MemoryLake 워크스페이스에 속하며 ChatGPT 계정 및 Codex 구성과는 별개입니다.
2단계: 첫 번째 memories 업로드
해결책의 3단계에서 추출한 내용으로 시작하십시오. 지난 Subagent 실행에서의 발견 사항, 결정 사항 및 제외된 접근 방식들입니다. 항목당 하나의 포인트를 작성하고 날짜를 기입하며 저장소 레이블을 지정합니다.
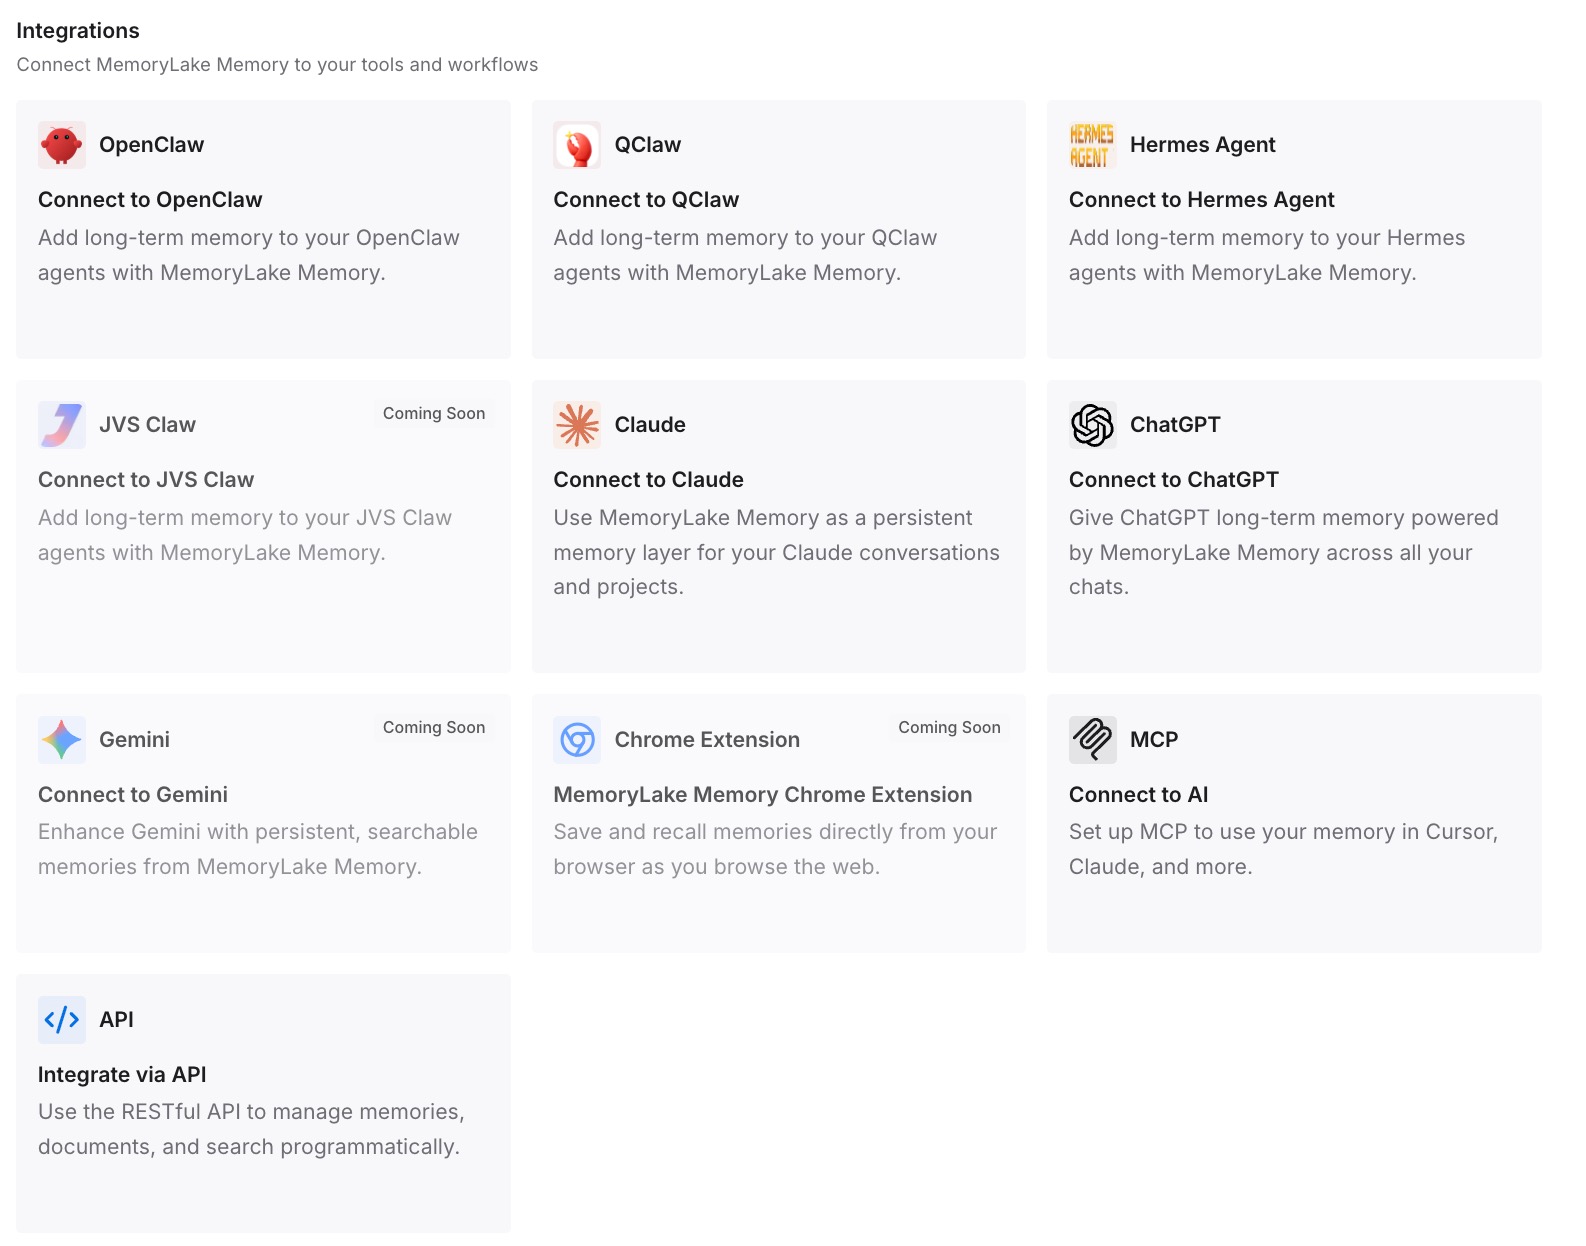
3단계: AI 및 에이전트 연결
Codex 및 사용하는 다른 어시스턴트를 연결합니다. 다음 브리핑은 지난 실행에서 결정된 사항부터 시작할 수 있습니다.
실제로 바뀌는 점
첫 번째 차이점은 Subagents가 정보를 갖춘 상태로 시작한다는 것입니다. 브리핑은 상속받았기를 바라는 대신 그들이 필요한 결정 사항을 직접 전달합니다.
두 번째는 메인 채팅이 집중된 상태를 유지한다는 것입니다. 노이즈가 많은 작업은 에이전트 스레드에서 발생하며, 메인 스레드는 요구 사항, 결정 및 결과를 보유합니다.
세 번째는 발견 사항이 실행 이후에도 유지된다는 것입니다. Subagent가 배운 내용은 기록되며, 다시는 열어보지 않을 스레드에 방치되지 않습니다. 긴 세션이 걱정된다면, Codex의 GPT-6.1 Sol 500k 기본 설정 가이드에서 압축이 시작되는 시점을 확인하십시오.
Codex Subagents를 위한 모범 사례
명시적으로 요청하십시오. 작업을 나누는 방법과 반환할 내용을 말하십시오.
브리핑에 결정 사항을 넣으십시오. Subagent는 작업 내용만 가지고 시작할 수 있습니다.
위임하기 전에 권한을 설정하십시오. Subagents는 부모 턴에서 권한을 상속받습니다.
병렬 쓰기보다 병렬 읽기를 선호하십시오. 탐색, 테스트, 분류 및 리뷰에 Subagents를 사용하십시오.
커스텀 에이전트의 범위를 좁게 유지하십시오. 하나의 작업, 명확한 지침, 적합한 모델을 사용하십시오.
부모 세션에서 MCP 서버를 구성하십시오. 커스텀 에이전트 파일은 이를 재정의할 수 없습니다.
발견 사항을 저장하십시오. 중요한 스레드를 열고 학습한 내용을 기록하십시오.
결론
Codex Subagents는 병렬로 실행되는 위임된 에이전트로, 각각 고유한 스레드에서 작동하며 그 결과를 하나의 통합된 응답으로 메인 채팅에 반환합니다. 현재 Codex 릴리스와 ChatGPT Work에서 기본적으로 활성화되어 있습니다. 각 Subagent는 모델 설정, 샌드박스 및 승인, MCP 서버, 스킬을 상속받으며, 대화 내용이 포크되지 않는 한 작업 내용만 가지고 시작할 수 있습니다.
각 Subagent에게 실질적인 브리핑을 제공하고, 권한을 먼저 설정하며, 병렬 작업은 주로 읽기 전용으로 유지하고, 스레드가 시야에서 사라지기 전에 Subagents가 찾은 내용을 기록하십시오.