
什么是模型规范,以及 10 月 29 日发生了什么变化
模型规范(Model Spec)是 OpenAI 对预期模型行为的公开描述。它的开头简明地陈述了其作用:“我们正在训练我们的模型,使其符合模型规范中的原则。”它描述的是训练目标,而不是设置页面,它不会更改您账户中的任何开关。
10 月 29 日发布的版本围绕五个价值观重新组织了整个文档,并将其描述对象从“助手”更名为 GPT。对于记忆而言,相关的变化是关于上下文的新章节。它的目标是:“当之前的上下文与当前请求相关时,GPT 应以帮助用户的方式使用它,而不应过度声称它知道什么或该上下文是如何获取的。”
该章节将记忆视为几种上下文中的一种。用规范的话说,“上下文可以包括之前的对话轮次、过去对话的记忆、检索到的信息、文件、工具输出、第三方信息以及其他可用来源。”
这种框架很重要。该指南不仅针对保存的记忆。它涵盖了 ChatGPT 了解的关于您的任何信息,无论您是在本次对话中说的、几个月前说的、上传的,还是通过连接的应用显示的。
ChatGPT 会在每次对话中都使用您的记忆吗?
并非设计如此。规范指出,只有在有帮助时才应使用上下文。关键句是:“当对当前交互的预期收益(例如:有用性、安全性或趣味性)超过风险(例如:无关性、敏感性、陈旧性、误解或向错误的对象泄露)时,GPT 应使用上下文。”
它还排除了仅仅因为信息存在就提及它的本能反应:“它不应仅仅因为上下文可用就使用或提及它。”
规范权衡了两个方向。使用过少的上下文也会产生成本,例如忽略您提到的安全约束或让您重复项目细节。其中的一个例子展示了另一面的失败:一个在之前的对话中一直在制定营销计划的用户请求协助演示该计划,而错误的回答是询问他们指的是哪项业务。规范指出,GPT 应推进项目状态,“而不是强迫用户(重新)陈述他们已经分享过的内容”。
因此,预期的行为既不是使用所有内容,也不是什么都不用。这是根据当前请求的需求,在每次对话中进行的判断。
ChatGPT 处理已知信息的四种方式
该章节最实用的部分是根据情况使用上下文的简短列表。以下是引用自规范的主要案例。
静默使用
当上下文“相关、符合预期、低风险且可能是最新的”时,GPT 应“静默使用上下文”。规范中给出的例子是将饮食偏好应用于菜单照片。你不需要 ChatGPT 宣布它记住了这一点。
说明其假设
当“用户可能会感到困惑或假设很重要”时,GPT 应“说明一个可纠正的假设或来源”。一个例子显示,用户询问为什么回答被简化了,而好的回答会解释这是基于之前关于孩子年龄的信息,然后提供调整建议。
先询问
当“相关上下文是间接的、推断的、敏感的、工具衍生的或非用户明确披露的”时,GPT 应“提出一个中立的问题”。并且当“上下文具有高影响、冲突、可能已更改或与高成本操作相关联”时,它应“要求直接确认”。规范中的例子:在下单订餐前,ChatGPT 会询问是否要添加它在之前订单中看到的过敏备注。
不使用
当上下文“无关或多余、被取代、太不确定、使用不安全、不合适或尴尬,或者会降低回答的真实性”时,GPT 应“不使用上下文”。
规范为不确定的情况增加了一条通用规则:“当不确定性或敏感性显著时,GPT 应转向更窄或更明确的使用方式:例如,说明假设、简短询问或不使用。”
为什么私密信息不应出现在电子邮件中
引言中的电子邮件问题在“尊重隐私和受众”部分有专门论述。它从来源开始:“用户直接分享的上下文通常比 GPT 推断或工具显示的上下文更容易被使用。”
然后它直接解决了共享输出的问题:“一个适合在给用户的私密回复中使用的实事,在电子邮件、Slack 消息或文档中披露可能是不合适的。”
规范中的例子非常具体。用户在之前的对话中提到了怀孕,并说同事们还不知道。后来用户请求给团队写一封关于选择不同午餐地点的简短邮件。好的草案提到了饮食限制。坏的草案提到了怀孕。
这就是遵循规范的模型应有的行为。如果你看到了相反的情况,规范为你提供了纠正它的明确理由。
单次请求并非长期偏好
该章节中较安静的一部分涉及偏好是如何记录的。规范划定了一条界线:“GPT 不应将特定上下文的请求视为持久偏好,除非用户将其表达为长期指导,或者更广泛的上下文明确支持将其视为持久偏好”。
它对不同类型的上下文进行区别对待。之前的指令在仍然适用时应予以遵循。偏好是默认设置。而对于事实,则有一个警告:“之前的事实和推断是证据,但它们可能是陈旧的、不完整的、敏感的、错误的,或仅限于之前的情况。”
在实践中,如果你要求过一次使用项目符号,这不应该改变从现在开始的每一个回答。如果你希望一个偏好持续下去,请用使其成为长期指导的词语来说明,例如 总是 或 从现在开始。规范还区分了你所说的和它所猜测的:“GPT 应区分用户所说的内容与其推断的内容”。
ChatGPT 不应如何声称其自身的记忆
这是更新中直接体现在对话中的部分。规范承认模型并不总是了解其自身记忆的工作原理。GPT “可能对过去交互的访问不完整,对记忆设置、检索或为何某个细节可用了解不完善。”
因此它设定了一个限制:“它不得对已保存、保留、检索、选择、删除、遗忘或可访问的内容做出无根据的声明”。
当你要求它忘记时
规范直接涉及了遗忘请求。在收到请求后,“后续回复应避免依赖该上下文,除非用户再次提出或更高优先级的指令要求使用”。它还指出:“GPT 不应声称持久删除,除非它可以验证删除已发生。”
一个例子使这一点变得具体。用户要求模型忘记关于他们老板的一切。被标记为坏的回答是“好的——我不会再提到她了!”被标记为好的回答开头是:“我无法删除聊天记录中已经存在的消息,但我会尽力避免将来再次提到你的老板!”然后它会引导用户删除相关的聊天记录。
这是对 ChatGPT 记忆工作原理的诚实描述。在对话中询问会改变行为。删除信息则需要使用控制项。我们的让 ChatGPT 忘记某事的指南详细介绍了细节可能存在的每个位置。
你可以询问它如何使用上下文
规范还指出,上下文的使用应该是清晰且可控的。用它的话说:“用户永远不应该怀疑如果没有个性化是否会得到更好的答案,GPT 应努力彻底且准确地回答关于它如何使用上下文的问题”。
如果一个回答看起来受到了你之前说过的话的影响,你可以询问它是基于什么得出的。
更新没有改变的内容
规范描述的是行为。您的设置仍然决定了 ChatGPT 最初可以记住什么。OpenAI 在 10 月 29 日发布的记忆帮助文章描述了这些控制项:
- 记忆和参考聊天记录。 关闭聊天记录参考功能会安排在 30 天内删除从过去聊天中记住的信息。除非您删除,否则您的原始聊天记录会保留。我们的关于关闭记忆会停止什么的指南涵盖了这些设置如何相互作用。
- 不要再提这个。 OpenAI 表示这会“减少未来对该信息的引用。它不会删除原始来源。”
- 删除聊天。 OpenAI 指出,“仅删除聊天并不一定会删除从该聊天创建的单独保存的记忆。”
- 临时聊天和项目。 两者都有各自的记忆规则。我们的临时聊天和保存记忆指南以及我们的项目记忆模式指南涵盖了这些内容。
规范的诚实规则与这些控制项一致。模型被告知不要声称它无法验证的删除,而帮助文章指出删除是通过设置和源聊天进行的。
人们首先尝试的做法
假设每次回复都开启了记忆。 规范描述了针对每个请求的判断。你告诉 ChatGPT 的某些内容在不相关时可能不会出现。
要求 ChatGPT 忘记并假设它已消失。 规范指出模型应停止依赖它,且不应声称已删除。移除它需要使用记忆控制项和最初分享该信息的聊天记录。
期望一次请求变成一种习惯。 一次性的格式选择并不意味着要成为长期偏好,除非你说明应该如此。
为了停止一次尴尬的提及而关闭记忆。 这会停止所有地方的个性化。纠正细节,或使用“不要再提这个”,是更精确的做法。
将旧事实视为当前事实。 规范将之前的事实称为可能是陈旧的证据。你六个月前的职位、技术栈或截止日期现在可能是错误的。
解决方法:让您的上下文易于正确使用
第 1 步:说明哪些偏好是长期的
当你希望某件事从现在起一直适用时,请明确说明。以 从现在开始 开头的请求会被视为长期指导。以 仅限这一次 为框架的请求则不会。规范中关于特定上下文请求和持久偏好之间的界限取决于你的措辞方式。
第 2 步:从源头纠正陈旧或敏感的上下文
如果 ChatGPT 提到了过时的内容,请在对话中纠正它并检查你的记忆设置。如果私密信息出现在不该出现的地方,请使用记忆控制项,而不仅仅是在对话中要求。我们的检查记忆摘要遗漏了什么的指南展示了如何查看存储的内容。
第 3 步:询问回答是如何使用你的上下文的
当一个回答看起来经过了个性化处理而你不确定原因时,请询问它是基于什么得出的。规范指出 ChatGPT 应彻底且准确地回答。如果回答揭示了错误的内容,请修复它。如果记忆似乎被完全忽略了,我们的 ChatGPT 记忆不起作用指南涵盖了常见原因。
在 MemoryLake 中设置
规范非常看重来源:你直接陈述的上下文比推断出的上下文更容易被用好。同样的理念也适用于你在不同工具中依赖的事实。一份由你编写并注明日期的偏好、决定和约束的简短列表,就是来源清晰的上下文。
MemoryLake 是一个记忆层,用于将该列表保存在一个由你维护的地方,供你连接的助手(如 ChatGPT、Claude Code 和 Codex)使用。
你用自己的语言亲自编写条目。没有任何内容会从你的 ChatGPT 记忆、聊天记录、项目或任何供应商的存储中读取、写入或删除。ChatGPT 自身的记忆及其控制项将完全按照 OpenAI 描述的方式继续工作。
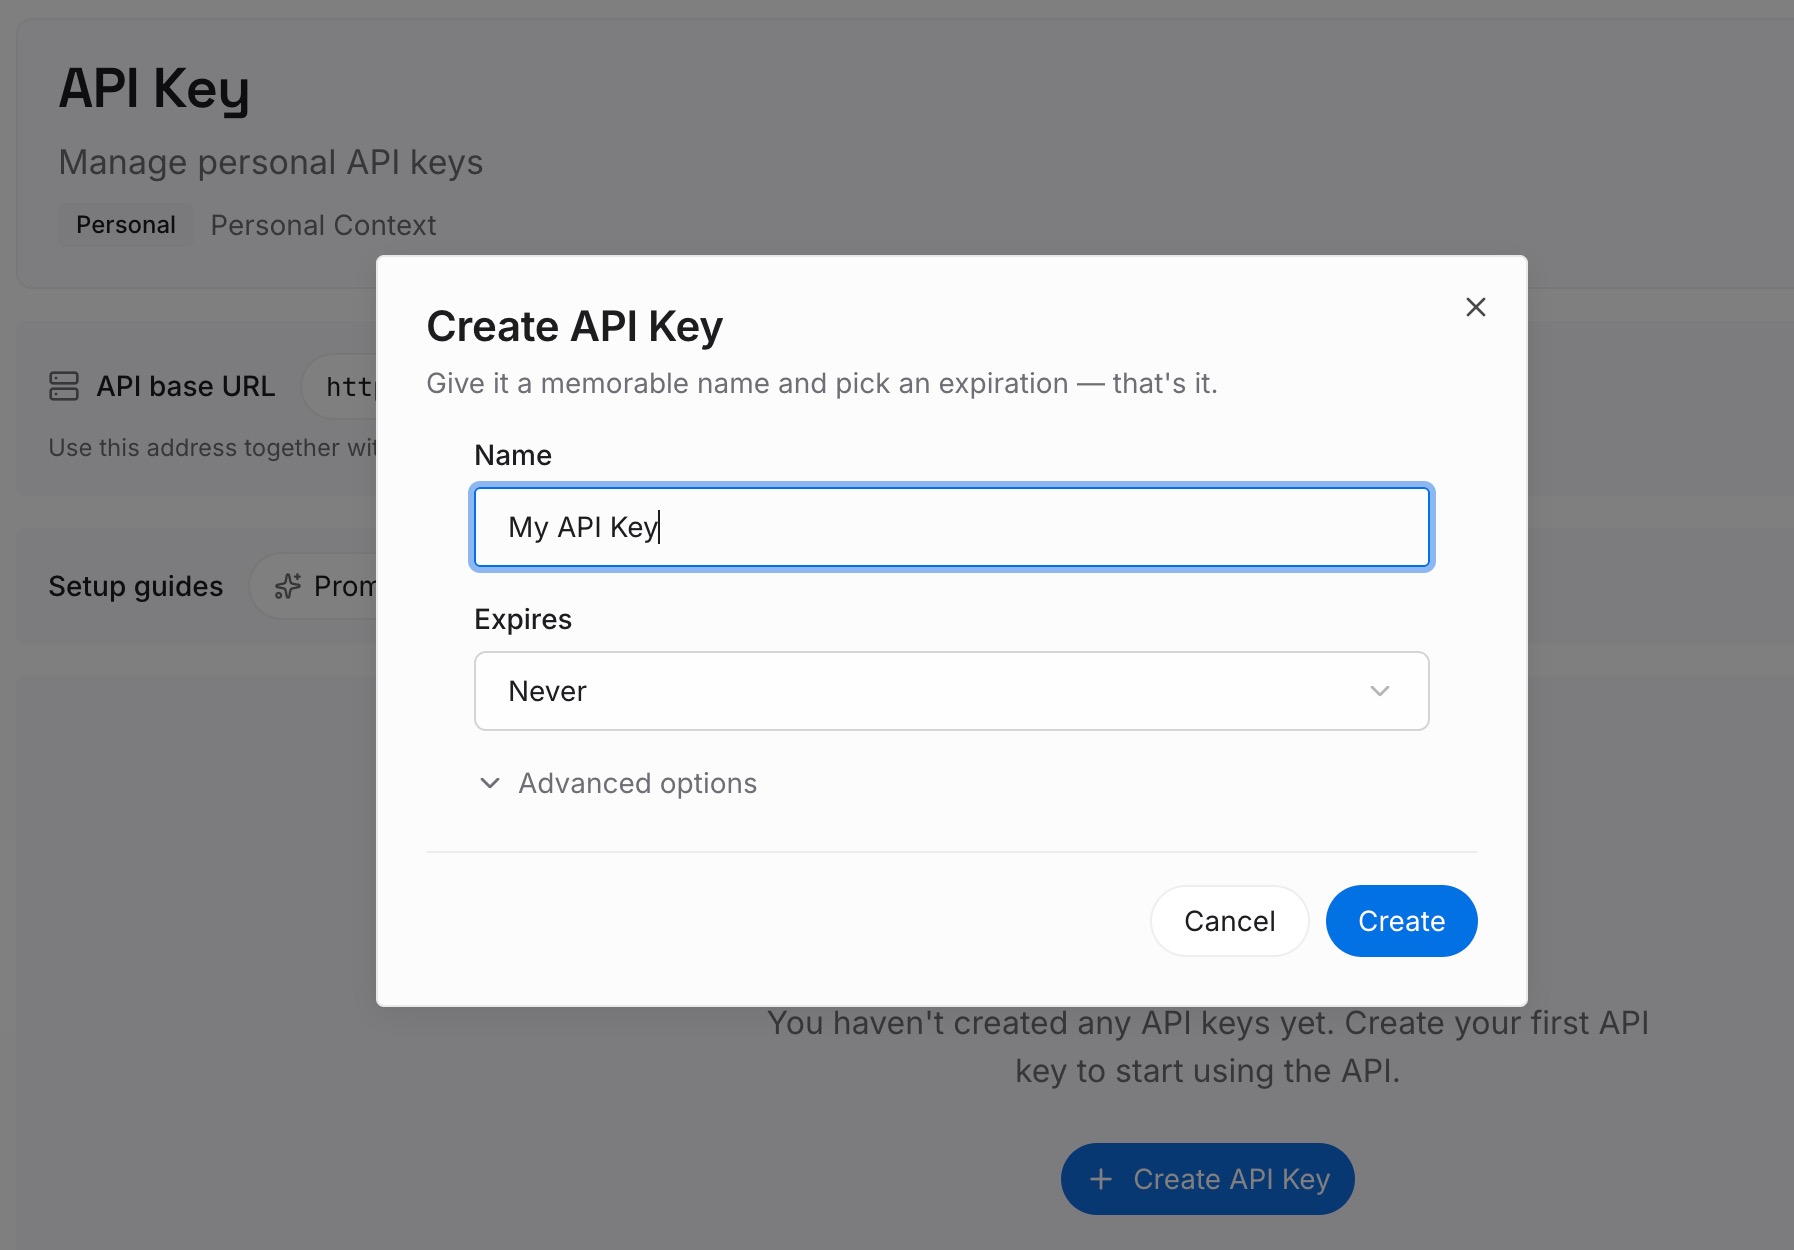
第 1 步:创建 API 密钥
登录并从控制面板生成一个密钥。该密钥属于您的 MemoryLake 工作区,与您的 OpenAI 账户是分开的。
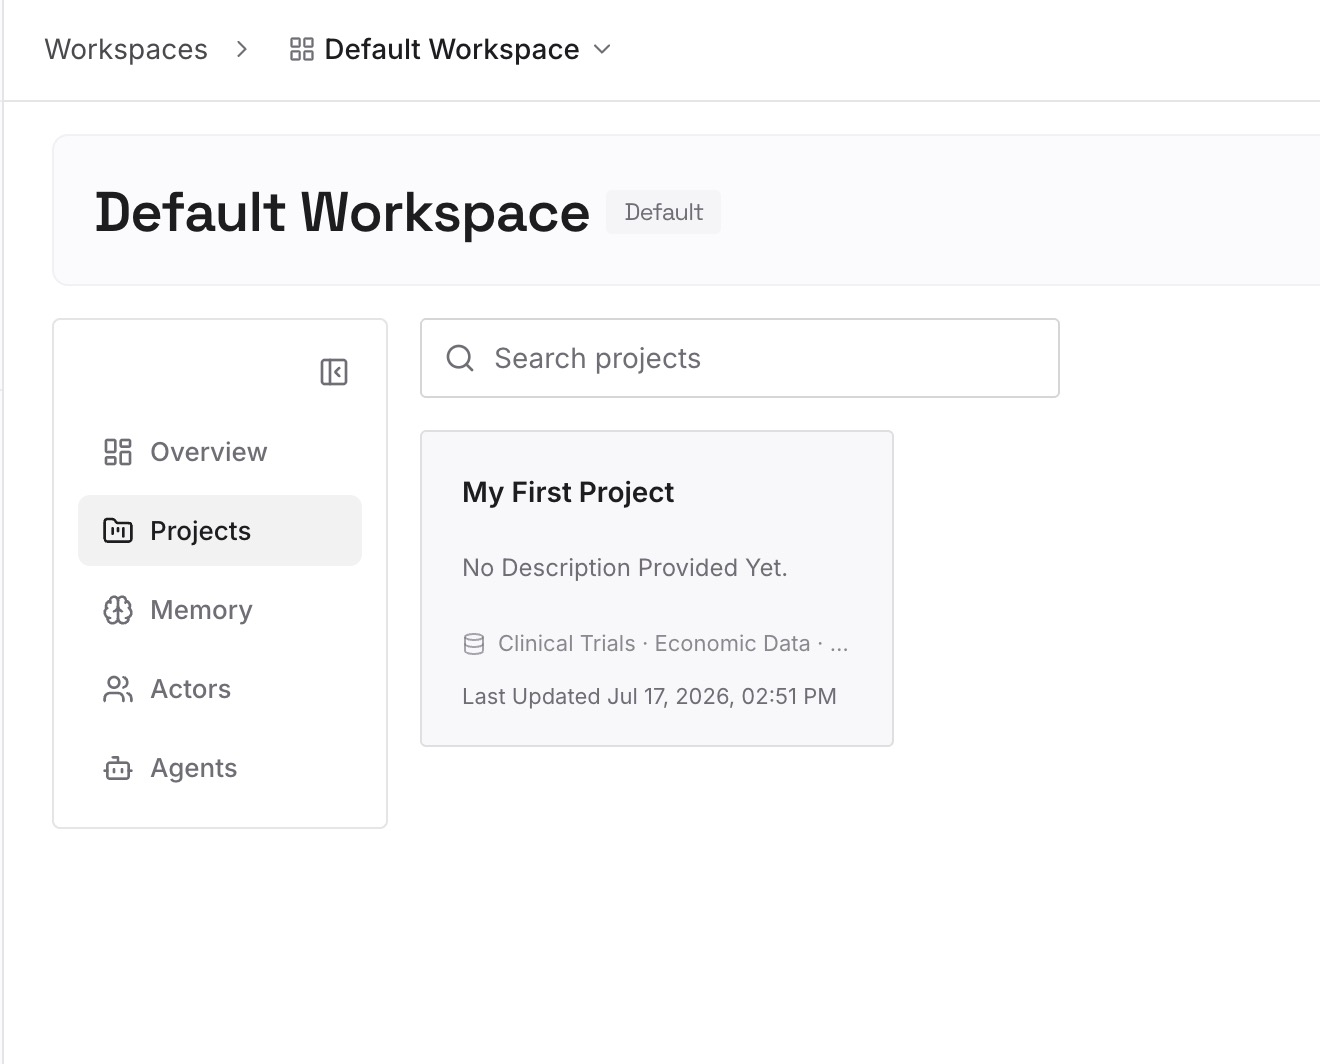
第 2 步:上传您的第一条记忆
从“解决方法”第 1 步中的长期偏好以及您原本需要反复纠正的事实开始。每个条目一个要点,并注明日期,以便清楚每条信息的有效期。
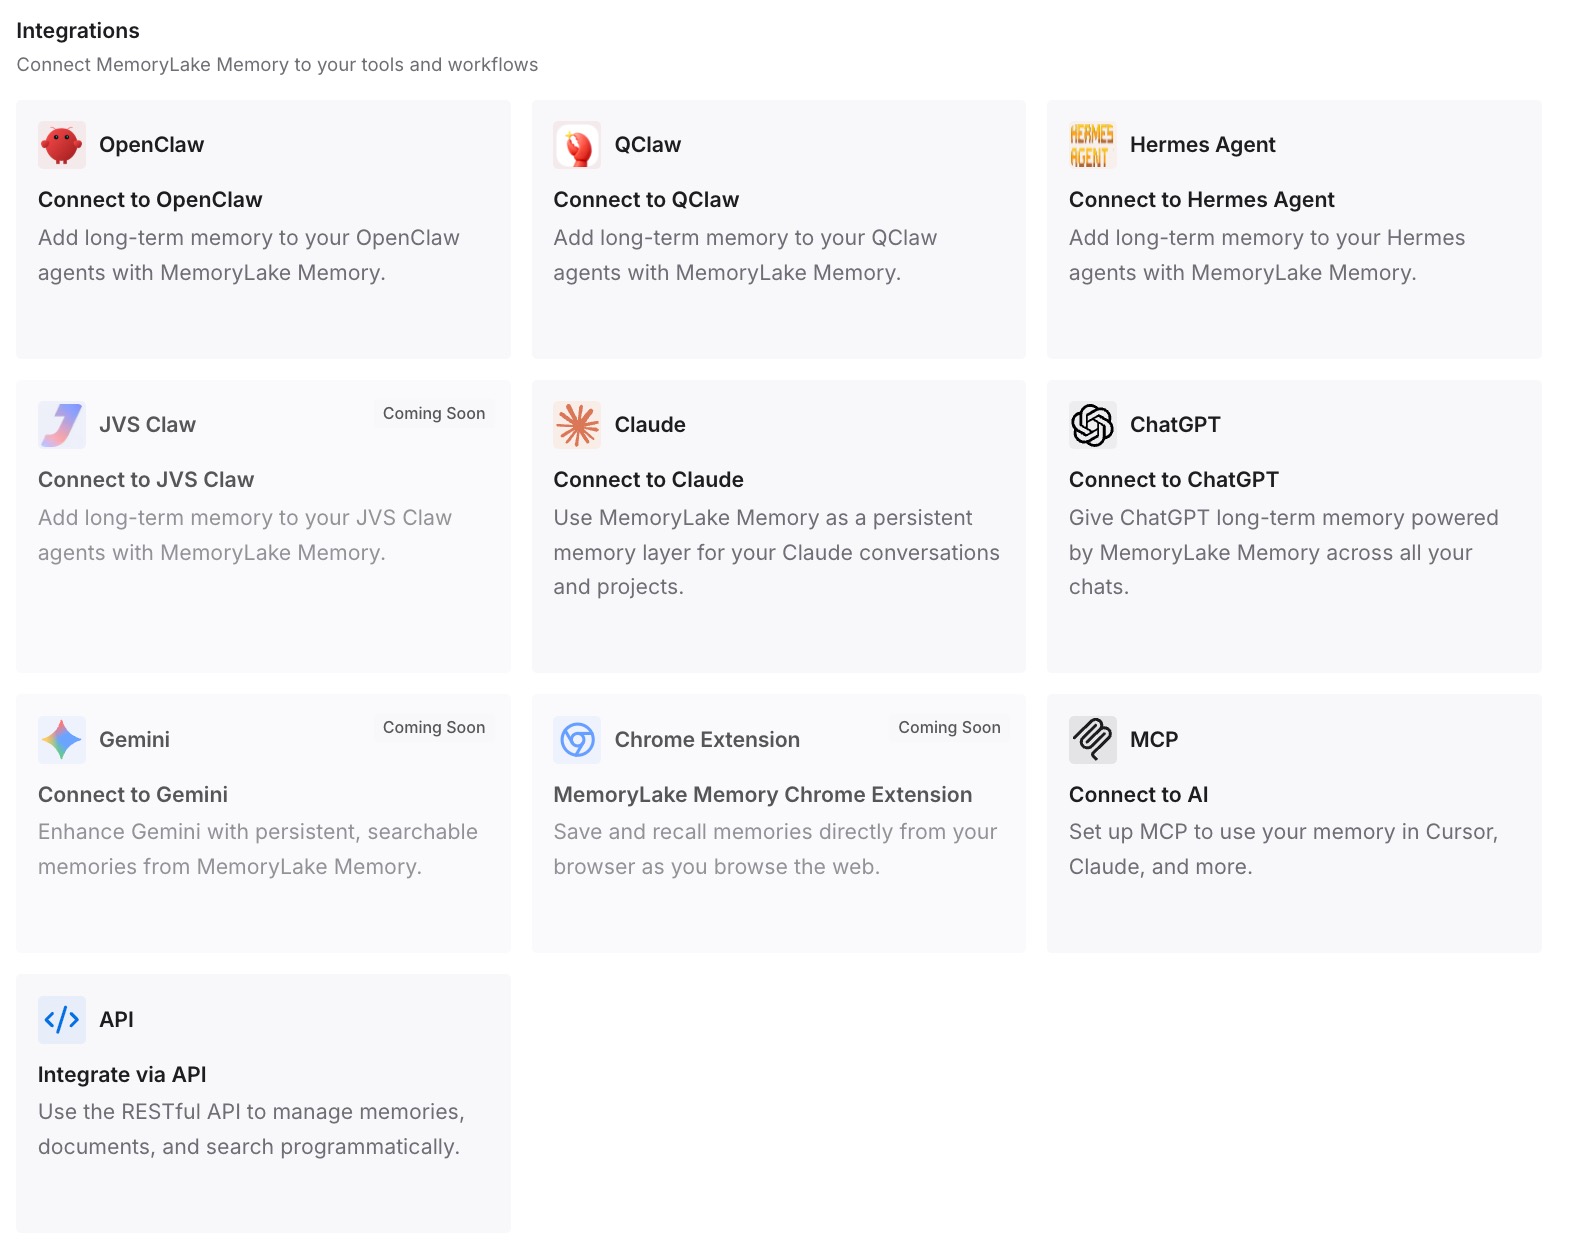
第 3 步:连接您的 AI 和代理
连接 ChatGPT 和您使用的其他助手。无论您在哪里工作,都可以使用相同的陈述事实,并在事实发生变化时在一个地方进行更新。
这在实践中改变了什么
第一个区别是你明确了预期。记忆旨在有帮助时使用,在重要时大声说出来,在不属于它的地方被省略。
第二个区别是你可以让 ChatGPT 遵守它。如果一个回答在草案中泄露了私密细节、将一次性请求视为规则,或声称已经忘记了某事,那么它就违反了规范。
第三个区别是你自己的上下文变得更容易被正确使用。明确说明的长期偏好、纠正后的过时事实以及记录的日期,都让做出正确决策变得更容易。
模型规范更新后 ChatGPT 记忆的最佳实践
明确说明长期偏好。 当你希望某件事持续生效时,使用 从现在开始 等词语。
出现陈旧事实时及时纠正。 规范将旧事实视为证据,而非真理。
使用控制项进行删除,而不仅仅是请求。 在对话中询问会改变行为;设置则会移除信息。
询问回答是基于什么得出的。 规范指出 ChatGPT 应解释它如何使用上下文。
审查草案中的敏感细节。 在发送之前检查任何发给他人的内容。
保持高影响事实的更新。 截止日期、预算和约束条件是旧记忆成本最高的地方。
记住这是一个目标。 规范描述了 OpenAI 如何训练其模型表现,因此请检查结果而不是直接假设。
结论
ChatGPT 并不意味着在每次对话中都使用您的记忆。OpenAI 更新后的模型规范指出,只有在收益大于风险时才应使用上下文:在低风险时静默使用,在重要时说明假设,在敏感时先询问,在无关时完全不使用。它还告诉模型不要声称它无法验证的删除。
此次更新未更改任何设置。您的记忆控制项仍然决定存储的内容,删除操作仍然在那里进行。规范为您提供的是关于记忆上下文应如何呈现的明确标准,以及在 ChatGPT 未能做到时纠正它的理由。