
Anthropic 改变了什么
Claude Code 之前就已经会在对话接近上下文限制时对其进行压缩,总结历史记录以便工作能够继续。该过程是在你工作时运行的。
空闲压缩添加了第二个触发器。Anthropic 的设置参考文档是这样描述的:“空闲压缩会在你离开后、提示词缓存过期前不久,压缩长对话。”它接着写道:“然后,你的下一条消息将发送摘要,而不是整个对话。”
当你返回时,对话会显示 Compacted while idle, before the prompt cache expired(在空闲时、提示词缓存过期前已压缩)。
Lydia Hallie 的公告给出了原因:“它现在会在提示词缓存过期前(约 1 小时)压缩长空闲会话。”如果你稍后返回,Claude 只需要重新处理摘要,而不是整个对话,她说这“可以为你节省一些用量”。在同一个帖子中,她指出了两个控制项:settings.json 中的 "idleCompaction": false 可以关闭该功能,而 CLAUDE_CODE_IDLE_COMPACT_MIN_TOKENS 环境变量可以设置自定义阈值。
空闲压缩何时适用
文档列出了五个条件。所有这些条件都必须满足。
- 会话。 你处于交互式终端会话中。
- 提示词缓存。 对话处于一小时的提示词缓存 TTL(生存时间)上。
- 功能标志。 Claude Code 可以从 Anthropic 获取功能标志。
- 大小。 对话的上下文已达到 token 阈值,默认值为 200,000。
- 空闲时间。 自上一次请求以来已过去约 54 分钟,且此时你的计算机处于唤醒状态。
其中两个条件使受众范围比最初看起来要窄。
一小时缓存取决于你的付费方式。 Anthropic 的提示词缓存页面指出:“除非你自己选择 TTL,否则 Claude Code 仅在你的计划包含的使用量内的 Claude 订阅上请求一小时 TTL。”使用 API 密钥或云提供商时,主对话默认使用五分钟缓存。一旦订阅者超过计划的使用限制并使用使用额度,Claude Code 也会将主对话降至五分钟 TTL。因此,在默认情况下,空闲压缩主要影响在计划内工作的订阅者。
默认阈值主要对 1M token 的会话有影响。 设置参考文档指出:“在默认情况下,200K 上下文窗口上的对话在达到 200,000 个 token 之前就会自动压缩。”换句话说,200K 窗口上的会话通常在空闲压缩适用之前就已经以常规方式压缩了。在默认情况下,符合条件的会话大多是那些使用 100 万 token 窗口运行的会话。
如果你希望在较小的会话上进行空闲压缩,可以降低阈值。文档指出:“低于 100000 的值将被提高到 100000,即最低阈值。”
为什么 Anthropic 添加它:提示词缓存
提示词缓存使 Claude Code 免于在每次请求时重新处理对话中未更改的前缀,但它只能维持一定时间。Anthropic 的文档解释了当它失效时会发生什么:“在足够长的时间间隔后,下一次请求会重新计算完整输入并重新建立缓存,这就是为什么在离开后返回的第一轮对话会明显变慢。”
对于长达数十万个 token 的会话,返回后的第一次请求是昂贵的。空闲压缩在缓存仍然“温热”时总结历史记录,因此你的下一条消息将携带摘要。
Claude Code 针对恢复的会话已经有了这种选择的一个版本。在 Pro 或 Max 计划中,当你恢复一个已处于非活动状态超过约一小时且超过 100,000 个 token 的会话时,Claude Code 会打开一个对话框,提供从摘要恢复或按原样恢复完整会话的选择。文档对这种权衡做出了明确说明:“按原样恢复可以保留对话的每个细节,但每次请求的成本会随着对话的大小而增加。”从摘要恢复在随后的请求中成本较低,“但摘要遗漏的任何内容都将不再存在于 Claude 的上下文之中”。
空闲压缩为你保持打开状态的终端会话提前做出了更便宜的选择。文档描述了你返回时看到的通知,以及改变该行为的设置。它没有描述压缩运行前的提示。如果你想要另一种选择,你需要提前设置。
摘要保留了什么,没有保留什么
压缩后的会话并非空无一物。Claude Code 会从磁盘重建部分上下文,Anthropic 的上下文窗口文档列出了每种内容的处理方式。
从磁盘重新注入: 项目根目录下的 CLAUDE.md 和无范围限制的规则、自动记忆(auto memory),以及 Claude 在计划模式下编写的计划。
按需重新加载: 带有 paths: 前置元数据的规则以及子目录中嵌套的 CLAUDE.md 文件。这些内容会在 Claude 接触到匹配的文件时返回,而不是立即返回。
重新读取: 最多五个 Claude 读取或编辑过的文件,按最近修改时间排序。“超过 5,000 个 token 的文件会作为路径引用返回,而不包含其内容”,因此大文件需要再次读取后 Claude 才能使用其内容。
带上限重新注入: 已调用的技能体(skill bodies),每个技能最多 5,000 个 token,总共最多 25,000 个 token,最旧的先被丢弃。
被总结: 对话中的其他所有内容,包括钩子(hooks)之前添加的上下文。
最后一个类别正是风险所在。你在聊天中陈述的限制、你拒绝某种方法的原因、你正在处理的准确错误输出,以及你四十分钟前做出的决定,都只存在于对话中。压缩后,它们的存在程度完全取决于摘要捕获它们的程度。Anthropic 对 Claude Code 工作原理的概述在谈到常规压缩时也表达了同样的观点:你的请求和关键代码片段会被保留,而“对话早期的详细指令可能会丢失”。
特定路径规则值得单独说明。文档解释说:“当 Claude 读取、写入或编辑其触发文件时,特定路径规则和嵌套的 CLAUDE.md 文件会加载到消息历史记录中,因此压缩会像处理其他所有内容一样将它们总结掉。”它们会在 Claude 下次接触匹配文件时返回,但在此之前,它们是摘要的一部分,而不是规则的一部分。
人们的误解
误以为空闲压缩是一个 Bug。 这是一个有文档记录的默认行为。设置参考文档中列出了它,发布说明中宣布了它,钩子文档也将其包含在 PreCompact 和 PostCompact 钩子的 auto 触发器中。
误以为摘要会保留你一小时前说的话。 摘要仅保留压缩过程判定为重要的内容。项目根目录下的 CLAUDE.md、无范围限制的规则和自动记忆会从磁盘恢复。仅在聊天中做出的陈述可能会被保留,也可能不会。
误以为关闭自动压缩会保持空闲压缩开启。 DISABLE_AUTO_COMPACT 环境变量会同时关闭两者,文档还补充道“手动的 /compact 命令仍然可用”。
解决方案:按项目决定、将重要内容移出聊天,并在返回时检查摘要
步骤 1:决定是否应为此工作运行空闲压缩
对于探索性工作,空闲压缩是一个很好的默认设置,因为在这种情况下,长会话的成本比所说内容的准确措辞更重要。但它不太适合以细节为核心的调试会话。
要关闭它,请在设置文件中设置 "idleCompaction": false。该键可以放在任何设置文件中,因此你可以在某个项目的设置中为该项目关闭它,而在其他地方保持开启。该键需要 Claude Code v2.1.290 或更高版本。“在忽略此键的早期版本上,请关闭 autoCompactEnabled 以停止空闲压缩。”
若要保留它但更改其适用时机,请在设置的 env 块中设置 CLAUDE_CODE_IDLE_COMPACT_MIN_TOKENS。较高的数值会将其限制在最大的会话中。较低的数值(低至 100,000)会将其扩展到 200K 窗口上的会话。
对于单个会话,DISABLE_AUTO_COMPACT 会同时关闭空闲压缩和自动压缩。
如果你使用钩子,带有 auto 匹配器的 PreCompact 钩子也会为空闲压缩以及在达到上下文限制前触发的压缩而触发,阻止它意味着“Claude Code 会跳过它,对话将继续且不进行压缩”。相同的匹配器也适用于常规的自动压缩,因此在依赖它之前请先进行测试。
步骤 2:在你离开之前,将必须保留的内容放在压缩会重新读取的地方
在压缩过程中保留某些内容最可靠的方法是将其排除在对话之外。Anthropic 的建议很直接:“将持久规则放在 CLAUDE.md 中,而不是依赖对话历史记录。”
在长会话的休息时间之前,花两分钟做这些事:
- 将常规规则移至项目根目录下的
CLAUDE.md。 适用于整个任务的限制属于这里。保持文件简短;Anthropic 的记忆指南建议每个文件控制在 200 行以下。 - 将该会话的决定写入一个笔记文件。 每个决定占一行,并写明原因。在
CLAUDE.md中指向它,以便 Claude 知道它的存在。 - 按你自己的方式进行压缩。 如果你宁愿自己选择摘要,请在离开前运行带有焦点的
/compact,例如/compact focus on the auth bug fix。文档对该选项的描述正是关键所在:“摘要会保留你选择的内容,而不是自动过程猜测的重要内容。”
Anthropic 还在 CLAUDE.md 中记录了一个“压缩指令”(Compact Instructions)部分,用于引导压缩保留的内容,本文顶部链接的自动压缩指南介绍了如何编写该部分。
步骤 3:当你看到空闲通知时,在继续之前检查摘要
当你返回并看到 Compacted while idle, before the prompt cache expired 时,不要直接接着之前的思路继续。先检查一下。
- 让 Claude 重新读取你的笔记文件并重新陈述工作状态。 目标是什么、决定了什么、排除了什么、下一步是什么。将回答与步骤 2 中的笔记进行对比。
- 恢复文件中缺失的任何内容,而不仅仅是在聊天中。 如果某个限制没有保留下来,请将其添加到
CLAUDE.md或你的笔记文件中,并重新陈述它,这样下一次压缩就不会再次丢弃它。我们关于 Claude Code 遗忘你的修正的指南更详细地介绍了这种模式。 - 让 Claude 重新读取大文件。 超过 5,000 个 token 的文件会作为引用返回,而不是内容。
- 保留一份摘要副本。
PostCompact钩子会在其compact_summary字段中接收生成的摘要。将其写入文件可以让你准确看到 Claude 正在基于什么进行工作。
要确认缓存发生了什么,在最近的版本中,/usage 中的 Session 块包含一行 Prompt cache (main)。它会报告缓存是否是温热的,并将压缩计为预期的重建。
在 MemoryLake 中设置此功能
步骤 2 中的笔记是长会话中值得保留的部分,其价值超越了任何单次压缩或任何单个会话。MemoryLake 是一个记忆层,用于在你维护的一个列表中保存此类记录,供 Claude Code 和你使用的其他助手使用。
你用自己的话亲自编写这些条目。不会从你的 Claude Code 会话、转录、摘要、自动记忆或任何供应商的存储中读取、写入或删除任何内容。在将项目细节存储在代码仓库之外之前,请先检查你所在组织的政策。
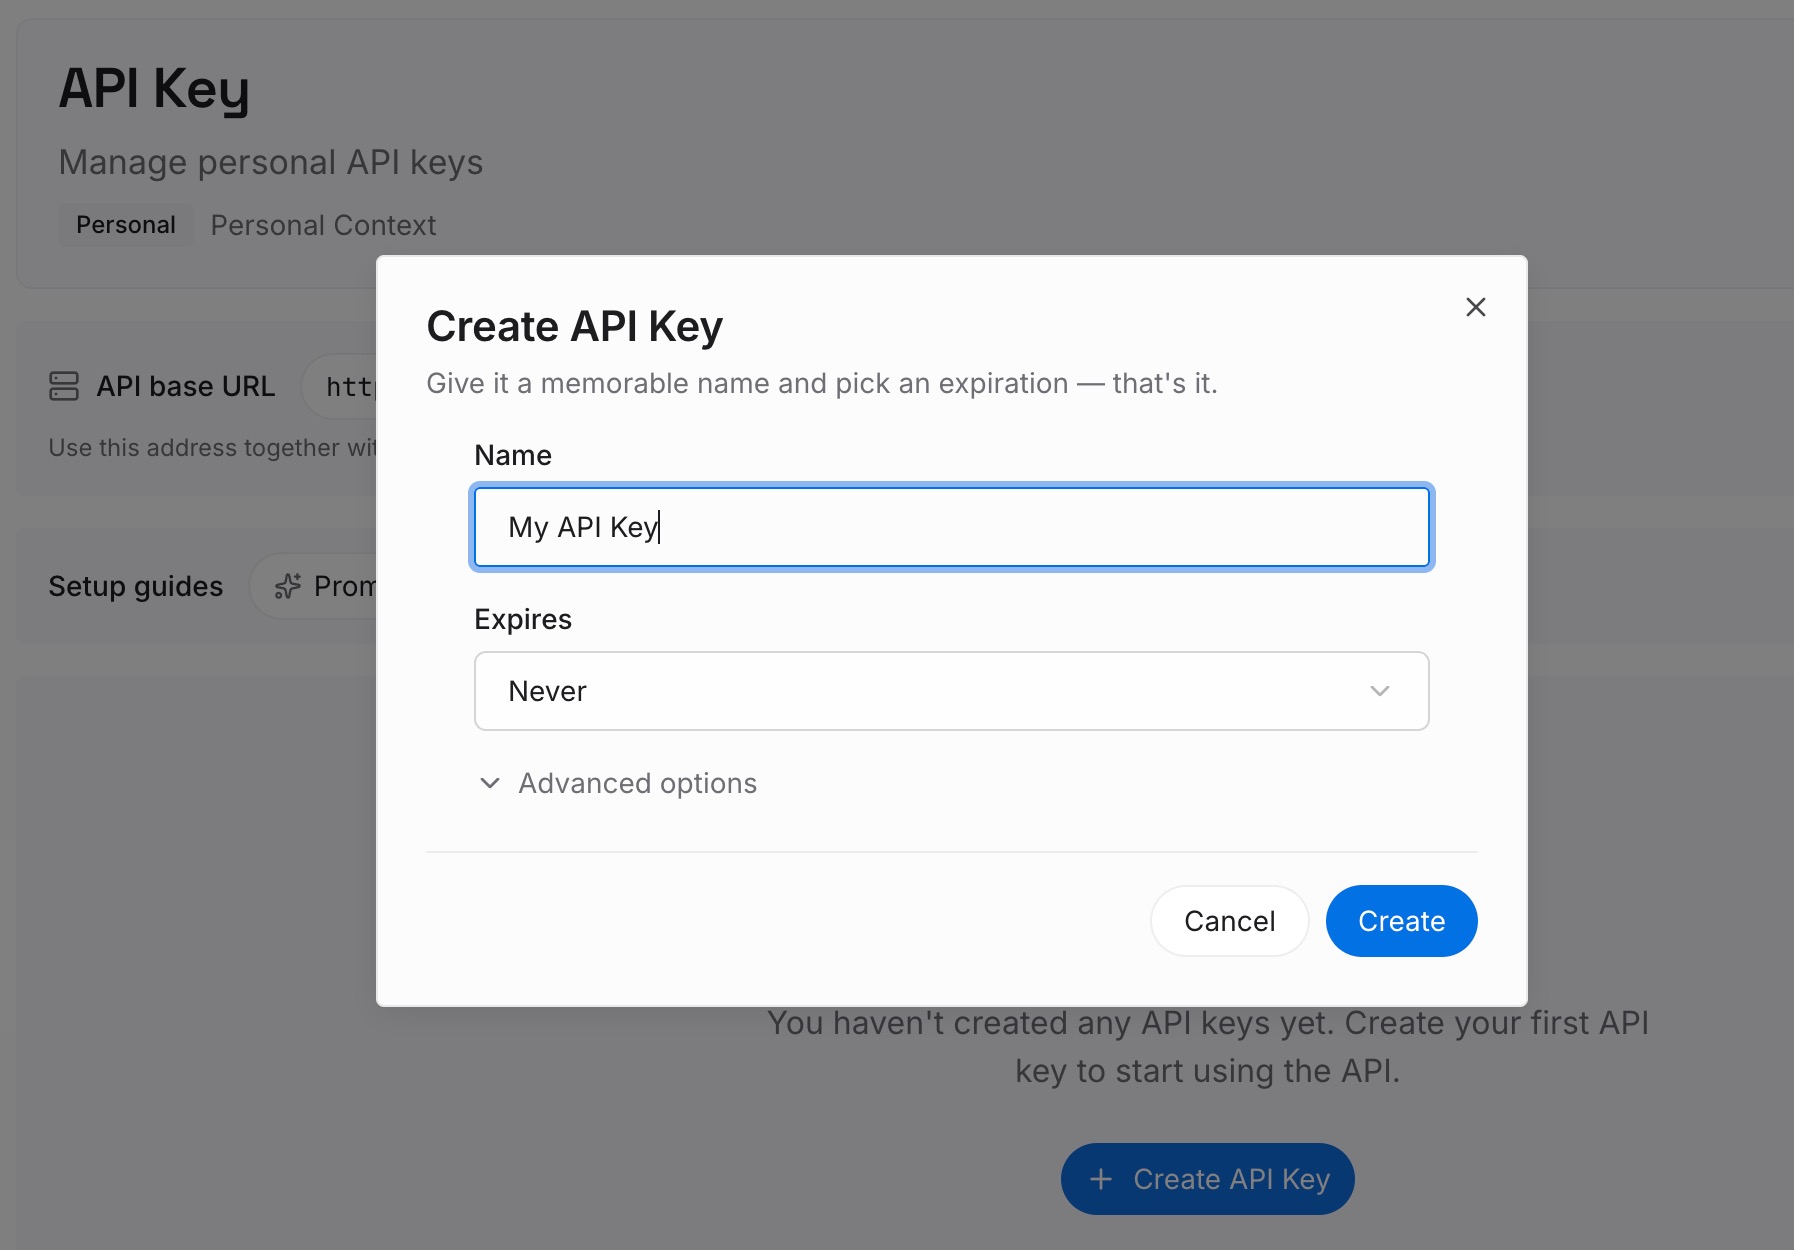
步骤 1:创建 API 密钥
登录并从控制面板生成一个密钥。该密钥属于你的 MemoryLake 工作区,与你的 Anthropic 账户是分开的。
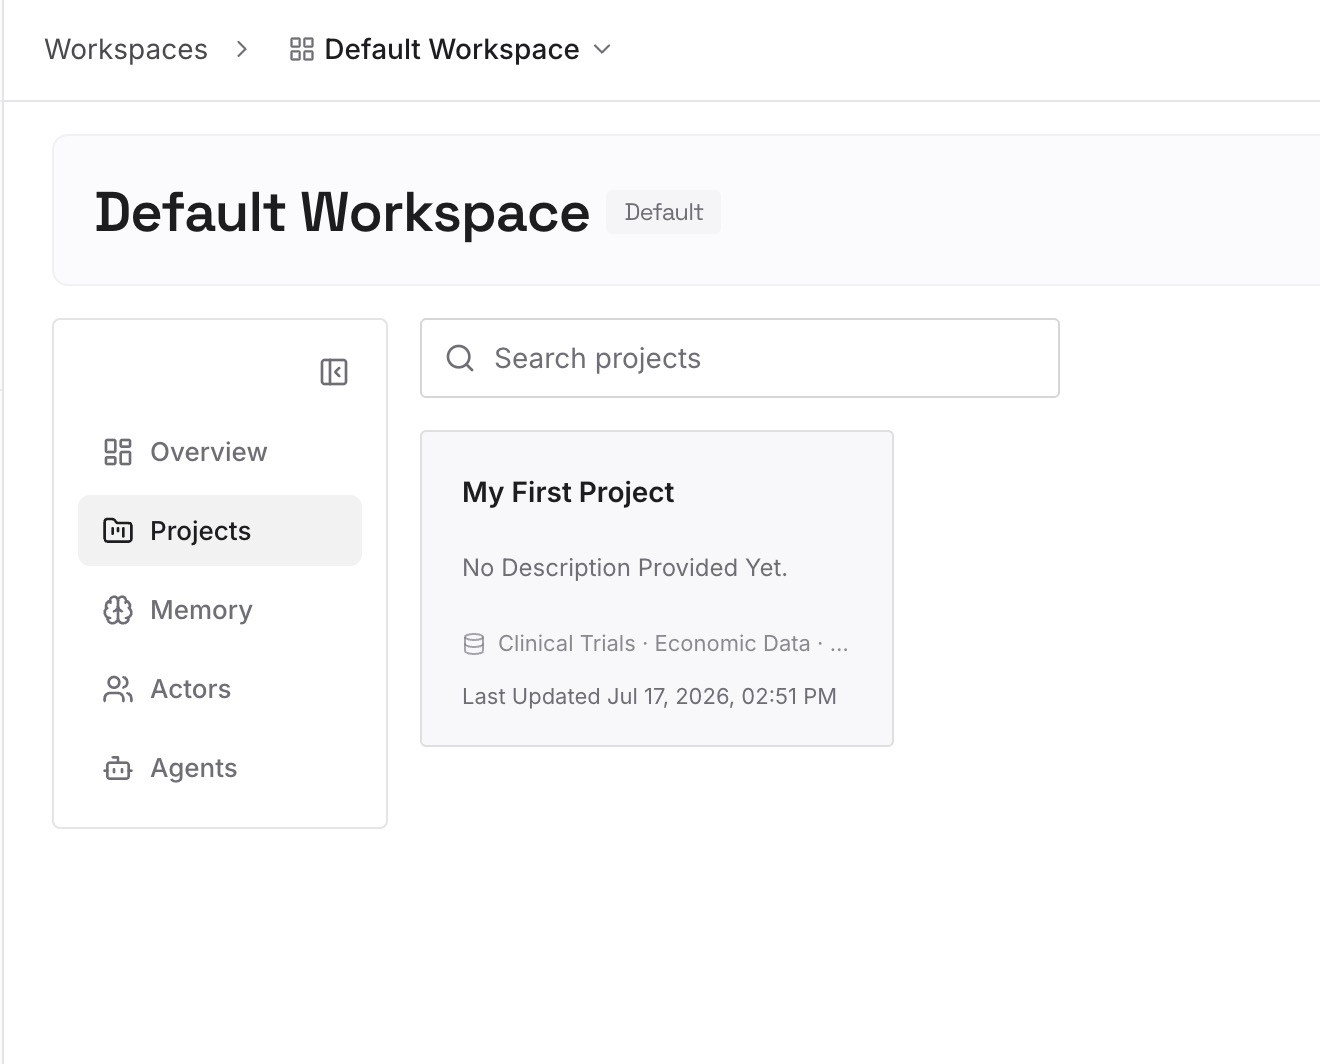
步骤 2:上传你的第一批记忆
从你最不想解释两次的决定开始:不断被遗漏的限制、你排除的方法及其原因、项目所依赖的规范。每个条目记录一个决定,并注明日期。
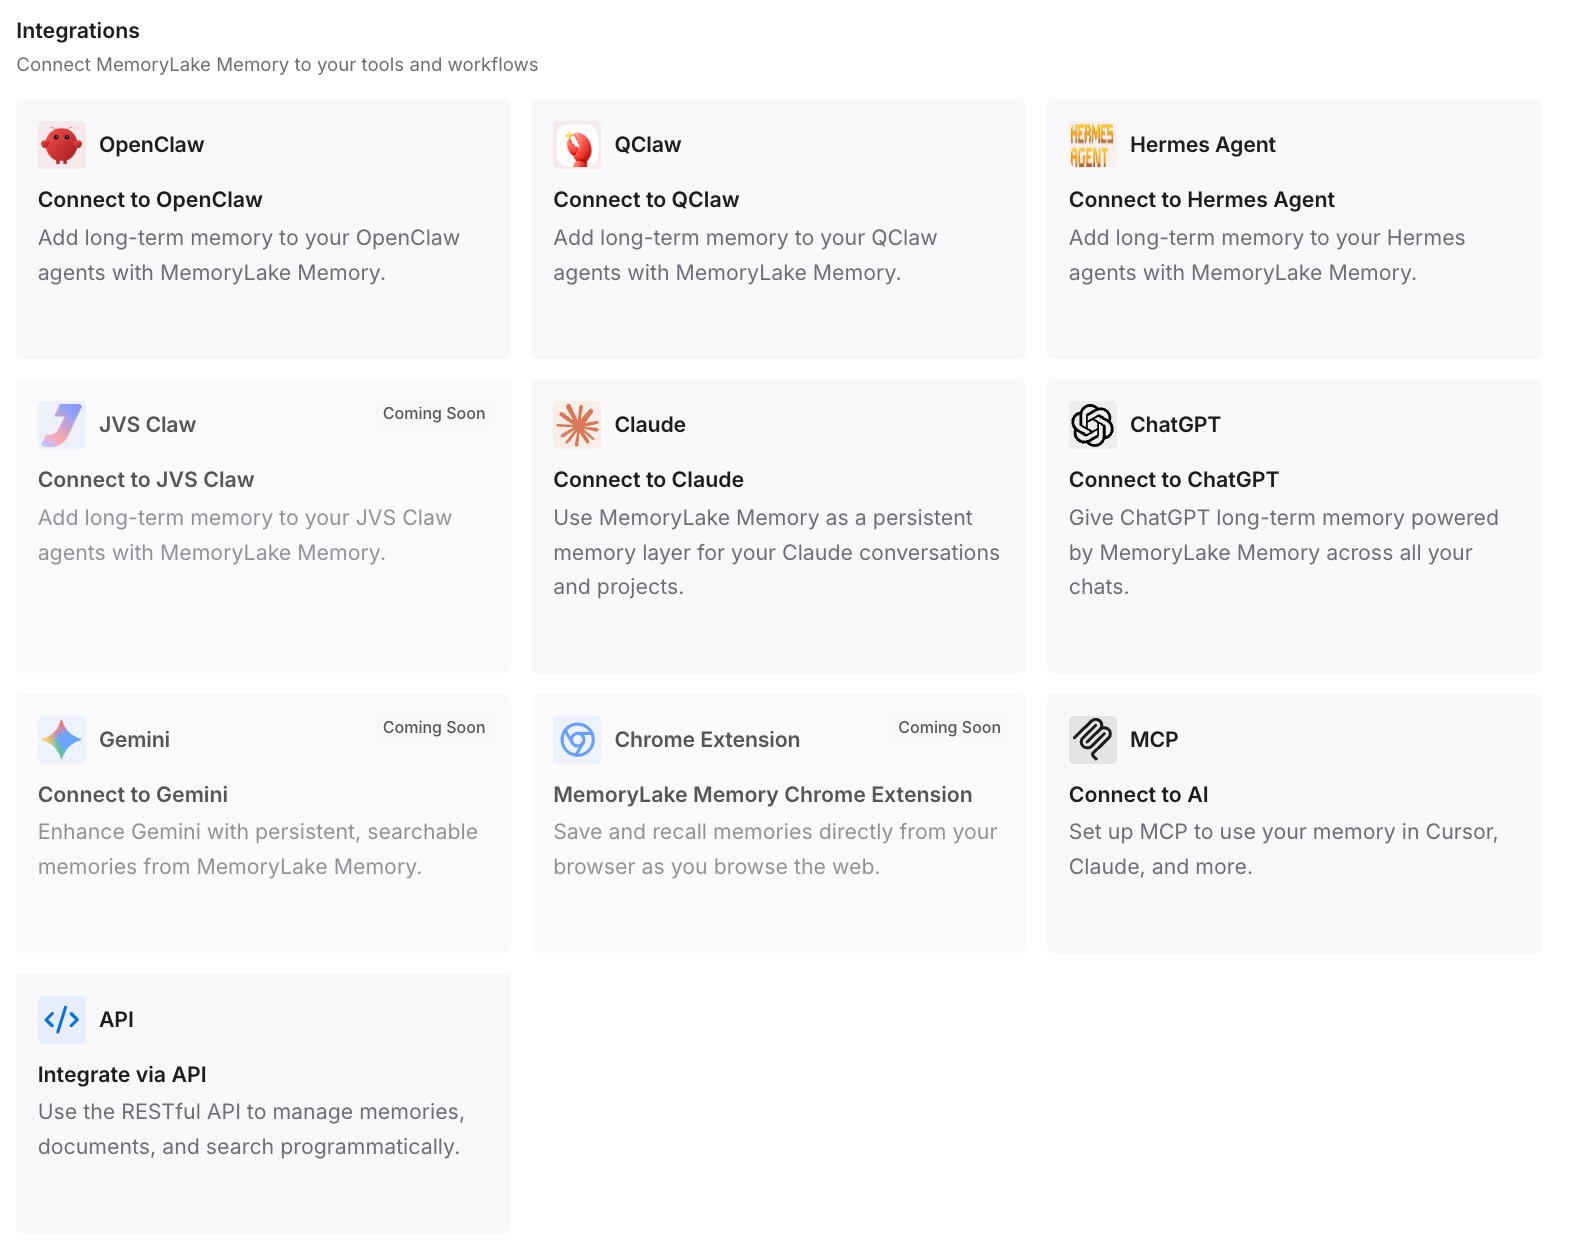
步骤 3:连接你的 AI 和智能体
连接 Claude Code 和你使用的任何其他助手。这样,在每个新会话中都可以使用相同的决定,无论上一个会话是正常结束、在你离开时被压缩,还是在不同的工具中运行。
这在实践中改变了什么
第一个区别是成本。午餐后返回的长会话不再需要在发送第一条消息时进行完整的重新处理,这也是 Anthropic 构建此功能的原因。
第二个区别是,让大型会话保持打开状态不再是无影响的。如果满足条件,你返回时面对的将是摘要。对于许多任务来说这没问题。但对于某些任务,这可能决定了 Claude 是记住某个修复方案被拒绝的原因,还是再次提出该方案。
第三个区别是文件变得更加重要。压缩从磁盘重新读取的内容会完好无损地返回,而且笔记文件只需一次请求即可获取;而仅存在于聊天中的内容,其恢复程度完全取决于摘要捕获它们的程度。正如我们关于 Claude Code 遗忘项目上下文的指南所介绍的,该规则已经适用于常规压缩和新会话。空闲压缩也将其应用到了休息时间。
第四个区别是习惯。在休息前写下决定可以同时防范空闲压缩、常规压缩以及终端关闭,这与我们关于在 Claude Code 会话之间共享上下文的指南背后的理念相同。
长 Claude Code 会话的最佳实践
了解你是否处于一小时缓存中。 使用 API 密钥和默认设置时,主对话使用五分钟缓存,因此不满足空闲压缩的条件。
按项目关闭它,而不是全局关闭。 在调试繁重的代码仓库中使用项目设置,而在其他地方保留默认设置。
在休息前写下决定。 记录一个带日期的笔记文件只需几分钟,而且它在各种压缩中都会保留在磁盘上。
在看到空闲通知后进行检查。 在继续之前,要求重新陈述工作状态。
随工作携带笔记文件。 如果你在另一台机器上继续,该文件也会随之转移,正如我们关于导出 Claude Code 会话的指南所介绍的。
结论
空闲压缩是一个合理的权衡,Anthropic 对此也一直很坦诚。在一小时缓存上空闲约 54 分钟的长会话会在缓存过期前被总结,因此返回后的第一条消息成本更低。代价是 Claude 将从摘要继续,而不是从你的完整上下文继续。
你可以关闭它、更改其阈值或保留它。如果你保留它,应对方法与已经适用于常规压缩的方法相同:在 CLAUDE.md 中写入常规规则、在离开前将决定写入文件,并在继续之前检查 Claude 还记得什么。
其他工具在上下文限制方面也在采取类似的举措,例如 Codex 为 GPT-6.1 Sol 提供的更大默认窗口。更大的窗口和更智能的压缩减少了你遇到该问题的频率。但它们并没有改变持久上下文应该存放的位置。