
Perplexity 发布了什么
这篇名为《为人类和智能体构建共享工作区》(Building shared workspaces for people and agents)的文章从产品出发。Projects 是“人类和智能体在 Perplexity Computer 中协同处理长期任务”的地方,并且“每个项目都位于一个共享工作区上,该工作区拥有一个文件系统,可以跨会话、智能体和用户积累上下文。”
随后,它提出了该工作区的三个要求:
- 持久性(Persistence): “工作应该在任何单个智能体会话或沙箱之外保持持久,以便未来的工作可以由同一用户或智能体继续,并由任何协作者在此基础上进行构建。”
- 并发性(Concurrency): “同一项目中的多个用户可以各自拥有多个并行进行编辑的智能体,从而推进共享状态,而不是相互覆盖。”
- 可追溯性(Traceability): “用户和智能体都应该能够查看历史记录,以便他们可以检查自上次会话以来谁更改了什么,而无需重新阅读整个项目,并在需要时回滚编辑。”
Git 已经为软件团队解决了这些问题,因此 Perplexity 在此基础上进行了构建。“每个 Computer 项目都由一个 Git 仓库支持,该仓库由 5 个组件提供服务”:每个智能体沙箱内的一个小型命令行工具、一个控制平面、一个 Git 服务、AWS S3 上的存储,以及一个从文档中提取文本的下游处理步骤。
文章还指出,智能体不需要“评审界面、分支管理和通知”。仓库是共享状态,而不是代码评审工具。
仓库中保存了什么
仓库保存了您项目的文件。Perplexity 的帮助中心将 Project 描述为将“您的搜索、Perplexity Computer 任务、文件、指令和连接的工具整合在一起”,而文件正是 Git 层所存储的内容。Computer 可以代表您创建和更新它们,具有编辑权限的项目成员可以上传和删除它们。
每个智能体都在自己的副本上工作。“每个智能体都有自己隔离的沙箱。”在沙箱内部,智能体使用本地检出(checkout)进行工作,“对于智能体完成的每个有意义的工作单元,它都会将更改作为提交(commit)进行提交。”由于沙箱是临时的,而存储是持久的,因此崩溃的代价很小:“如果沙箱崩溃,只有未提交的工作会面临风险。”
两个智能体可以同时进行编辑。Git 服务会跟踪最新接受的提交,“当它收到提交时,只有在该提交是基于该 head 构建的情况下才会接受。”如果另一个智能体先到达那里,后到的智能体就会收到 stale-base(基底过期)响应,并且必须“在新 head 之上重放(replay)其更改并重新提交。”Perplexity 的总结是:“这种设计确保了并发智能体不会默默地相互覆盖”。
智能体也会像开发人员一样读取项目。“智能体使用标准的文件系统工具探索加载到沙箱中的仓库版本”,列出文件夹并搜索文件内容,而不是运行固定的检索管道。这对您有一个实际的影响:一个命名清晰、标题明确的文件比埋在冗长会话中的相同事实更容易被智能体找到。
帮助中心设定了空间大小。“每个 Project 最多可容纳 10,000 个文件和 5 GB 的总存储空间,每个文件最大为 100 MB。”在 2026 年 8 月之前创建的项目可能已经超过了该存储限制;它们仍可继续工作,但您无法向其中上传新文件。
历史记录保留了什么
每次被接受的更改都会被记录下来。“对于每次接受的写入,它都会向发件箱(outbox)添加一个条目,这是一个列出仓库、新提交、做出更改的用户以及发生更改的路径的日志。”这就是实践中的可追溯性要求:谁更改了什么。
然而,历史记录并非无限的。Perplexity 对此非常直接:“压缩(Compaction)在限制仓库大小的同时,保持了近期历史记录的可用性。”提交后,Git 服务会检查仓库是否需要压缩,“如果保留的提交数量超过阈值,Git 服务将仅保留较小的一组最新提交。较旧的历史记录将被替换为单个初始快照,并重放最近的提交以更新提交标识符。”
文件本身不会受到此操作的影响。文章的图表指出“新 head 保留了相同的文件。”改变的是您可以追溯到多远。在保留窗口之外,谁更改了哪个文件的逐步记录会被折叠成一个快照。文章并未公布该阈值。
基础设施和界面之间也存在差异。文章将历史记录描述为用户应该能够查看和回滚的内容。然而,Perplexity 帮助中心关于 Projects 的文章描述了文件、限制、共享和 Brain,但并未描述版本历史记录视图或项目文件的恢复按钮。在有官方文档说明之前,请将历史记录视为 Perplexity 的安全机制,而不是您可以浏览的存档。
实际的理解是:仓库是存放当前文件的可靠场所,而历史记录是短期保护。关于团队为什么做出某种决定的记录应该写在文件里,而不是提交日志里。关于版本化记忆的通用情况,请参阅为什么 AI 记忆的每次更改都需要历史记录。
什么存在于仓库之外
这就是 Git 框架可能产生误导的地方。在 Project 中塑造 Computer 回答的几种上下文根本不是项目文件。
从您的文档中解析出的文本
当您添加 PDF 或 Office 文件时,后台解析器会提取其文本。“解析后的输出存在于仓库之外,存储在一个以源文档哈希为键的存储中。这些产物永远不会提交回仓库”。智能体在检出的同时接收解析后的文本,并且“对于 PDF 等文档,智能体首先读取解析后的文本,仅在必要时才下载源文件。”
文章补充道,“解析是异步进行的”,即在后台进行,而不是在智能体检出期间。如果 Computer 似乎遗漏了大文档中的某些内容,我们关于 Perplexity 为什么会遗忘上传文件的指南涵盖了常见原因。
Brain 的记忆
Brain 是人们最常认为与项目存储在一起的部分。文章却给出了不同的说法:“Perplexity Brain(Computer 的知识维基)将记忆存储在拥有自己历史记录和策略的知识仓库中。将知识与项目文件分开意味着后台记忆更新不会与对这些文件的编辑发生冲突。需要这两者的会话会同时加载这两个仓库。”
因此,Project 的记忆和 Project 的文件是两个共同加载的存储。后台智能体维护记忆端:它们“读取现有知识,整合新信息,并将更新后的页面保存为提交。”
帮助中心在两种语境下描述了 Brain,值得将它们区分开来。在账户级别,Brain“正在向使用 Computer 的 Max 和 Enterprise Max 订阅者推出研究预览版”,并且“Brain 仅从您自己的活动中学习——它绝不会拉取任何其他人的数据,并且完全忽略无痕会话。”在 Project 内部,Perplexity 的 Memory 文章描述了一个共享层:“项目中的每个人都会看到相同的 Brain。它是一个维基:贡献者可以编辑它,查看者可以阅读它,项目所有者控制记忆开关。”它还补充道,“Brain 仅在 Computer 会话中可用。Search 无法访问 Brain。”
由此产生两个结果。Brain 的条目可以被编辑,这很好,并且“每个条目都链接回其来源,因此您可以检查或纠正它。”而且由于 Brain 在每次运行中都会“标记过时的内容”,它是一个不断变化的动态模型,而不是固定的记录。计费遵循所有者:“自动 Brain 更新使用 Project 所有者的额度。”
个人记忆
您自己的记忆是第三个存储,它是否在 Project 中适用取决于一项设置。Projects 文章描述了一个仅限所有者控制的选项“使用会话创建者的记忆”(Use session creator's memory),该选项决定了查询是否可以“提取启动该会话的人的个人记忆”。Memory 文章阐明了其效果:“当它开启时,项目中的每个会话还会提取启动该会话的人的个人记忆。当它关闭时,项目中的会话仅使用共享的 Brain。”
其具体表现取决于订阅计划。在个人账户上,“一旦 Project 拥有其他成员,它就无法使用成员'的个人记忆。”在 Enterprise 计划上,“除非您组织的记忆设置不允许,否则可以在共享的 Projects 中使用个人记忆。”在那里,两个队友在同一个 Project 中提出相同的问题,可能会获得不同的上下文,这取决于谁启动了该会话。
Enterprise 记忆文章用不同的措辞描述了这一点,即“在此项目中引用个人会话”(Reference personal sessions in this project)选项,并指出在 Project 内部记录的记忆“范围仅限于该 Project——它们不会流入您的全局记忆。”如果您使用的是 Enterprise,请检查您的 Project 设置显示的是哪个控制选项。
来自连接器的文件
您从连接的应用中拉取的文件不会与原始文件保持链接。“您从连接的源添加的文件是一次性副本。如果您在连接的应用中更新或删除原始文件,您 Project 中的副本不会改变。”帮助中心建议通过连接器请求 Perplexity 获取最新版本,或者重新添加该文件。
人们的误区
误以为历史记录是完整的存档。 压缩会将较旧的提交折叠成一个快照。当前文件得以保留,但谁更改了什么的长期记录则不复存在。
误以为 Brain 存在于项目文件中。 它是一个独立的知识仓库,与项目文件一起加载。
误以为共享 Project 中的每个人都会得到相同的答案。 在 Enterprise 上,开启会话创建者的记忆后,每个会话都可以提取不同人的记忆。
误以为连接器能保持文件最新。 连接器文件是一次性创建的副本。
解决方案:将决定保留在文件中,检查 Brain 保存的内容,并刷新复制的内容
步骤 1:将您团队依赖的决定写入项目文件中
如果某些内容必须对 Project 中的每个人都保持有效,请将其写入 Project 中的文件中,而不是留在会话中。保留一个简短的决定文件:决定了什么、何时决定、由谁决定以及为什么。使用清晰的名称将其保存为纯 Markdown 格式,以便搜索文件夹的智能体能够找到它。
将 Project 的指令用于规定 Computer 应该如何工作,而不是用于记录发现。帮助中心允许“最多 8,000 个字符”的指令,并建议了诸如“首选的响应格式或保持更新的状态文件”等用途。状态文件正是属于仓库的那类内容。
步骤 2:检查 Brain 和个人记忆为 Project 添加了什么
如果您的计划包含 Brain,请打开 Brain 选项卡,或新布局中的 Sources > Brain,并阅读它当前保存的内容。纠正任何错误;帮助中心表示您的纠正将应用到下一次运行中。然后检查 Project 的 Memory 设置:Brain 是自动更新还是手动更新,以及会话创建者的记忆是否开启?
在 Enterprise 上,如果 Project 是共享的,并且团队内部的回答需要保持一致,请考虑关闭会话创建者的记忆,以便每个会话都基于相同的共享 Brain 和相同的文件工作。这是一个权衡决定。在您主要独自使用的 Project 中,个人记忆可能会很有用。
步骤 3:刷新连接器副本,并将原因记录在提交日志之外
列出您 Project 中来自连接器的文件,并决定哪些文件需要保持最新。当源发生变化时重新添加这些文件,或者在依赖它们之前请求 Perplexity 获取最新版本。
然后,将重要决定背后的推理保存在不依赖于保留提交窗口的地方。您在 Project 内部的决定文件就可以做到这一点。对于您希望跨多个 Projects 和工具使用的上下文,独立的存储效果更好。如果您同时在整合较旧的 Perplexity 工作,我们关于迁移 Perplexity 聊天历史记录的指南展示了如何导出它。
在 MemoryLake 中进行设置
Project 的文件、历史记录和 Brain 都存在于 Perplexity 内部,每个 Project 都是一个独立的空间。那些比单个 Project 寿命更长的决定需要一个属于它们自己的家。MemoryLake 是一个记忆层,用于将它们保存在您维护的一个列表中,供 Perplexity 和您的其他助手使用。
您可以用自己的语言亲自编写这些条目。不会从您的 Perplexity Projects、Brain、个人记忆或任何供应商的存储中读取、写入或删除任何内容。如果您的 Project 包含客户或公司的工作,请在将细节复制到其他任何地方之前检查您组织的政策。
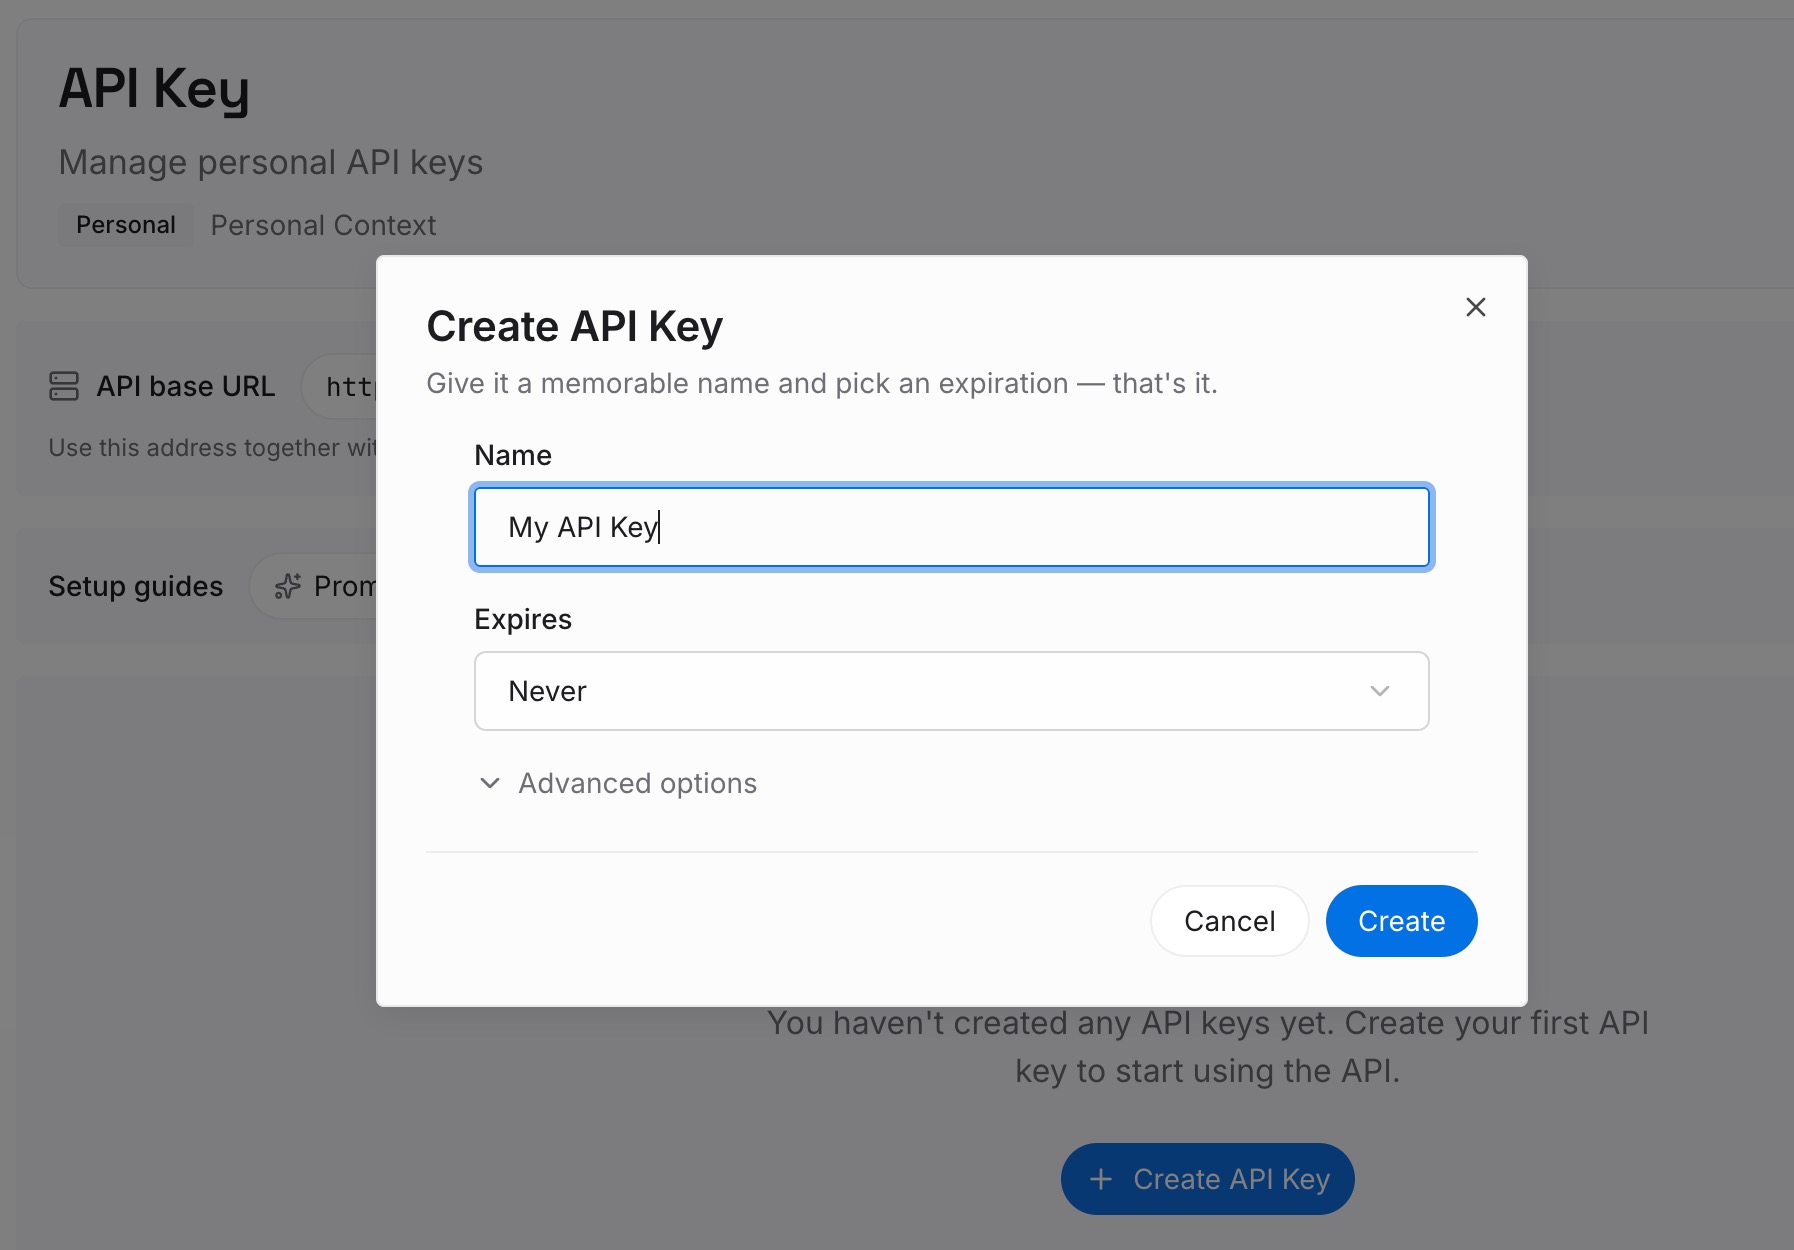
步骤 1:创建 API 密钥
登录并从控制面板生成一个密钥。该密钥属于您的 MemoryLake 工作区,与您的 Perplexity 账户是分开的。
步骤 2:上传您的第一批记忆
从您 Project 的决定文件开始。每个条目记录一个决定,注明日期、原因以及它来自的 Project。
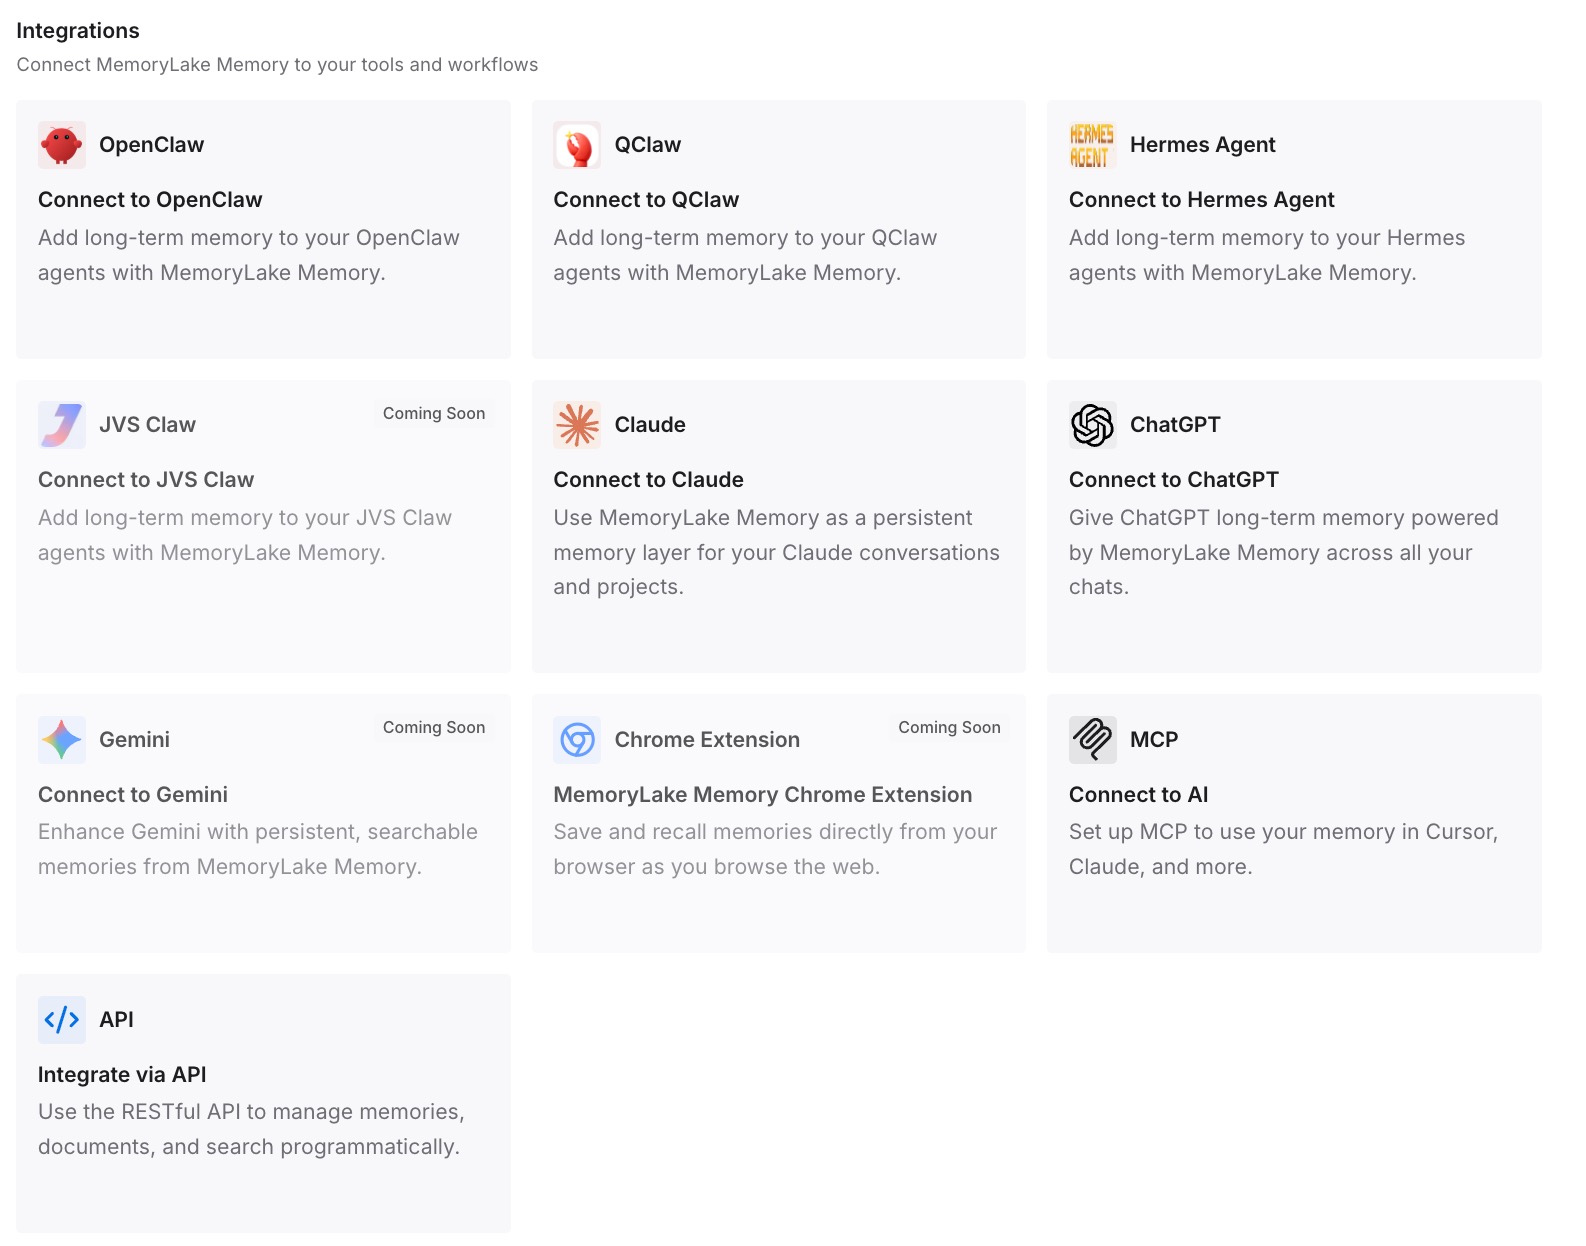
步骤 3:连接您的 AI 和智能体
连接您使用的助手。然后,相同的决定就可以在新的 Perplexity Project 或其他工具中使用,而无需依赖单个 Project 的 Brain 或历史记录。
这在实践中改变了什么
第一个区别是知道什么是可以信赖的。Project 中的当前文件是持久的,并且受到保护,免受默默覆盖。它们背后的历史记录则是短期的。
第二个区别是共享工作中的意外更少。一旦您知道 Brain 和个人记忆是独立的存储,就更容易解释为什么一个队友的会话知道一些另一个队友不知道的事情。同样的拆分也出现在其他地方:Claude Code Projects 也将项目记忆与仓库分开,并且 Devin 的记忆存在于其自己的 Git 仓库中。
Perplexity Projects 的最佳实践
将决定写入文件中。 会话和历史记录并不是正式记录。
定期阅读 Brain。 在对照其来源的情况下纠正条目。
针对每个 Project 决定是否使用个人记忆。 共享 Project 通常需要将其关闭。
刷新连接器文件。 它们是一次性创建的副本。
注意存储限制。 超过限制的较旧 Projects 无法进行新的上传。
将跨 Project 的知识保存在其他地方。 每个 Project 都是一个独立的空间;正如我们关于 Perplexity 遗忘 Spaces 内容的指南所解释的那样,较旧的 Spaces 内容也会引发相同的问题。
结论
Perplexity 10 月 12 日的文章证实了每个 Project 都由一个 Git 仓库支持。智能体从它们自己的沙箱中进行提交,与另一个更改发生冲突的更改会被重放,而不是被默默覆盖,并且每次被接受的更改都会记录是谁做出的。
有两个限定条件至关重要。一旦历史记录增长超过阈值,它就会被压缩,较旧的提交会被折叠成单个快照。此外,有几种上下文存在于仓库之外:解析后的文档文本、Brain 的知识仓库、个人记忆以及连接器副本背后的原始文件。
将仓库视为当前文件的归宿,将您的决定写入这些文件中,并将您以后需要的推理保存在任何压缩步骤都无法触及的地方。