
Lo que realmente publicó Anthropic
El escenario está documentado con claridad. Los ingenieros de Anthropic "envían 8 veces más código por trimestre de lo que hacían entre 2021 y 2025", y "escribir código ya no es la limitación, y una vez que se acelera la revisión de las PR, la CI empieza a sentir la presión". Mientras tanto, "la cantidad de pruebas en nuestra base de código creció 10 veces y añadimos una cantidad nominal de ingenieros". El resultado: "Nuestro volumen de tareas de CI aumentó 25 veces en 6 meses".
En lugar de ejecutar cada prueba en cada cambio, Anthropic creó lo que la publicación llama un "análisis determinista de impacto de pruebas o servicio de selección de pruebas que determina qué pruebas se ejecutan en cada cambio en función del rendimiento pasado y la relevancia del paquete". Consta de dos partes. "Un “listener” (oyente) registra los resultados de las pruebas de cada ejecución de CI". "Un “selector” lee el historial de resultados de las pruebas y determina qué pruebas se ejecutan en cada PR abierta".
Ese diseño de dos partes es toda la historia. Un componente registra lo que sucedió. El otro lee lo que se escribió y decide a partir de ello. Mientras el escritor mantenga el ritmo de la realidad, las decisiones del lector están fundamentadas. Cuando el escritor se queda atrás, nada se rompe: el lector simplemente sigue decidiendo, con confianza, a partir de un registro que ya no coincide con el mundo.
Y efectivamente se quedó atrás. "el listener empieza a quedarse cada vez más rezagado respecto a la cola de PR". La magnitud es específica: "20 minutos de retraso del listener pueden traducirse en decenas de miles de actualizaciones de pruebas que no se aplican al selector". También lo es la causa: "Todo esto se ejecutaba como un único proceso porque mantener un historial continuo por prueba significaba que un único escritor necesitaba aplicar los resultados", lo que "nos impidió poder realizar una fragmentación horizontal (horizontal sharding)".
Luego viene el párrafo. Al describir cómo impulsó la solución a largo plazo, Malhotra escribe: "Inicié una sesión de larga duración en una versión interna de Claude Tag dedicada a monitorear el servicio". Estaba basada en eventos: "Cada vez que el retraso del listener superaba las 50,000 tareas, Claude me enviaba un ping y reanudaba nuestra conversación sobre los siguientes pasos". Y luego la línea que importa: "Esto continuó durante meses, y fue de gran ayuda no tener que recordarle constantemente los esfuerzos pasados o el contexto".
Añade una frase más en la que vale la pena detenerse: "Claude a menudo abogaba por una reforma completa, pero normalmente nos conformábamos con otro parche".
Lo que esto cambia y lo que no
Seamos precisos sobre lo que se afirma, porque es fácil exagerarlo.
Anthropic no está anunciando un producto de memoria aquí. La publicación es una retrospectiva de ingeniería sobre la selección de pruebas, y la sesión en cuestión se ejecutó en una versión interna de una herramienta interna. Nada en ella dice que así sea como deba trabajar cualquier otra persona, y nada describe una función que puedas activar.
Anthropic también tiene cuidado de no exagerar los daños. Cuando el servicio se quedó muy atrás, la publicación dice: "Para ser claros, esto no significa que la CI nunca se ejecutara en esas PR, o que se enviara código no probado a producción". Lo que ocurrió fue más acotado: el selector estaba "utilizando datos obsoletos para decidir qué ejecutar y qué no en las PR". Esa es una descripción honesta y delimitada de un fallo, y merece ser citada en lugar de dramatizada.
Lo que la publicación sí establece son dos cosas, ambas de primera mano.
La primera es que una decisión que tardó meses en tomarse se mantuvo unida gracias a una conversación que no se reinició. El valor mencionado no es la inteligencia ni la velocidad. Es "no tener que recordarle constantemente los esfuerzos pasados o el contexto", es decir, el coste de restablecer el punto en el que ya te encontrabas. Cualquiera que haya reabierto un hilo de hace seis semanas y haya pasado veinte minutos reconstruyendo por qué se rechazó la respuesta obvia en la segunda semana conoce ese coste.
La segunda es que la misma publicación, de manera completamente independiente, describe lo que sale mal cuando un registro escrito se queda atrás respecto a las decisiones que se toman a partir de él. El retraso era invisible. No produjo errores. Produjo decisiones seguras a partir de un estado obsoleto.
Esas dos observaciones son la misma observación, apuntando en direcciones opuestas. Cuando el registro se mantiene al día, meses de debate siguen siendo coherentes. Cuando se queda atrás, cada decisión posterior se degrada silenciosamente y nada te lo advierte.
Lo que la gente deducirá de esto, y no debería
"El contexto largo resuelve esto". No lo hace, y la publicación muestra accidentalmente por qué. Una sesión que se ejecuta durante meses a través de un número desconocido de alertas no es un problema de ventana de contexto; es una cuestión de qué sobrevive entre activaciones. Explicamos esa distinción por separado en por qué una ventana de contexto largo no es memoria.
"Así que la recuperación sobre los registros de chat habría funcionado". La recuperación encuentra texto que se asemeja a tu consulta. Lo que impulsó este argumento fue una postura consolidada: que una reforma estaba justificada, que se habían probado tres parches y que cada uno ganó menos tiempo que el anterior. Eso es una conclusión, no un fragmento de texto, y buscar en las transcripciones para encontrarla es una operación diferente a retenerla. Marcamos esa línea en por qué RAG no es memoria.
"Anthropic demostró que los agentes deberían decidir la arquitectura". La publicación dice lo contrario, sutilmente. Claude abogó por la reforma repetidamente y fue desautorizado una y otra vez por humanos con otras prioridades, y la publicación enmarca el acuerdo final como la propia lección del ingeniero: "planifica siempre para lo exponencial". La contribución de la sesión fue la continuidad, no la autoridad.
"Esta es una historia de agentes de codificación". El mecanismo no tiene nada que ver con el código. Que una capa de registro se quede atrás de una capa de decisión es lo que sucede cuando el resumen almacenado de tus preferencias por parte de tu asistente se escribió en junio y cambiaste de opinión en agosto. No aparece ningún error. Las respuestas simplemente se vuelven sutilmente incorrectas.
La solución: escribe la conclusión, no solo la conversación que la produjo
La razón por la que funcionó una sesión de meses es que preservó una pequeña cantidad de hechos consolidados a lo largo de una gran cantidad de interrupciones. Puedes obtener esa propiedad deliberadamente, sin depender de que la sesión de ningún proveedor en particular permanezca abierta.
Paso 1: Separa el registro continuo de la postura consolidada
Al final de cualquier debate que abarque más de una sesión, quedan dos artefactos. Está la transcripción, que es larga y consiste principalmente en opciones que rechazaste. Y está la postura, que es corta: qué se decidió, qué se probó, cuánto costó y qué cambiaría la respuesta.
Escribe la postura en prosa, con tus propias palabras, separada de la transcripción. Cuatro o cinco frases suelen ser suficientes. "Probamos con una máquina más grande; duró unos setenta días. Probamos la fragmentación por paquete; duró aproximadamente un mes. Probamos reinicios diarios; duró un día. El siguiente paso es un rediseño, no un cuarto parche".
Ese párrafo es lo que realmente aportó una sesión de meses. El resto fue andamiaje.
Paso 2: Pon fecha a la postura y registra a qué reemplazó
El modo de fallo en la publicación de Anthropic es un registro que se quedó atrás sin anunciarlo. Tus propias notas fallan de la misma manera: envejecen mientras tú te actualizas, y nada marca esa brecha.
Así que, cuando una postura cambie, no la sobrescribas silenciosamente. Escribe la nueva postura, anota la fecha y mantén una línea sobre a qué reemplaza. "A partir de marzo, reiniciar ya no se considera una solución". Un hecho almacenado que sabe a qué reemplazó se puede verificar; uno que no, solo se puede creer. Si nunca has analizado cómo se resuelven las versiones contradictorias en tu propio almacenamiento, vale la pena entender primero la detección de conflictos de memoria.
Paso 3: Colócalo en un lugar que la siguiente sesión pueda leer sin que se lo digan
La última propiedad lo hace duradero. La sesión de Anthropic funcionó porque el asistente ya tenía el contexto cuando envió el ping; nadie volvió a informarle a las 2 a.m. cuando se activó la alerta de retraso.
Reproduce eso manteniendo la postura en un almacenamiento que tus herramientas lean al inicio del trabajo, en lugar de un documento que debas recordar pegar. La prueba es sencilla: abre una conversación completamente nueva, en cualquier asistente, y pregunta qué se decidió. Si tienes que explicarlo primero, la postura no está almacenada, solo está escrita. Esa distinción es el tema de compartir contexto entre sesiones.
Configuración de esto en MemoryLake
MemoryLake existe para ser esa capa independiente y direccionable: un almacén para las decisiones que deseas que cada asistente ya tenga, en lugar de un lugar que acceda al producto de otra persona. Tú mismo escribes las entradas, con tus propias palabras. No se extrae nada de los sistemas de Anthropic, de los sistemas de OpenAI ni del almacén de ningún otro proveedor, y nada aquí lee, restaura o modifica lo que esos proveedores poseen.
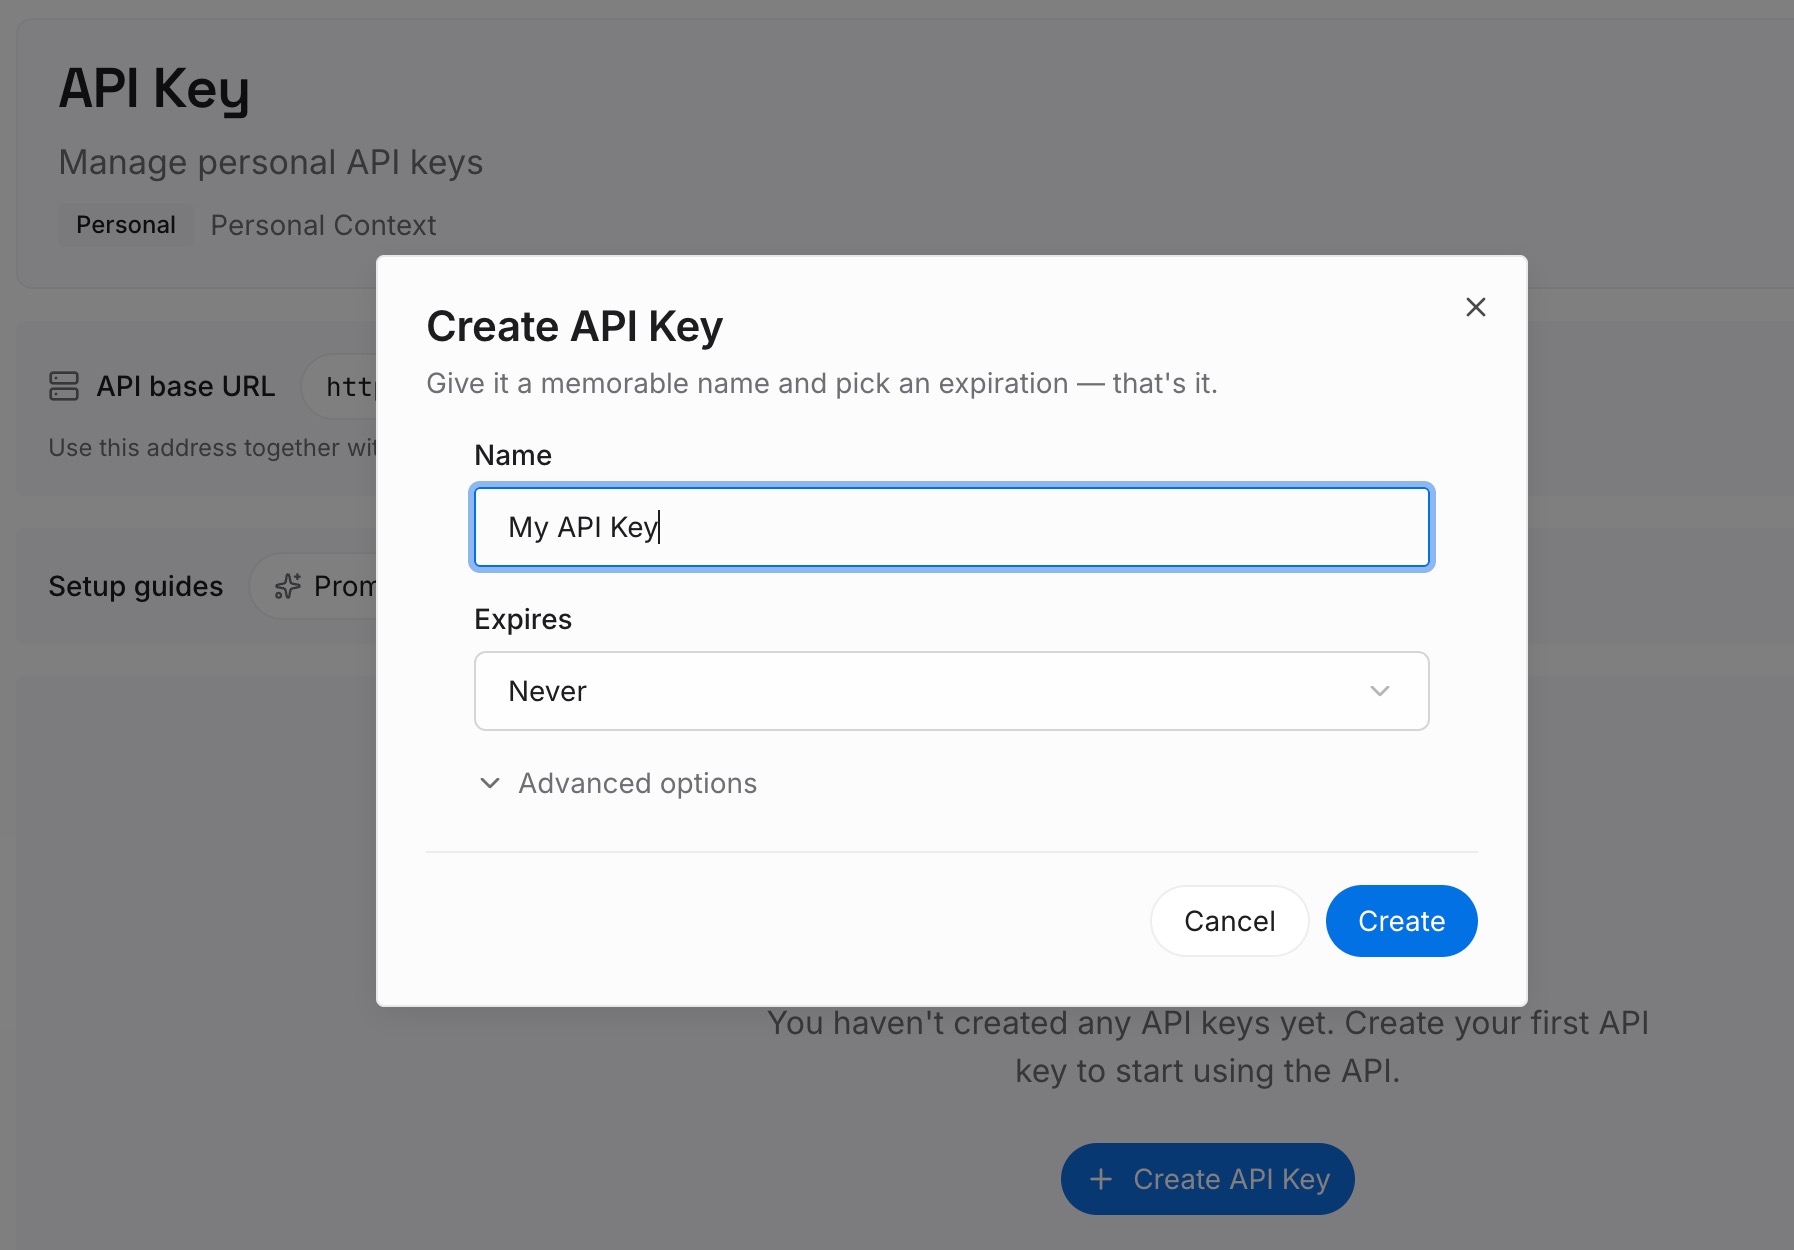
Paso 1: Crea una clave API
Inicia sesión y genera una clave desde el panel de control. La clave es lo que permite a tus asistentes y agentes llegar a la misma capa, de modo que cada interfaz lea un único conjunto de posturas en lugar de lo que sea que esté en el propio historial de esa herramienta.
Paso 2: Sube tus primeros recuerdos
Comienza con las posturas, no con las transcripciones. Toma los dos o tres debates actualmente activos en tu trabajo (el arquitectónico, el de procesos, el de con qué proveedor te estás estandarizando) y escribe cada uno como un párrafo corto con fecha, detallando qué se probó y cuánto costó. Eso es lo más valioso que puedes almacenar, porque es lo que más tiempo lleva reconstruir.
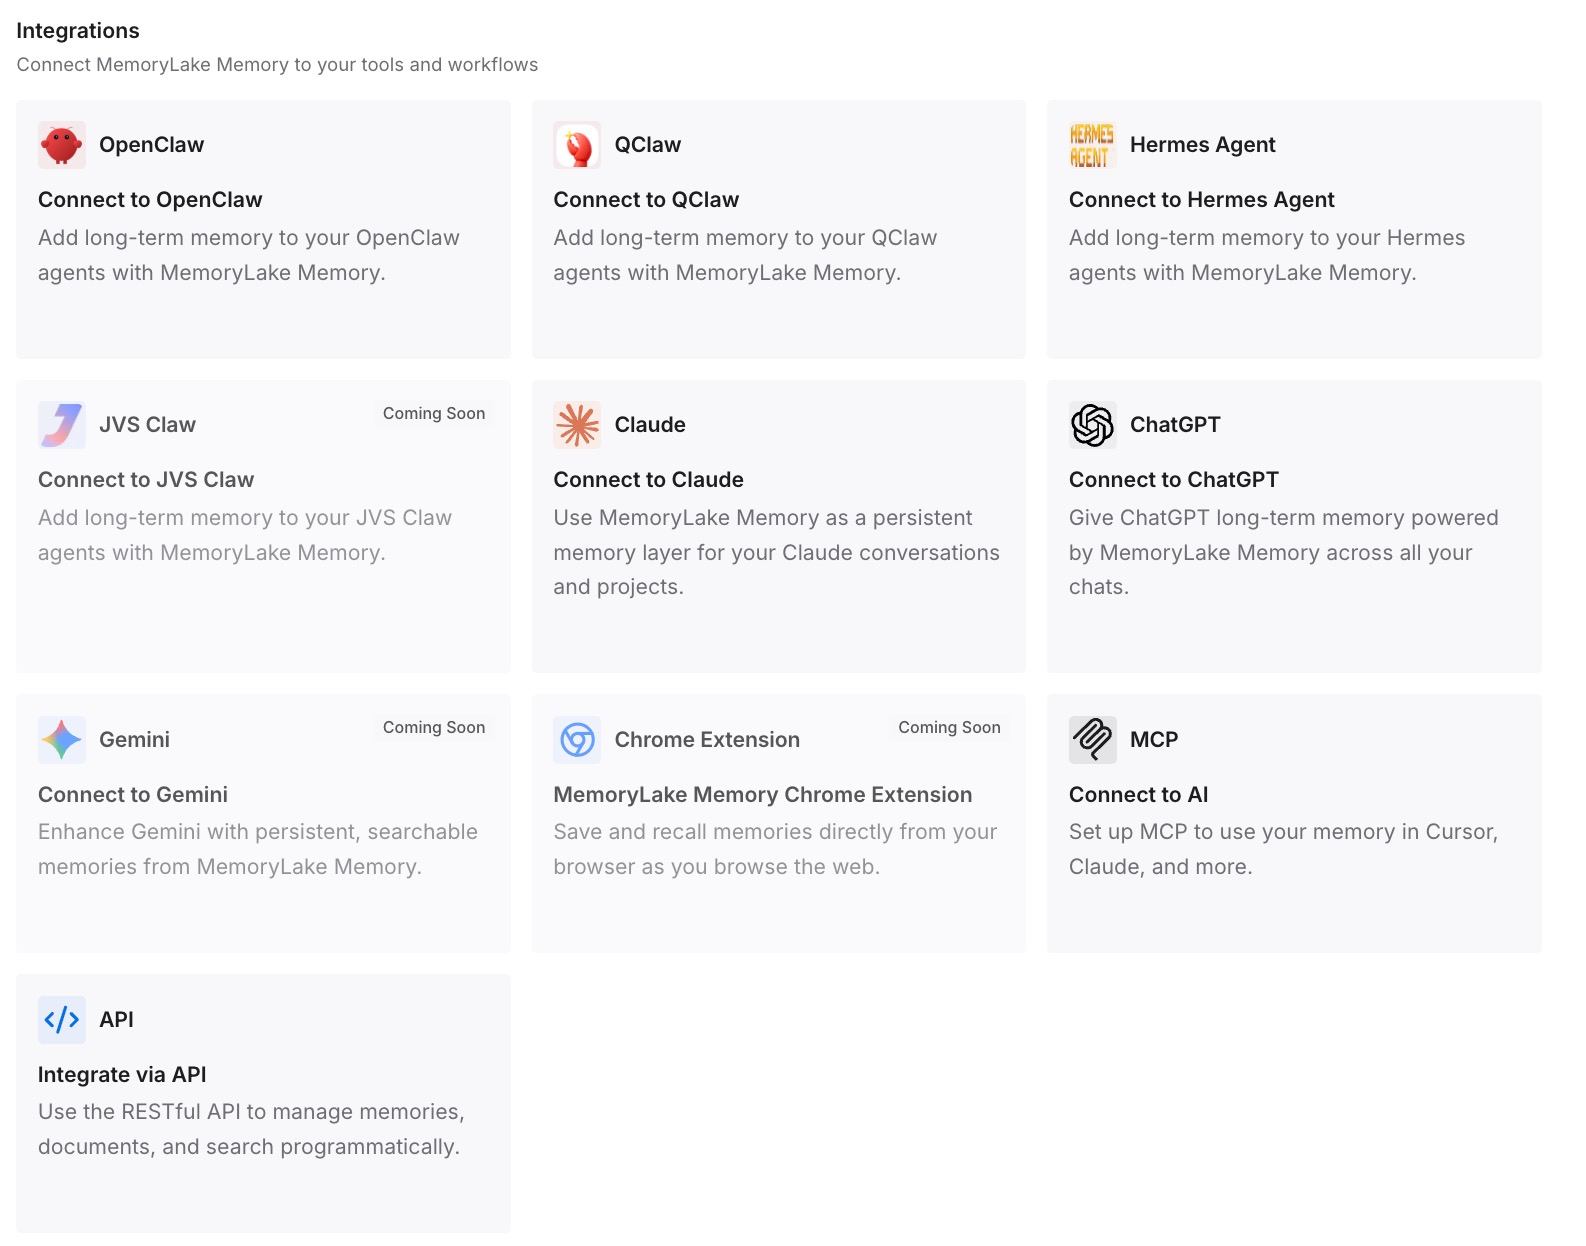
Paso 3: Conecta tu IA y agentes
Apunta tus asistentes a la capa para que las posturas se carguen al inicio de una sesión en lugar de tener que pegarlas en ella. Luego, verifícalo abriendo una conversación genuinamente nueva y preguntando cuál es la postura actual. Que te la devuelva es la única prueba de que la conexión funciona; un panel que muestre un estado en verde no es lo mismo.
Lo que esto cambia en la práctica
La diferencia práctica se manifiesta en los momentos en que no ocurre nada.
Un debate de meses no es una conversación de meses. Son quizás quince interacciones reales a lo largo de cien días, con semanas de silencio entre ellas. El silencio es donde las posturas se corrompen. Alguien prueba algo, no funciona, pasa a otra cosa y, tres semanas después, vuelve a surgir la misma sugerencia porque el coste del último intento nunca se escribió en ningún lugar duradero.
La publicación de Anthropic señala lo mismo sobre una máquina en lugar de una persona: cuando el registro se retrasó más de una hora, "el listener no registró un montón de resultados de tareas" y el selector siguió decidiendo de todos modos. Nada alertó. Las decisiones simplemente empeoraron.
La segunda diferencia es la escala de atención. La publicación señala que "los agentes realizan envíos por la noche y los fines de semana, pero sigue siendo intermitente ya que los ingenieros humanos todavía impulsan y aprueban una cantidad significativa de PR". El nivel mínimo de actividad ha subido; los humanos no han ganado horas. Si estás supervisando más trabajo en más interfaces, la proporción entre volver a informar y pensar determina si puedes hacerlo en absoluto, lo cual es en realidad una pregunta sobre cuánta memoria se le debe dar a un agente de IA.
La tercera es la auditabilidad. El rediseño funcionó porque el equipo finalmente pudo ver el retraso como un número. Tus posturas merecen el mismo tratamiento: un almacén que puedas leer de principio a fin y decir "esto está actualizado, esto está obsoleto, esto contradice aquello". Si nunca has hecho esa revisión, auditar lo que tu IA realmente recuerda es por donde empezar.
Buenas prácticas para mantener legible una decisión de meses
Escribe la postura al final de la sesión, no al comienzo de la siguiente. Nunca tendrás más contexto sobre por qué se rechazó una opción que en los diez minutos posteriores a haberla rechazado.
Manténlo en prosa. Un punto de viñeta que diga "fragmentación: no funcionó" es inservible en ocho semanas. "La fragmentación por paquete permitió que cada trabajador fuera propietario de una sección; aguantó aproximadamente un mes antes de que volviera el retraso" sigue siendo útil en un año.
Almacena el coste, no solo el resultado. La publicación de Anthropic es memorable porque indica cuánto duró cada parche. "No funcionó" invita a reintentarlo. "Ganó veintinueve días" pone fin al debate.
Nombra qué te haría cambiar de opinión. Una postura con un desencadenante declarado se invalida a sí misma de una manera útil. Sin él, volverás a discutirla cada vez que llegue alguien nuevo.
No almacenes la transcripción como el registro. La transcripción es la evidencia. La postura es el registro. Confundirlas es la forma en que los almacenes se vuelven grandes e inútiles a la vez.
Revisa las posturas periódicamente. El retraso de Anthropic era invisible hasta que se medió. El tuyo también lo es.
Conclusión
El hallazgo principal es que la codificación agéntica supuso veinticinco veces más carga para la CI de Anthropic en medio año, y que parchear tres veces un servicio de un solo escritor fue un peor uso del tiempo de ingeniería que reconstruirlo una vez, una reconstrucción que "le llevó tres semanas a un solo ingeniero".
El hallazgo más silencioso está en el método. El argumento para esa reconstrucción se elaboró a lo largo de meses, por un asistente al que no hubo que recordarle en qué punto se encontraba el debate, frente a un humano que seguía eligiendo el parche. Ganó porque se mantuvo coherente durante más tiempo que las objeciones.
Eso no es una característica de ninguna herramienta en particular. Es una propiedad de mantener la conclusión separada de la conversación, con fecha y legible por lo que sea que abras a continuación. Anthropic lo obtuvo de una sesión que casualmente no terminó. Tú puedes obtenerlo a propósito.