
La respuesta corta
Ambos agentes parten de la memoria que has construido en el chat y ambos mantienen sus tareas en la misma cuenta que tus chats.
Anthropic describe un flujo bidireccional en términos claros: en las sesiones en la nube de Cowork, "Claude comienza a partir de lo que ya recuerda de tus chats, y lo que surge en una tarea de Cowork se transfiere de vuelta al chat".
OpenAI describe Work como parte del propio ChatGPT: "ChatGPT incluye Chat y Work". Work "utiliza la configuración de memoria disponible para tu cuenta y espacio de trabajo", y los chats de Chat y Work se encuentran en el mismo historial.
Las diferencias están en los bordes: qué sucede cuando el trabajo se ejecuta localmente, cómo los proyectos delimitan la memoria y qué transfiere una tarea programada o compartida.
De un vistazo
| ChatGPT Work | Claude Cowork | |
|---|---|---|
| Comienza desde tu memoria de chat | Sí, bajo la configuración de memoria de tu cuenta y espacio de trabajo | Sí, en sesiones en la nube |
| Lo que una tarea añade a la memoria | Sigue la configuración de memoria de ChatGPT | Se transfiere de vuelta al chat |
| Historial | Compartido con Chat en Recientes | Lista de tareas en Cowork, misma cuenta de Claude |
| Proyectos | Compartidos con Chat; memoria predeterminada o solo del proyecto | Compartidos con Claude; cada proyecto tiene su propia memoria |
| Trabajo local | Aplicación de escritorio, con archivos que autorices | La aplicación de escritorio accede a tu computadora para sesiones en la nube |
| Tareas programadas | Programación, activador o monitoreo | Se ejecutan en la nube con una cadencia |
Cómo maneja cada uno la memoria
ChatGPT Work
Work es un modo de ChatGPT, no un producto separado. La documentación de memorias de OpenAI dice que "ChatGPT Work utiliza la configuración de memoria disponible para tu cuenta y espacio de trabajo; no utiliza un almacén de memoria Codex local ni controles de memoria locales". Las memorias guardadas y, cuando tu configuración lo incluye, la referencia a chats pasados funcionan de la misma manera que en Chat.
Las preguntas frecuentes sobre memoria explican cómo se relacionan esas dos piezas: "Las memorias guardadas se almacenan por separado del historial de chat". Si tu configuración incluye Referenciar historial de chat, activarlo "permite que ChatGPT use información relevante de conversaciones pasadas para personalizar respuestas futuras".
El historial también se comparte. "Los chats de Chat y Work aparecen juntos en Recientes, donde puedes ordenar, filtrar y fijar chats". Work también puede incorporar "proyectos, memorias, la Biblioteca de ChatGPT y complementos instalados" cuando recopila contexto para una tarea.
Lo que hace bien: una sola cuenta, un solo historial, un solo conjunto de configuraciones de memoria en Chat y Work, por lo que no hay una segunda memoria que gestionar.
Claude Cowork
Cowork comparte la memoria de Claude con el chat. El anuncio de Anthropic lo expresó claramente: "A partir de hoy, la memoria que usas en el chat es la misma que en Claude Cowork". El centro de ayuda describe ambas direcciones: "Lo que Claude recuerda de tus chats está disponible cuando le entregas una tarea en Cowork en la nube, y lo que surge en una tarea de Cowork se transfiere de vuelta al chat".
La memoria de Claude se actualiza mientras trabajas. Anthropic dice que "Claude ahora añade temas a la memoria a medida que chateas, en lugar de resumir las conversaciones después de que terminan". Y es visible: "Todo lo que Claude recuerda está en una lista de archivos bajo Temas en la configuración de Memoria, donde puedes leer, editar o eliminar cada uno".
Puedes ejecutar una sola tarea sin memoria desactivándola en el menú de la tarea antes de enviar tu primer mensaje. Anthropic señala que "Tu configuración de memoria se establece cuando comienza la tarea y no se puede cambiar más tarde".
Lo que hace bien: un flujo bidireccional explícito entre el chat y las tareas, con la memoria organizada por temas que puedes leer y editar archivo por archivo.
Dónde difieren más
Cuando el trabajo se ejecuta en tu computadora
Ambos agentes pueden acceder a tu computadora a través de sus aplicaciones de escritorio, y ambos almacenan el contexto de la tarea en la nube.
Para Work, OpenAI señala que "Los mensajes y el contexto de la tarea pueden almacenarse en la nube, incluso cuando el trabajo se ejecuta localmente". En el escritorio, Work puede usar los archivos y aplicaciones que autorices. Nuestra guía para mantener el contexto entre la nube de ChatGPT Work y el entorno local cubre esa división en detalle.
Para Cowork, el vínculo de memoria está ligado a la nube. El centro de ayuda dice que "La memoria entre Cowork y el chat solo funciona cuando Cowork se ejecuta en la nube. No está disponible en las sesiones de Cowork que se ejecutan localmente en tu computadora". Cowork ahora ejecuta tareas en la nube y accede a tu computadora a través de la aplicación de escritorio cuando una tarea necesita un archivo local o tu navegador. El artículo de inicio señala que las sesiones locales en los planes Pro y Max eran tareas iniciadas en tu computadora antes del 6 de octubre.
Cómo los proyectos delimitan la memoria
Ambos productos tienen proyectos, y ambos permiten que un proyecto mantenga su memoria separada.
Los proyectos de ChatGPT ofrecen dos configuraciones. "Los proyectos pueden usar la memoria predeterminada o la memoria solo del proyecto". Con la memoria solo del proyecto, OpenAI dice que "la información de ese proyecto se elimina de la memoria utilizada fuera del proyecto". Los proyectos compartidos "se configuran automáticamente con memoria solo del proyecto y no se pueden cambiar a memoria predeterminada". Nuestra guía sobre los modos de memoria de proyectos de ChatGPT recorre lo que permite cada configuración.
Los proyectos de Claude, que "funcionan de la misma manera en Cowork y en Claude", tienen cada uno su propia memoria. "Lo que Claude aprende en un proyecto no se transfiere a otros proyectos". Un proyecto comparte memoria con tus chats fuera de los proyectos a menos que desactives la configuración de memoria de la cuenta en la página del proyecto.
Los enfoques terminan en un lugar similar: los proyectos pueden aprovechar tu memoria más amplia o mantenerse separados.
Con qué comienza una tarea programada
Ambos agentes ejecutan trabajos recurrentes.
OpenAI dice que "Work también puede ejecutarse una vez, repetirse según un programa o activador, o monitorear cambios a través de Tareas Programadas". Los activadores de eventos incluyen nuevos mensajes de Gmail, mensajes de canales de Slack y actividad de pull requests de GitHub en planes elegibles.
Anthropic dice que las "Tareas programadas de Cowork se ejecutan en la nube, sin ningún dispositivo en línea". Debido a que se ejecutan en la nube, se sitúan en el lado de Cowork donde la memoria se comparte con el chat. Nuestra guía sobre las tareas programadas y la memoria de Cowork cubre cómo controlar esto por tarea.
Qué transfiere el uso compartido
Cuando compartes una tarea programada de Work, OpenAI es específico: compartir "no transfiere tu historial de chat, archivos locales, carpetas, acceso a dispositivos, credenciales de aplicaciones conectadas, memorias guardadas, instrucciones personalizadas o permisos del espacio de trabajo". El destinatario programa una copia separada con su propio acceso.
Por el lado de Claude, el uso compartido de proyectos en los planes Team y Enterprise otorga a los miembros acceso al conocimiento y las instrucciones de un proyecto en el nivel de permiso que elijas.
Lo que la gente intenta primero
Asumir que una tarea comienza de cero. En ambos productos, una tarea puede comenzar a partir de la memoria que construiste en el chat, sujeto a tu configuración.
Asumir que todo lo que aprende una tarea se guarda. En Claude, lo que surge en una tarea de Cowork en la nube se transfiere de vuelta al chat; en ChatGPT, el guardado sigue tu configuración de memoria. La memoria no es un registro completo en ninguno de los productos; el propio chat de la tarea contiene los detalles.
Esperar que las sesiones locales de Cowork compartan memoria. Anthropic dice que la memoria entre Cowork y el chat funciona en la nube.
Tratar la memoria del proyecto como memoria de la cuenta. Ambos productos pueden delimitar la memoria a un proyecto.
Comparar solo por benchmarks. Para el trabajo continuo, el lugar donde reside tu contexto importa tanto como qué modelo ejecuta la tarea.
La solución: Verifica qué sabe cada agente, delimítalo a propósito y mantén lo esencial donde tú lo controles
Paso 1: Pregunta al agente qué sabe antes de una tarea importante
Al inicio de una tarea en cualquiera de los productos, pide al agente que enumere en qué se está basando: memorias sobre ti, los archivos e instrucciones del proyecto, y cualquier cosa de chats pasados que considere relevante. Corrige lo que esté mal antes de que comience. En Claude, también puedes abrir la configuración de Memoria y editar los archivos de temas directamente; en ChatGPT, gestiona la memoria desde Configuración > Personalización.
Paso 2: Decide qué tareas deben usar memoria
Para trabajos sensibles o puntuales, ejecuta la tarea sin memoria. En Cowork, desactiva la memoria en el menú de la tarea antes de tu primer mensaje. En ChatGPT, usa un proyecto con memoria solo del proyecto o ajusta tu configuración de memoria. Para trabajos continuos, coloca la tarea en un proyecto para que su contexto se mantenga unido.
Paso 3: Mantén las decisiones de las que dependes en un solo lugar
Ambos agentes mantienen el contexto dentro de su propio producto. Si usas ambos, o te mueves entre ellos, las decisiones y convenciones en las que confías tienen que ser reconstruidas en cada lado. Mantén una lista corta de ellas en algún lugar que controles y úsala para informar a cualquier agente con el que estés trabajando.
Configurando esto en MemoryLake
ChatGPT Work y Claude Cowork conectan cada uno una tarea a la memoria que has construido en el producto de chat de esa empresa, y cada uno recurre a la memoria de su propia empresa.
MemoryLake es una capa de memoria para mantener el contexto en el que confías en una lista que tú mantienes, disponible para ChatGPT y los otros asistentes que conectes, como Claude Code y Codex.
Tú mismo escribes las entradas, con tus propias palabras. No se lee nada, ni se escribe, ni se elimina de ChatGPT, Claude, Cowork, tus proyectos, tus memorias guardadas o el almacén de cualquier proveedor. Para el contenido de trabajo, sigue la política de tu organización sobre lo que guardas fuera de sus herramientas.
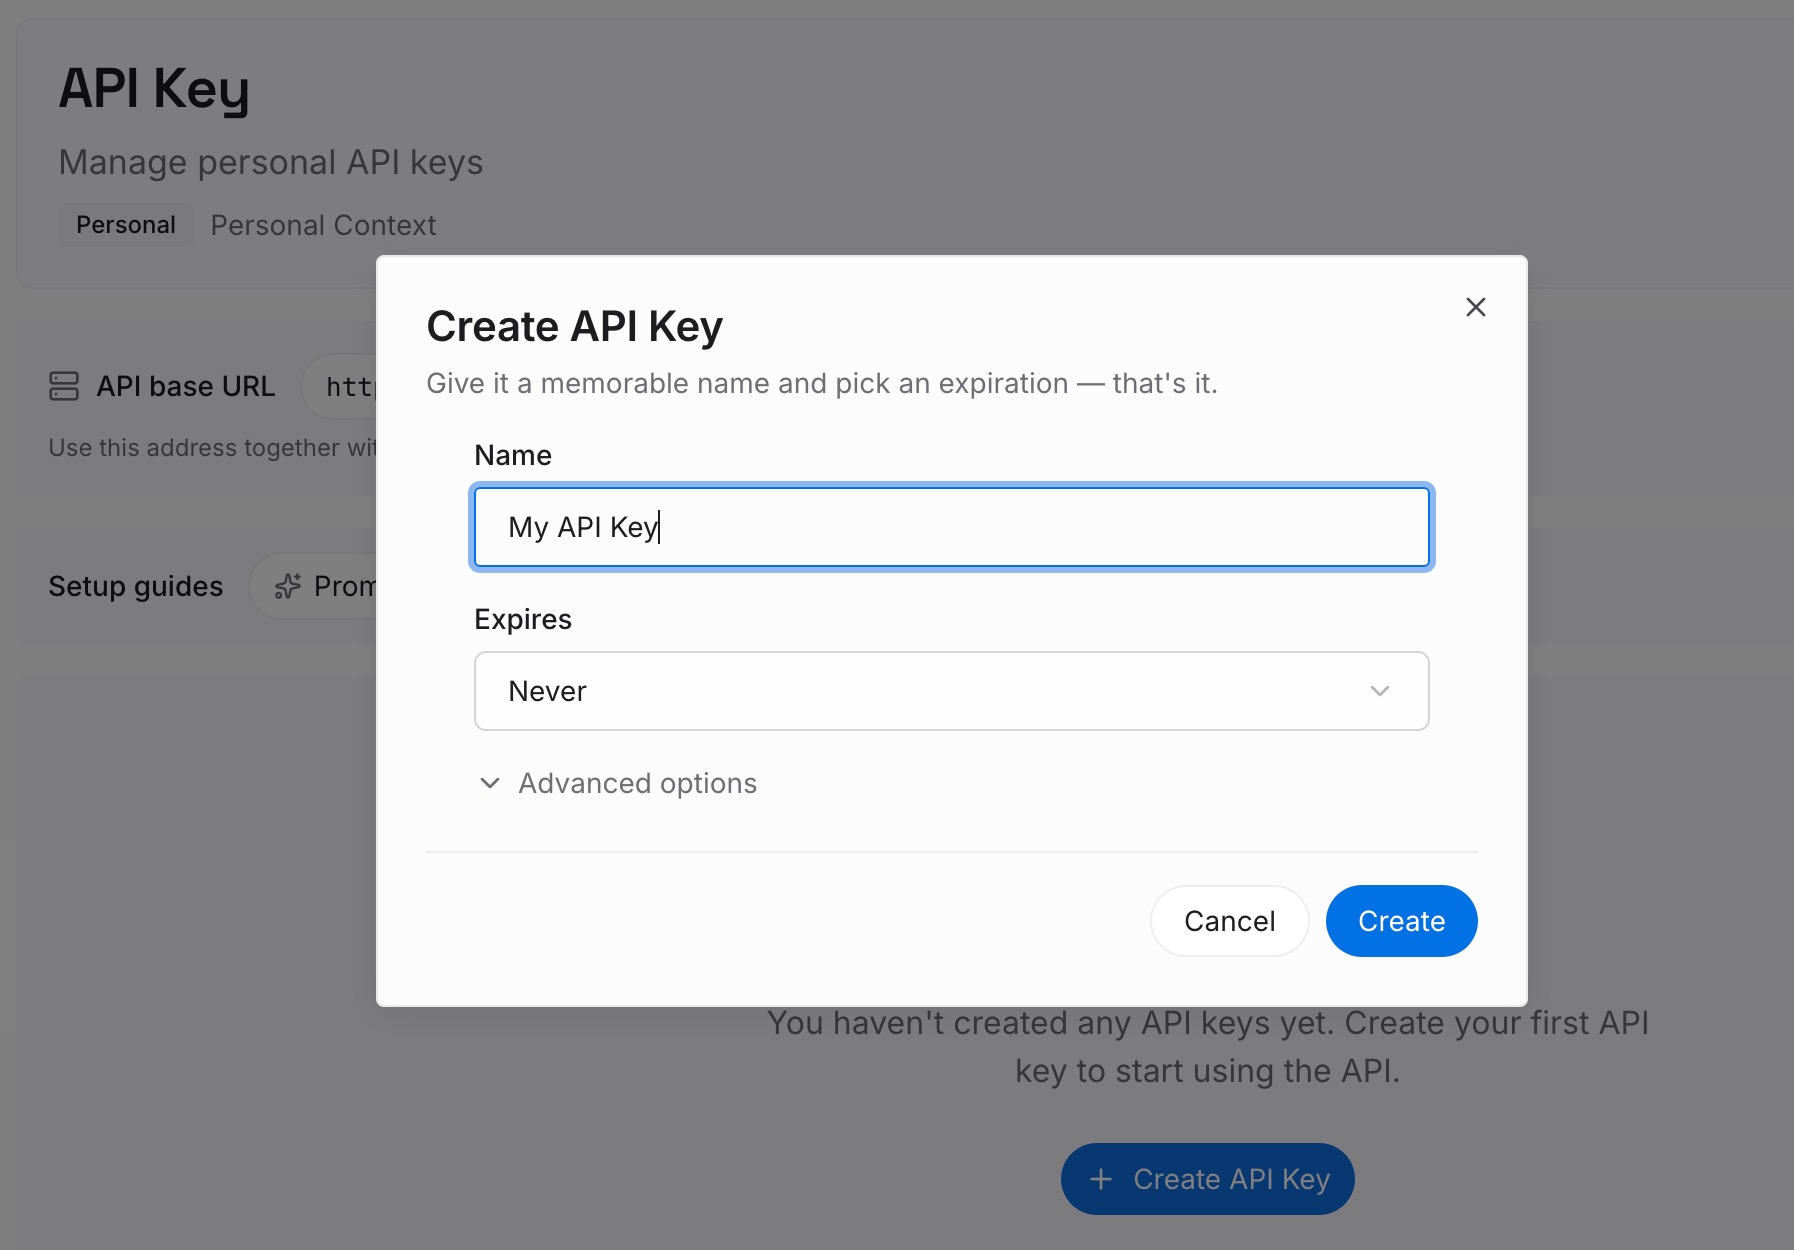
Paso 1: Crea una clave API
Inicia sesión y genera una clave desde el panel de control. La clave pertenece a tu espacio de trabajo de MemoryLake y es independiente de tus cuentas de ChatGPT y Claude.
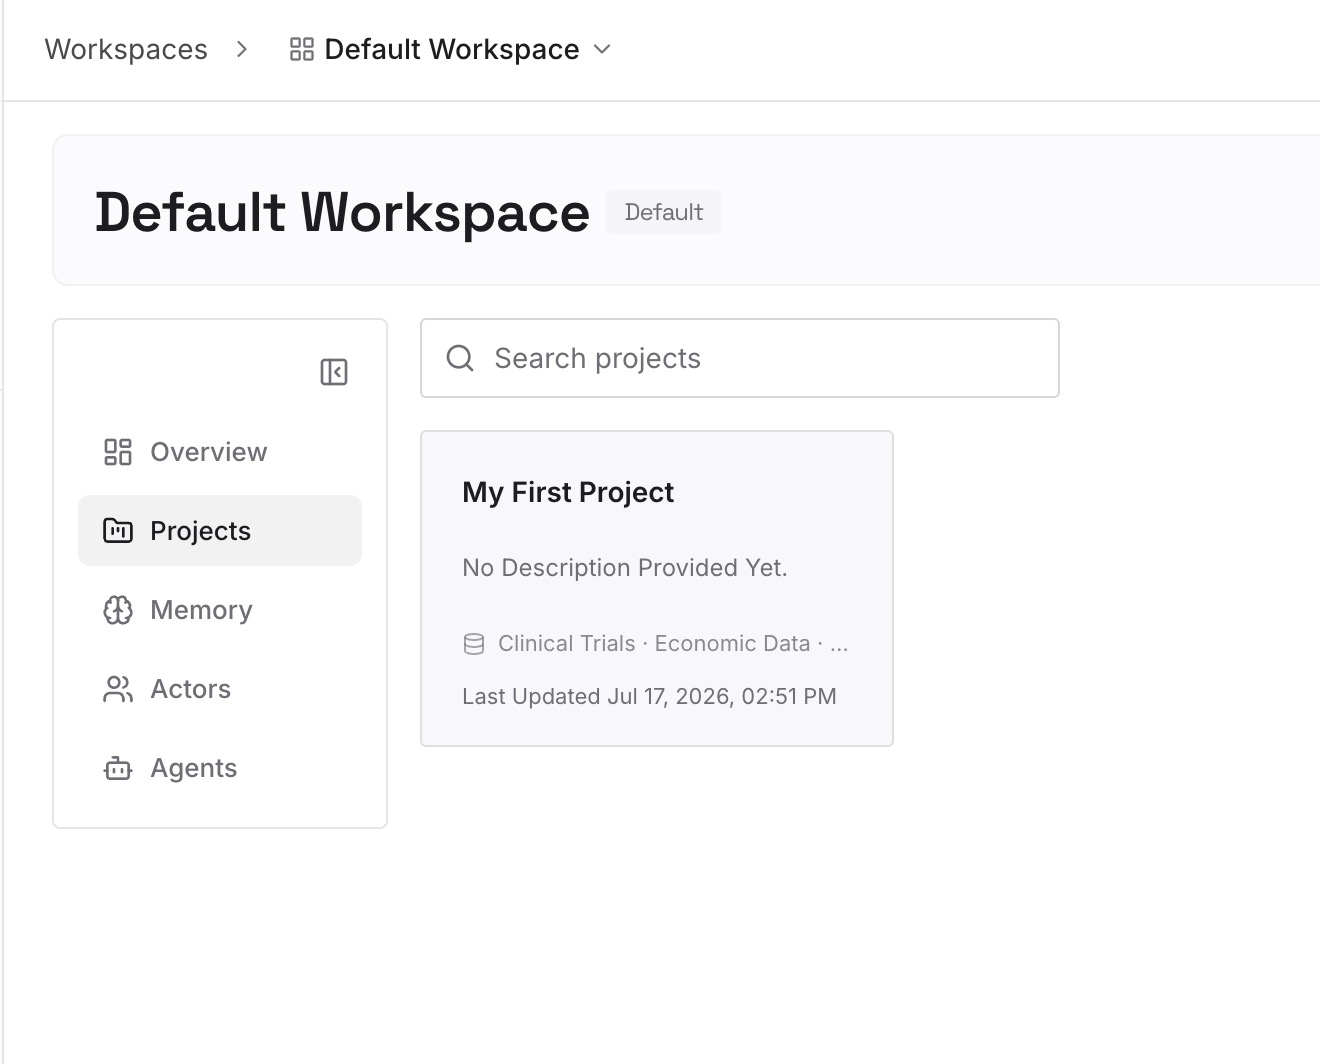
Paso 2: Sube tus primeras memorias
Comienza con lo que corregiste en el Paso 1 de la solución: los hechos y preferencias de los que cada agente debe partir. Un punto por entrada, con fecha y etiquetado con el proyecto al que pertenece.
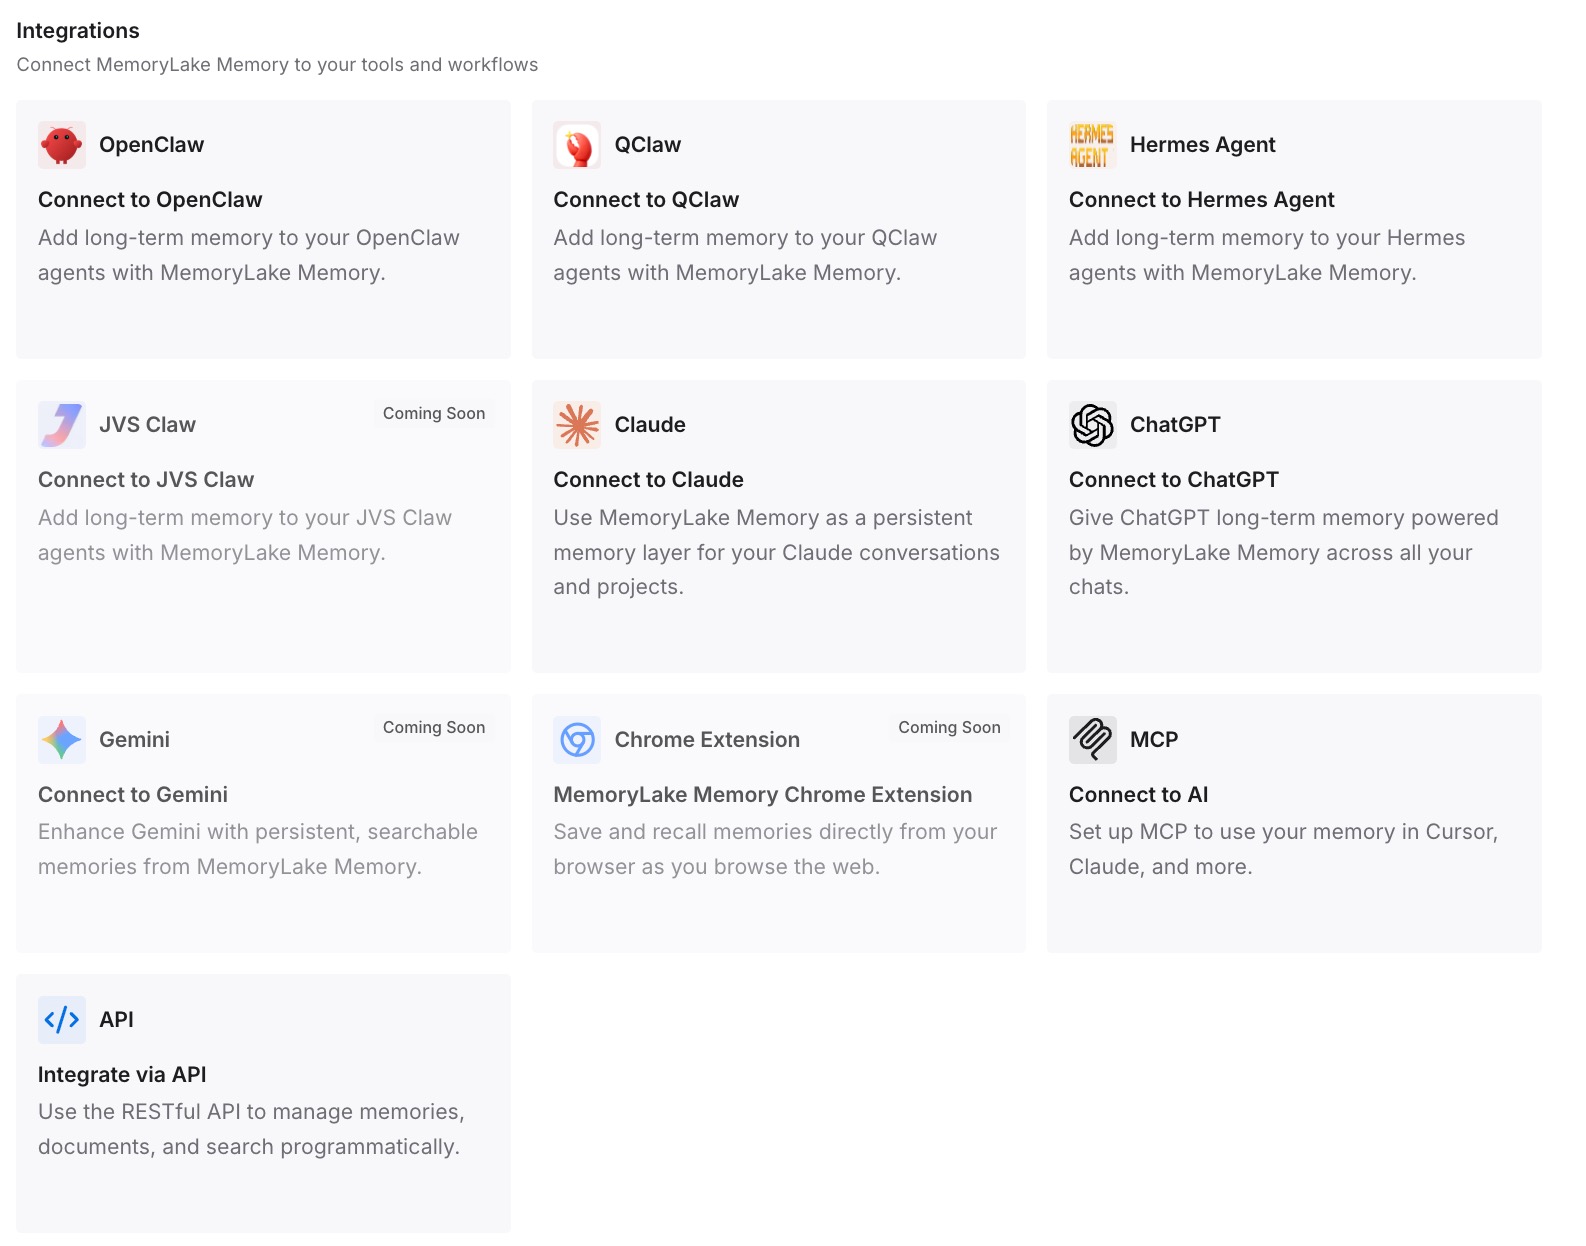
Paso 3: Conecta tu IA y agentes
Conecta ChatGPT y los otros asistentes que utilices. Tu contexto principal es el mismo dondequiera que se ejecute la próxima tarea.
Qué cambia esto en la práctica
La primera diferencia es que eliges con la pregunta correcta. Ambos agentes realizan bien el trabajo de varios pasos; lo que difiere es cómo cada uno conecta una tarea con tus chats.
La segunda es que las tareas comienzan a partir de lo que tú pretendías. Verificas, corriges y delimitas la memoria antes de que comience el trabajo.
La tercera es que el cambio es menos costoso, porque el contexto del que dependes ya está escrito fuera de cualquiera de los productos. Para el navegador de Cowork, nuestra guía sobre los inicios de sesión que mantiene el navegador integrado de Cowork cubre un tipo diferente de estado almacenado.
Mejores prácticas para la memoria en ChatGPT Work y Claude Cowork
Inicia las tareas desde un proyecto cuando el trabajo continúe. Ambos productos mantienen unido el contexto del proyecto.
Pregunta qué sabe el agente antes de una tarea larga. Corrígelo antes de que construya sobre ello.
Desactiva la memoria para tareas sensibles puntuales. Ambos productos admiten la ejecución sin ella.
Ejecuta Cowork en la nube si quieres que la memoria se comparta con el chat. Anthropic dice que las sesiones locales no la comparten.
Revisa las tareas compartidas de Work antes de enviarlas. Las instrucciones van con el enlace; tus memorias no.
Mantén lo esencial fuera de cualquiera de los productos. Así, la elección del agente sigue siendo una elección.
Conclusión
ChatGPT Work y Claude Cowork conectan tareas a la memoria que has construido en el chat. OpenAI hace de Work un modo de ChatGPT que utiliza la configuración de memoria de tu cuenta y comparte el historial con Chat. Anthropic describe las sesiones en la nube de Cowork como el intercambio de una memoria con el chat en ambas direcciones, con la memoria organizada en archivos de temas que puedes editar. Ambos permiten que los proyectos delimiten la memoria, ambos ejecutan tareas programadas y ambos mantienen el contexto de la tarea en la nube.
Elige el que se adapte a donde ya viven tus chats, verifica qué sabe antes de tareas importantes y mantén las decisiones de las que dependes en una lista que controles.