
Por qué Anthropic dio a un solo agente dos almacenes de memoria
La guía parte de un problema familiar. Anthropic escribe que las automatizaciones "pueden perder el acceso a una fuente sin que nadie se dé cuenta o no seguir nuestras preferencias". Ambas mitades de esa frase son problemas de memoria disfrazados.
La memoria es necesaria porque "cada ejecución comienza en un sandbox nuevo sin memoria de la anterior". La guía es directa sobre la consecuencia: "Sin memoria, el feedback no se consolida". Pero es igualmente directa sobre el riesgo opuesto: "una memoria obsoleta puede confundir al agente". En su ejemplo, un agente con notas desactualizadas informa que un elemento sigue pendiente después de haber sido resuelto, o descarta un elemento abierto porque cree que ya informó sobre él.
La implementación de referencia responde a esto con dos almacenes montados bajo /mnt/memory/.
El primero es preferences (preferencias), descrito como "tuyo, de solo lectura para el agente". Contiene "qué canales y repositorios leer, qué excluir, el límite de longitud, el destino y cuándo detenerse".
El segundo es state (estado), descrito como "del agente, de lectura y escritura". Contiene "los marcadores, un registro de lo que informó, un registro por ejecución, los cambios que propone a tus preferencias y notas sobre cómo se comporta cada fuente".
Al leer estas dos listas una al lado de la otra, la lógica queda clara. Todo en el primer almacén es una decisión que tú tomaste. Todo en el segundo almacén es algo que el agente observó o hizo. Al agente se le permite proponer cambios en tus preferencias, pero las propuestas van a su propio almacén. Tus reglas cambian solo cuando tú las cambias.
Por qué es importante la línea de solo lectura
La documentación de memoria de Anthropic explica el riesgo contra el que protege la división. "Los almacenes de memoria se conectan con acceso read_write por defecto". Luego detalla lo que significa ese valor por defecto para un agente que lee texto de otras personas: "Si el agente procesa entradas no confiables (prompts proporcionados por el usuario, contenido web obtenido o salidas de herramientas de terceros), una inyección de prompt exitosa podría escribir contenido malicioso en el almacén. Las sesiones posteriores leerán ese contenido como memoria confiable".
La recomendación es la siguiente: "Usa read_only para material de referencia, búsquedas compartidas y cualquier almacén que el agente no necesite modificar". Y no es una convención que se le pida respetar al modelo. "El acceso (access) se aplica a nivel del sistema de archivos: un montaje read_only rechaza las escrituras".
La guía de automatización aplica esto con exactitud. Su agente lee mensajes de Slack e issues de GitHub escritos por otras personas, y la guía reconoce que "ese texto puede interpretarse como instrucciones". Por lo tanto, "el token de GitHub y el almacén de preferencias son de solo lectura, y el entorno solo se comunica con los hosts de su lista de permitidos". La guía es honesta sobre lo que esto protege y lo que no: "Una instrucción plantada aún puede cambiar lo que dice el resumen, incluso a través de las notas que el agente guarda entre ejecuciones. No puede escribir en GitHub ni editar tus reglas".
Esa última frase resume todo el argumento. Las propias notas del agente están expuestas a lo que lee, por lo que pueden ser erróneas. Tus reglas se encuentran en un almacén en el que el agente no puede escribir, por lo que siguen siendo tuyas.
Por qué una copia de tus preferencias es peor que un puntero
La guía señala un segundo fallo más silencioso. "Un problema común ocurre cuando se integra una copia de las preferencias en el prompt, lo que hace que se sigan aplicando reglas que ya has cambiado". La solución es leer la fuente cada vez: "Haz que el agente lea el archivo de nuevo en cada ejecución. Si no puede leer el archivo, debe detenerse y comunicarlo en lugar de ejecutarse con los valores por defecto".
Esta es una lección general sobre la memoria, no solo sobre Managed Agents. Cualquier copia de una preferencia, ya sea en un prompt del sistema, en un informe pegado o en un resumen almacenado en caché, comienza a envejecer en el momento en que se crea. La respuesta de la guía es una ubicación autoritativa única, leída al inicio de cada ejecución.
Qué intenta la gente en su lugar
Asumir que un solo almacén de memoria es más sencillo. Es más sencillo de configurar. También permite al agente reescribir las reglas que se supone que debe seguir, y permite que cualquier cosa que lea se filtre en esas reglas. La documentación de Anthropic sugiere conectar múltiples almacenes "cuando diferentes partes de la memoria tienen diferentes propietarios o reglas de acceso".
Integrar las preferencias en el prompt del sistema. Es conveniente, y la guía lo señala como el problema común: el prompt sigue aplicando reglas que ya has cambiado.
Permitir que el agente mantenga sus propias reglas. Los agentes son buenos para detectar patrones, y la implementación de referencia aprovecha eso. Pero dirige los cambios propuestos al propio almacén del agente para que los revises, en lugar de permitir que el agente los aplique directamente.
Confiar en un informe de "nada nuevo". La guía muestra por qué esto no es seguro. "Si un servidor MCP está caído o su token ha expirado, la ejecución se inicia de todos modos, solo que sin las herramientas de ese servidor". Luego: "La sesión registra un error, pero el agente no ve nada de esa fuente". Sin una regla explícita, una fuente rota se ve exactamente como un día tranquilo.
Leer una ventana de tiempo fija. La guía advierte contra pedirle al agente que lea una ventana fija, como el último día. "Una ejecución tardía deja un vacío y una ejecución temprana repite elementos". Su respuesta: "En su lugar, dale al agente un marcador por fuente".
La solución: Decide quién escribe cada pieza de memoria y luego aplícalo
Paso 1: Clasifica todo lo que el agente debe recordar según quién lo escribe
Haz una lista de lo que tu agente necesita conservar entre ejecuciones y luego coloca cada elemento en una de dos columnas.
La primera columna son las decisiones. Qué fuentes leer, qué se considera importante, qué excluir, a dónde van los resultados, límites de longitud y cuándo detenerse. Estas son tuyas. Cambian cuando tú cambias de opinión, no cuando el agente observa algo.
La segunda columna son las observaciones y el progreso. Dónde se quedó el agente en cada fuente, qué ha informado ya, qué sucedió en cada ejecución y las particularidades que ha aprendido sobre cada fuente. Estas pertenecen al agente, y el agente debe actualizarlas en cada ejecución.
Cualquier cosa que no encaje limpiamente suele ser una decisión en la que el agente quiere influir. Dale un lugar para proponer, en su propia columna, y revisa esas propuestas según tu propio calendario. Esto refleja cómo la implementación de referencia almacena los "cambios que propone a tus preferencias" en el almacén de estado.
Paso 2: Coloca tu columna en un almacén que el agente solo pueda leer, y léelo en cada ejecución
Crea un almacén de memoria para tus preferencias y conéctalo con acceso read_only. Escribe tú mismo el archivo de preferencias. En la implementación de referencia, el despliegue del agente "crea el almacén de preferencias, pero no el archivo en él", y un script semilla escribe el archivo antes de la primera ejecución.
Luego añade la instrucción que recomienda la guía: lee las preferencias de nuevo al inicio de cada ejecución y detente con un mensaje claro si el archivo no se puede leer. No pegues las preferencias también en el prompt del sistema. Dos copias terminarán desincronizándose.
Si varios agentes comparten el mismo material de referencia, como convenciones de equipo o un glosario, se aplica el mismo principio a escala. La documentación describe "un almacén de solo lectura conectado a muchas sesiones (estándares, convenciones, conocimiento del dominio), mantenido separado del almacén de lectura y escritura propio de cada sesión".
Paso 3: Dale al almacén propio del agente un registro, marcadores y una línea de fallo honesta
En el almacén de lectura y escritura, dale al agente tres estructuras.
Un marcador por fuente, escrito al final de cada ejecución, para que la siguiente ejecución comience exactamente donde se detuvo la anterior.
Un registro. "El agente mantiene un registro, ledger.md, de cada elemento sobre el que ha informado, para que el resumen no se repita". Cada línea lleva un ID estable y el último estado conocido del elemento, que es lo que permite al agente informar sobre un cambio en lugar de una repetición.
Una regla de fallo. Cuando una fuente no se puede leer, el agente de la guía "mantendrá el marcador de la fuente donde está, escribirá el resumen a partir de las otras fuentes y finalizará el resumen con una línea que indique lo que no pudo leer". Vale la pena copiar su regla de resumen palabra por palabra: "Informa de una lectura fallida como ilegible, nunca como un día tranquilo".
Debido a que cada escritura en un almacén de lectura y escritura produce una versión, puedes revisar qué registró el agente y cuándo. "Cada cambio en una memoria crea una versión de memoria inmutable". Utiliza ese historial cuando un resumen parezca incorrecto; puede mostrar en qué nota se estaba apoyando el agente. Para entender por qué es importante ese tipo de rastro, consulta memory provenance explained.
Configuración de esto en MemoryLake
La división en la guía de Anthropic tiene un equivalente natural fuera de cualquier plataforma individual. Tus decisiones y preferencias son la parte que tú escribes y que deseas que todos los agentes respeten. Los agentes guardan sus propias notas de trabajo dondequiera que se ejecuten. MemoryLake es un lugar para guardar la primera parte, la capa que tú escribes, de modo que se mantenga consistente en todos los agentes y asistentes que utilices.
Tú mismo escribes las entradas, con tus propias palabras. No se lee, escribe ni elimina nada de los almacenes de memoria de Anthropic, de las notas de trabajo de tus agentes ni del almacén de ningún proveedor. Los almacenes de memoria de Anthropic permanecen donde están, gestionados a través de la propia API de Anthropic.
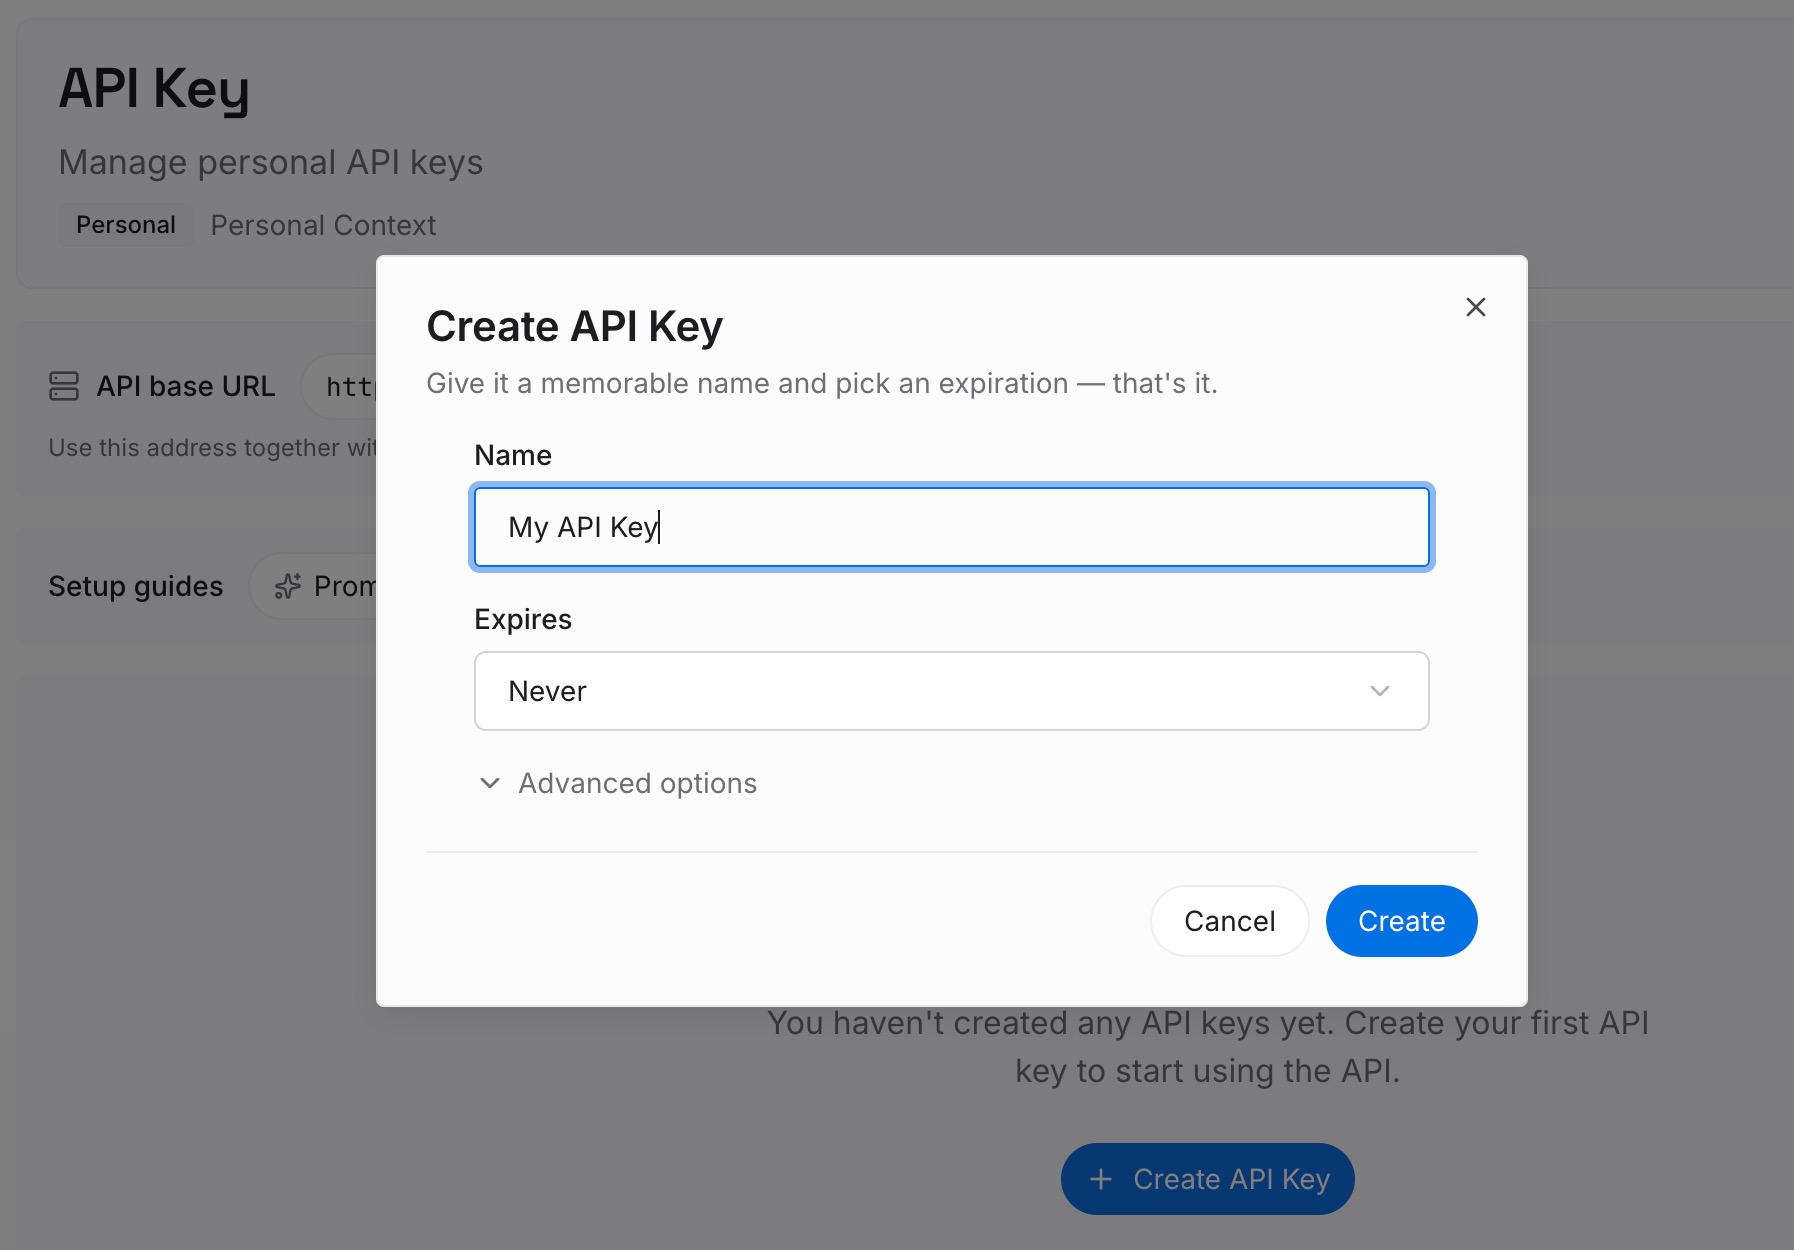
Paso 1: Crea una clave de API
Inicia sesión y genera una clave desde el panel de control. La clave pertenece a tu espacio de trabajo de MemoryLake, independiente de tu organización en Claude Console.
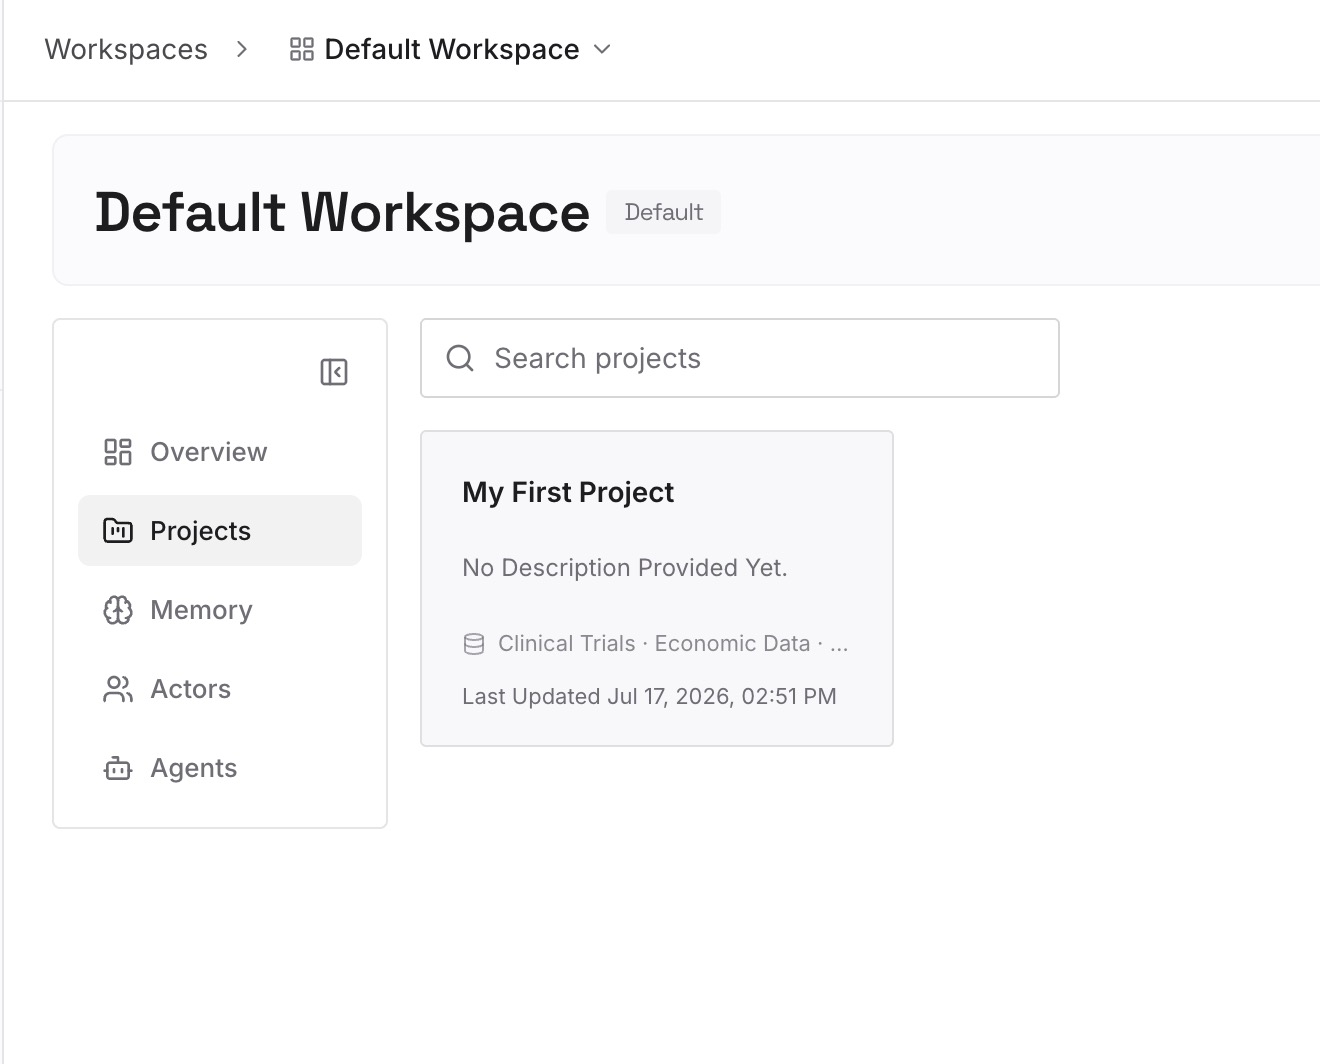
Paso 2: Sube tus primeras memorias
Comienza con la columna de decisiones del Paso 1: lo que te importa, qué excluir y cómo deseas que se entreguen los resultados. Una preferencia por entrada, con fecha, para que los cambios sean visibles.
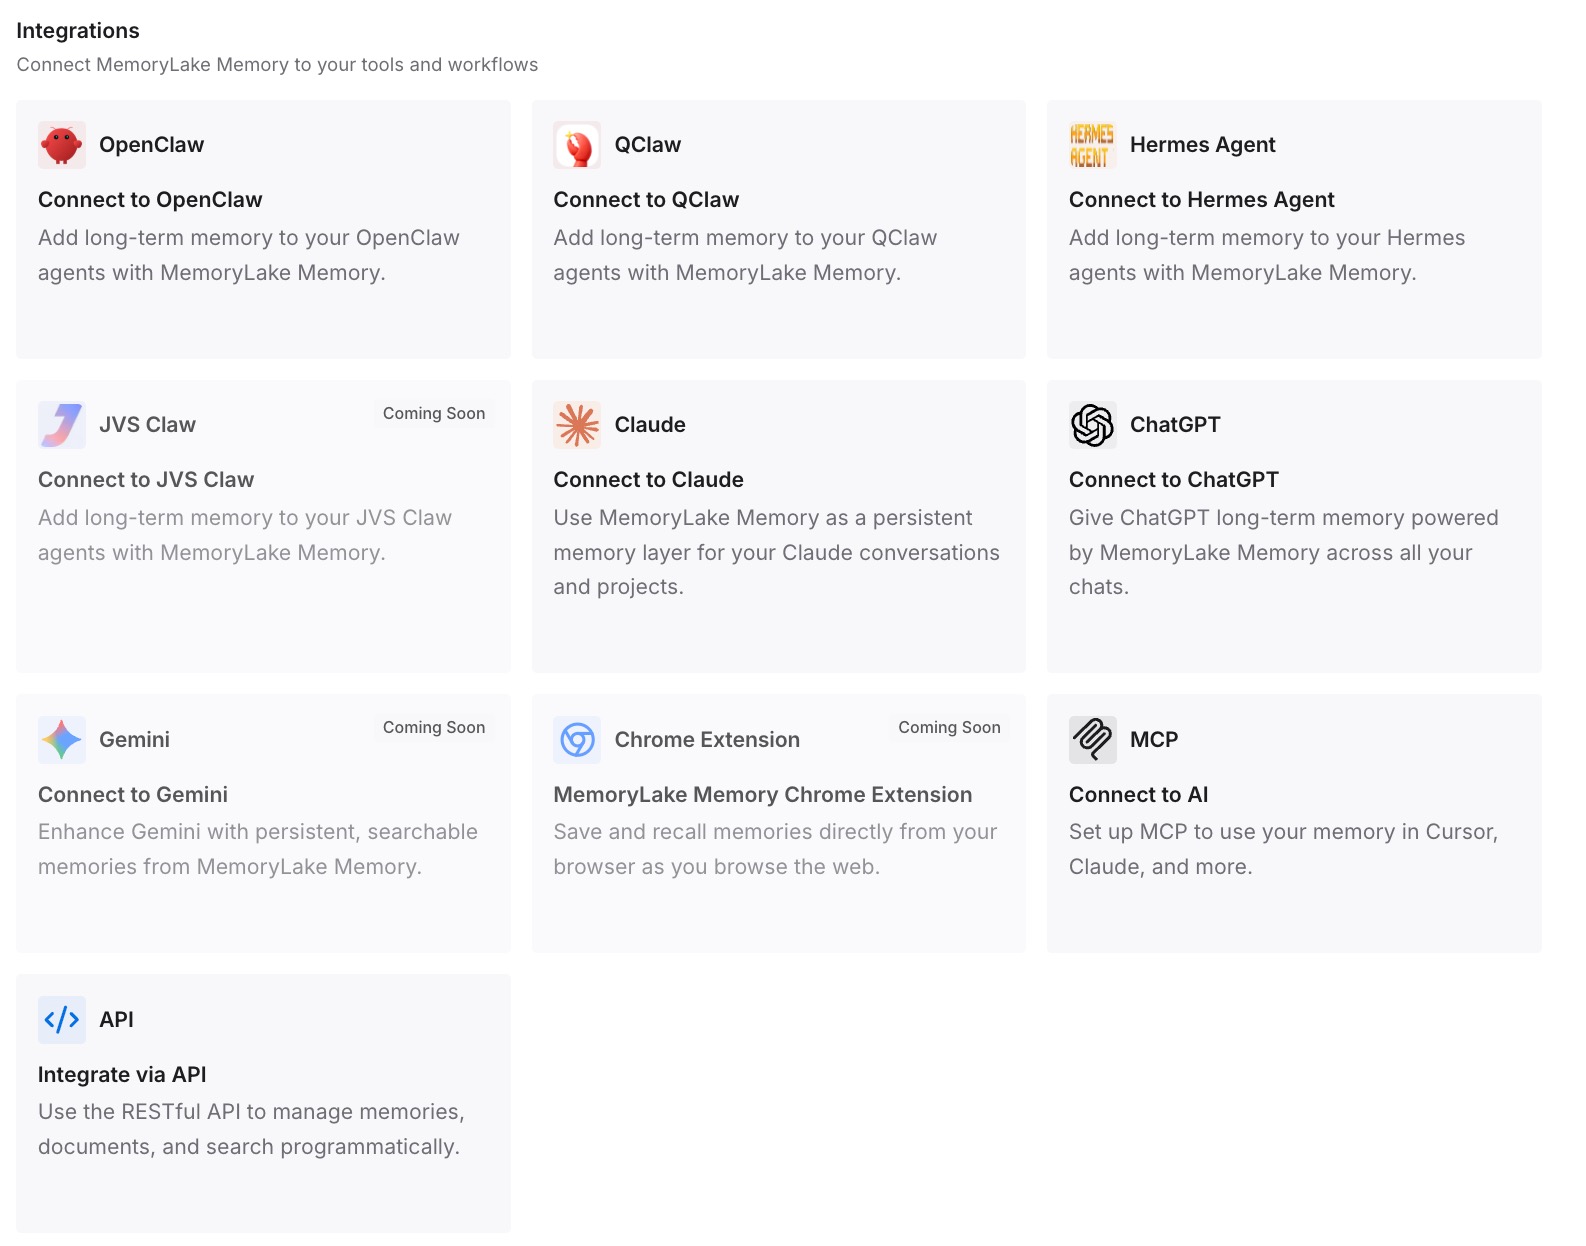
Paso 3: Conecta tu IA y tus agentes
Conecta los asistentes y agentes que utilizas. Tus preferencias estarán disponibles como una única fuente escrita, en lugar de copias integradas en el prompt de cada agente.
Qué cambia esto en la práctica
La primera diferencia es que las reglas dejan de desincronizarse. Con las preferencias leídas de nuevo desde un almacén que el agente no puede editar, cualquier cambio que realices se aplica en la siguiente ejecución y el agente no puede reinterpretarlo silenciosamente.
La segunda es un radio de impacto menor. El texto que lee el agente aún puede afectar lo que escribe en sus propias notas, como dice claramente Anthropic. Pero no puede reescribir las reglas que lo gobiernan.
La tercera es un resultado honesto. Un registro y marcadores significan que el agente informa sobre cambios en lugar de repeticiones, y una línea de fallo significa que una fuente rota se muestra como rota. El mismo problema aparece en las herramientas de consumo; el artículo stopping ChatGPT's scheduled tasks from starting over every run cubre la versión con la que la mayoría de la gente se encuentra primero.
La cuarta es un aprendizaje revisable. Los cambios de preferencias propuestos permanecen en el almacén del agente hasta que los aceptes. Ese es un bucle más limpio que el de un agente que se actualiza a sí mismo, un tema explorado en self-improving agents without retraining.
Buenas prácticas para la memoria en agentes programados
Separa las decisiones de las observaciones. Las decisiones van en un almacén que tú escribes; las observaciones van en el almacén del agente.
Haz que tu almacén sea de solo lectura. Anthropic aplica esto a nivel del sistema de archivos, así que utilízalo.
Lee las preferencias de nuevo en cada ejecución. Nunca mantengas una segunda copia en el prompt.
Detén la ejecución cuando las preferencias no se puedan leer. Ejecutarse con valores por defecto es peor que un mensaje de error claro.
Usa marcadores, no ventanas de tiempo. Cada ejecución comienza exactamente donde se detuvo la anterior.
Informa explícitamente sobre las fuentes ilegibles. Un día tranquilo y un token roto deben verse diferentes.
Revisa lo que escribe el agente. Las versiones de memoria muestran qué cambió. Para un patrón relacionado en Cowork, consulta controlling whether a Cowork scheduled task uses your memory, y para la consolidación en segundo plano de Anthropic, how Claude's Dreams rebuild an agent's memory store. La cuestión más amplia de dónde residen las memorias y quién puede acceder a ellas se aborda en the security problem nobody discusses.
Conclusión
La implementación de referencia de Anthropic para agentes programados dota a un solo agente de dos almacenes de memoria. Uno contiene tus preferencias y es de solo lectura para el agente. El otro contiene los marcadores, el registro, los registros de ejecución, los cambios propuestos y las notas del agente, y es de lectura y escritura. El razonamiento está en las propias palabras de Anthropic: la memoria obsoleta confunde a los agentes, las copias de las preferencias siguen aplicando reglas antiguas y un almacén de lectura y escritura expuesto a entradas no confiables puede llevar una instrucción inyectada a ejecuciones posteriores.
El diseño es sencillo de replicar. Decide quién escribe cada pieza de memoria, aplícalo con modos de acceso, lee tus reglas de nuevo en cada ejecución y haz que el agente te avise cuando no haya podido ver algo.
La guía cierra con un consejo que se aplica a todo el enfoque: "Trata esto como un punto de partida y personaliza el agente para tus fuentes, destino o preferencias de memoria".