
Qué son los subagentes de Codex
La documentación de OpenAI utiliza tres términos. Un flujo de trabajo de subagentes es aquel en el que Codex ejecuta agentes paralelos y combina sus resultados. Un subagente es un agente delegado que Codex inicia para manejar una tarea específica. Un hilo de agente es donde un subagente realiza su trabajo, y los clientes compatibles permiten abrirlo.
Dónde se ejecutan
Los subagentes funcionan en la aplicación de escritorio de ChatGPT, Codex CLI, la extensión de IDE y en ChatGPT Work. OpenAI afirma que "las versiones actuales de Codex habilitan los flujos de trabajo de subagentes por defecto". En ChatGPT Work, los agentes se ejecutan en el entorno alojado de ChatGPT, y el chat muestra su actividad y resultados.
No son gratuitos. OpenAI señala que "debido a que cada subagente realiza su propio trabajo de modelo y herramientas, los flujos de trabajo de subagentes consumen más tokens que las ejecuciones comparables de un solo agente".
Cómo se inician
En el Codex local, los subagentes se inician cuando los solicitas o cuando las instrucciones piden a Codex que delegue. OpenAI dice que las versiones locales actuales delegan "cuando lo pides directamente o cuando el archivo AGENTS.md aplicable o las instrucciones de habilidades lo solicitan". En la práctica, eso significa prompts como: genera dos agentes, delega este trabajo en paralelo o usa un agente por punto.
En ChatGPT Work, puedes solicitarlo en la mayoría de los niveles de inteligencia. En Ultra, ChatGPT puede delegar el trabajo adecuado sin una solicitud por separado.
Por qué existen
La razón que da OpenAI tiene que ver con el contexto, no con la velocidad. Si llenas el chat principal con notas de exploración, registros de pruebas, trazas de pila y salida de comandos, "la sesión puede volverse menos confiable con el tiempo". OpenAI menciona dos efectos: la contaminación del contexto, donde la información útil queda enterrada, y la degradación del contexto (context rot), donde el rendimiento disminuye a medida que el chat se llena con detalles menos relevantes.
Los subagentes mueven ese ruido fuera del hilo principal. La recomendación de OpenAI es mantener al agente principal "enfocado en requisitos, decisiones y resultados finales" y devolver resúmenes de los subagentes en lugar de la salida intermedia bruta.
Con qué comienza cada subagente
Aquí es donde los subagentes más se diferencian de un segundo chat que abras tú mismo. Un subagente obtiene algunas cosas de tu sesión automáticamente y otras solo si se le proporcionan.
La tarea y, tal vez, la conversación
Cada subagente recibe una tarea. El hecho de que también reciba tu conversación es una elección que se toma al iniciarlo. En el código de código abierto de Codex, la herramienta que inicia un subagente tiene una opción para esto, descrita como: "True bifurca el historial del hilo actual en el nuevo agente; false u omitido comienza solo con el prompt inicial".
Por lo tanto, un subagente puede comenzar sabiendo solo lo que dice su tarea. Si tu chat principal contiene una decisión, como qué librería elegiste o qué archivos están fuera de los límites, no asumas que el subagente lo sabe. Inclúyelo en la solicitud o pide a Codex que lo incluya cuando delegue. El propio consejo de OpenAI apunta en la misma dirección: "Un buen prompt para un subagente debe explicar cómo dividir el trabajo, si Codex debe esperar a todos los agentes antes de continuar y qué resumen o resultado devolver".
Si deseas una copia completa de una conversación para explorar en una dirección diferente, esa es una función distinta. Nuestra guía para bifurcar un chat de Codex lo cubre. Los subagentes de Claude Code plantean la misma pregunta sobre qué sabe cada ayudante, y nuestra guía sobre por qué los subagentes de Claude Code no comparten memoria cubre ese aspecto.
Tus ajustes de modelo
Si no configuras nada, OpenAI dice que "el subagente hereda el modelo y el esfuerzo de razonamiento del agente padre". Puedes cambiar eso en tu prompt, establecer valores predeterminados bajo [agents] en config.toml o definirlos en un archivo de agente personalizado. OpenAI sugiere un modelo más rápido para trabajos estrechos y repetibles y uno más potente para agentes que necesitan planificar y verificar.
Tu sandbox y aprobaciones
Los subagentes heredan tu política de sandbox actual. En la aplicación de escritorio y la extensión de IDE, heredan el modo de permiso seleccionado debajo del compositor, así que elígelo antes de pedirle a Codex que delegue. En la CLI, OpenAI dice: "Los subagentes heredan el sandbox actual y los ajustes de aprobación del turno del padre, incluidos los cambios realizados con /permissions o --yolo".
Un agente personalizado no puede relajar esto. OpenAI es explícito: "Las instrucciones de un agente personalizado pueden pedirle a un agente que evite ediciones, pero no crean un sandbox de solo lectura separado".
Tus habilidades, servidores MCP y memorias
Los agentes personalizados "heredan los permisos, el proveedor y los servidores MCP del padre; un archivo de agente personalizado no puede anular esos ajustes". Las habilidades también se heredan del padre, y un agente personalizado puede desactivar habilidades individuales con skills.config.
Las memorias son una de las capacidades que un agente personalizado puede desactivar. OpenAI enumera features.memories entre las claves de funciones que puedes establecer en false para reducir lo que un agente puede hacer. Si has activado las memorias locales de Codex, nuestra guía sobre las memorias locales de Codex explica qué contienen y cómo se controlan.
Qué regresa a tu chat principal
El hilo principal recibe resultados, no el trabajo completo. Cuando se ejecutan varios agentes, OpenAI dice: "Codex espera hasta que todos los resultados solicitados estén disponibles y luego devuelve una respuesta consolidada".
El trabajo en sí permanece en cada hilo de agente. En la aplicación de escritorio, OpenAI dice que "muestra cada hilo de subagente para que puedas inspeccionar su trabajo y el resumen devuelto al chat principal". En la CLI, /subagents te permite cambiar entre hilos de agentes mientras se ejecutan. En ChatGPT Work, un panel de Subagentes muestra listas de Activos y Terminados de solo lectura, y puedes abrir un subagente completado para ver sus detalles y resultado.
Ese diseño mantiene limpio tu chat principal. También significa que el razonamiento detrás de un hallazgo, como qué archivos leyó un subagente o qué enfoque descartó, vive en un hilo que tienes que abrir. Si importa más adelante, debe anotarse en algún lugar fuera de ese hilo.
Agentes integrados y personalizados
Codex se entrega con tres agentes integrados:
default, un agente de respaldo de propósito generalworker, para implementación y correccionesexplorer, para exploración de bases de código con mucha lectura
Puedes definir los tuyos propios como archivos TOML, uno por agente, en ~/.codex/agents/ para agentes personales o .codex/agents/ para agentes limitados a un proyecto. Cada archivo debe definir name, description y developer_instructions. La documentación de OpenAI incluye este revisor como ejemplo, guardado como .codex/agents/reviewer.toml:
name = "reviewer"
description = "Revisor de PR centrado en la corrección, seguridad y pruebas faltantes."
model = "gpt-6.1-sol"
model_reasoning_effort = "medium"
developer_instructions = """
Revisa el código como si fueras el dueño.
No edites archivos.
Prioriza la corrección, la seguridad, las regresiones de comportamiento y la cobertura de pruebas faltante.
Comienza con hallazgos concretos, incluye pasos de reproducción cuando sea posible y evita comentarios solo de estilo a menos que oculten un error real.
"""
El consejo de OpenAI para los agentes personalizados es mantenerlos enfocados: "Los mejores agentes personalizados son estrechos y con opiniones claras". Si el nombre de un agente personalizado coincide con uno integrado, como explorer, el tuyo tiene prioridad.
Ajustes globales
Los ajustes que se aplican a todos los subagentes viven bajo [agents] en tu configuración. agents.enabled tiene el valor predeterminado true; establécelo en false para desactivar las herramientas multi-agente. agents.max_concurrent_threads_per_session limita cuántos hilos de agentes generados pueden estar abiertos a la vez, sin contar el principal, y agents.max_threads todavía funciona como un alias heredado. agents.default_subagent_model y agents.default_subagent_reasoning_effort establecen valores predeterminados que una solicitud explícita puede anular.
Dirigir subagentes mientras se ejecutan
No tienes que esperar. En la aplicación de escritorio, la CLI y la extensión de IDE, puedes pedirle a Codex que dirija un subagente en ejecución, lo detenga o cierre los hilos completados. En la CLI, las solicitudes de aprobación pueden provenir de un hilo de agente que no estás mirando; la superposición muestra qué hilo está preguntando y puedes presionar o para abrirlo antes de responder.
OpenAI también advierte sobre un tipo de trabajo. Los agentes paralelos son adecuados para tareas de mucha lectura, como exploración, pruebas, triaje y resumen. Dice que se debe "tener más cuidado con los flujos de trabajo paralelos con mucha escritura, porque los agentes que editan código a la vez pueden crear conflictos y aumentar la sobrecarga de coordinación".
Lo que la gente intenta primero
Asumir que un subagente conoce toda la conversación. Puede comenzar solo con su tarea. Incluye las decisiones clave en la solicitud.
Usar un archivo de agente personalizado para que un agente sea de solo lectura. Las instrucciones pueden pedirle que no edite, pero el sandbox sigue proviniendo de la sesión padre.
Configurar servidores MCP en un archivo de agente personalizado. No anulan al padre. Configura los servidores MCP en la sesión padre.
Ejecutar varios agentes que editan el mismo código. OpenAI recomienda precaución con las escrituras paralelas. Usa agentes paralelos principalmente para leer y comprobar.
Perder un hallazgo después de la ejecución. El chat principal recibe un resumen. Si un detalle importa, guárdalo antes de continuar.
La solución: Instruir a cada subagente, mantener el chat principal para decisiones y anotar lo aprendido
Paso 1: Escribe las instrucciones, no solo la tarea
Cuando le pidas a Codex que delegue, indica cómo dividir el trabajo, qué debe devolver cada agente y si debe esperar a todos ellos. Incluye las decisiones que cada agente necesita: la restricción, el archivo que no debe tocar, el enfoque ya descartado. Las reglas duraderas pertenecen a AGENTS.md, donde Codex puede seguirlas cada vez; nuestra guía sobre cómo evitar que Codex ignore las reglas de AGENTS.md explica cómo Codex encuentra esos archivos.
Paso 2: Establece permisos y agentes antes de delegar
Elige primero el modo de permiso para el turno del padre, ya que los subagentes lo heredan. Para trabajos que repitas, crea agentes personalizados con instrucciones estrechas y el modelo que se ajuste al trabajo, y desactiva las capacidades que un trabajo no necesite.
Paso 3: Guarda lo que encontraron los subagentes
Cuando llegue la respuesta consolidada, abre los hilos de agentes que importen y extrae los hallazgos que valga la pena conservar: los riesgos, las decisiones, los callejones sin salida. Escríbelos donde la próxima sesión pueda verlos. Para tareas largas con un final claro, nuestra guía sobre el modo Goal de Codex explica cómo mantener el chat principal orientado al resultado.
Configurando esto en MemoryLake
Los subagentes producen hallazgos; conservarlos depende de ti. Cada hallazgo vive en un hilo de agente, y la siguiente tarea, chat o herramienta comienza sin él a menos que alguien lo anote.
MemoryLake es una capa de memoria para mantener esos hallazgos en una lista que tú mantienes, disponible para Codex y los otros asistentes que conectes, como ChatGPT y Claude Code.
Tú mismo escribes las entradas, con tus propias palabras. No se lee nada de tus hilos de subagentes, ni se escribe ni se borra de ellos, ni de tus archivos AGENTS.md, ni de tus memorias de Codex, ni del almacenamiento de ningún proveedor. Los subagentes siguen funcionando de la manera en que OpenAI los describe.
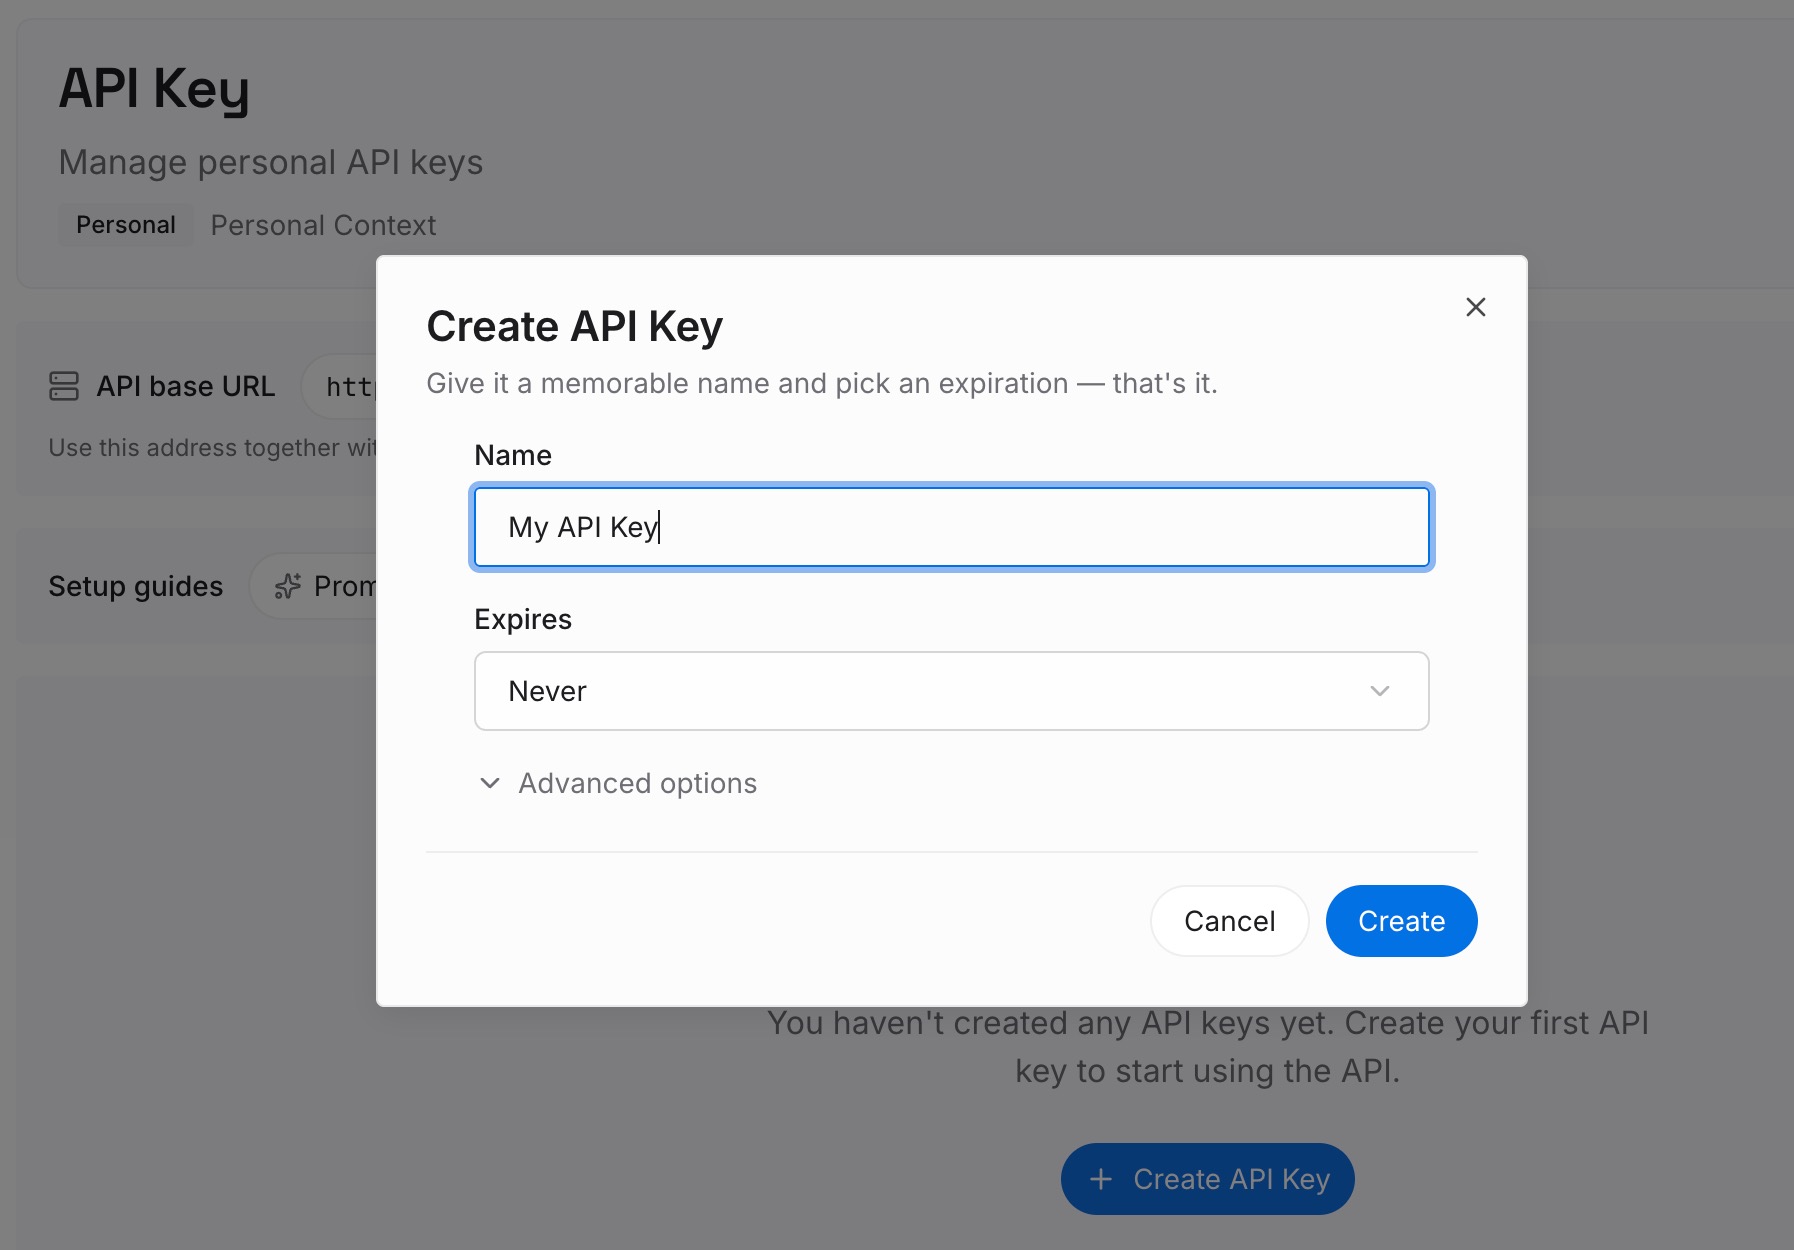
Paso 1: Crea una clave de API
Inicia sesión y genera una clave desde el panel de control. La clave pertenece a tu espacio de trabajo de MemoryLake y es independiente de tu cuenta de ChatGPT y de tu configuración de Codex.
Paso 2: Sube tus primeras memorias
Comienza con lo que extrajiste en el Paso 3 de la solución: los hallazgos, decisiones y enfoques descartados de tu última ejecución de subagentes. Un punto por entrada, con fecha y etiquetado con el repositorio.
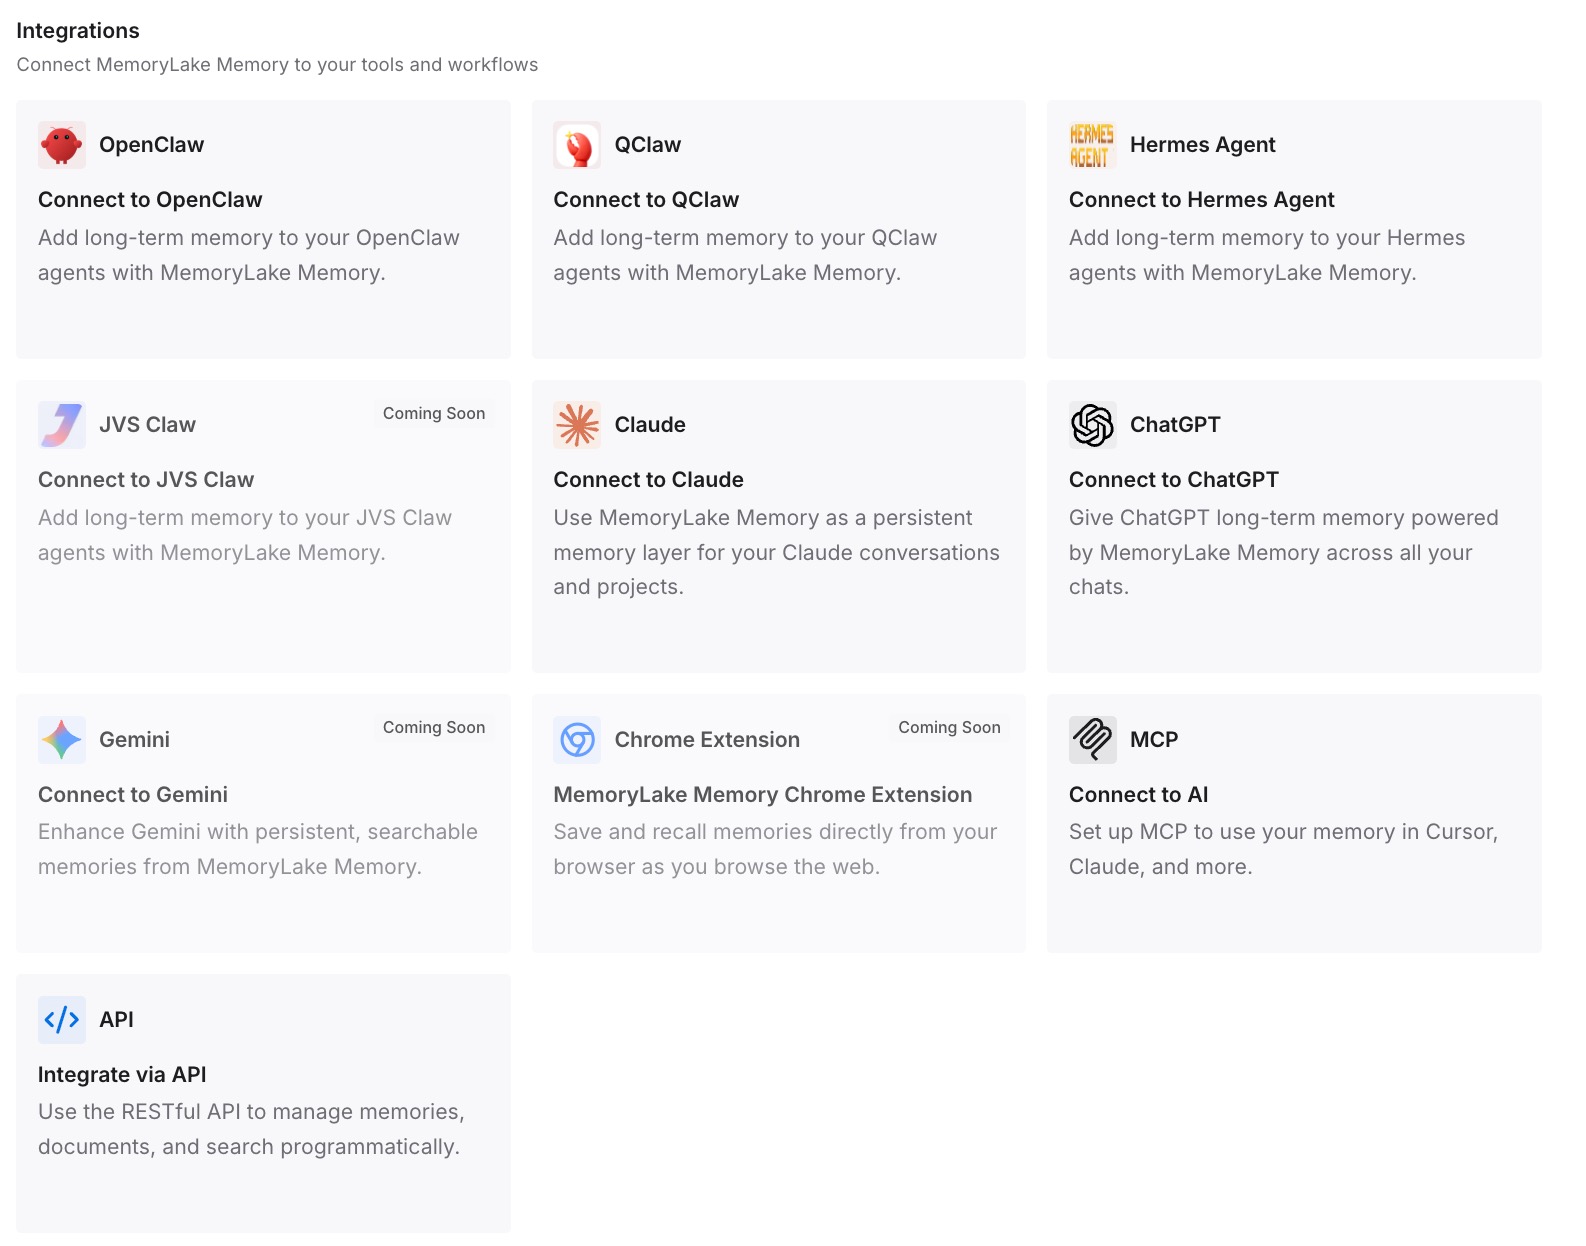
Paso 3: Conecta tu IA y agentes
Conecta Codex y los otros asistentes que utilices. Las próximas instrucciones pueden partir de lo que se resolvió en la última ejecución.
Qué cambia esto en la práctica
La primera diferencia es que los subagentes comienzan informados. Las instrucciones llevan las decisiones que necesitan en lugar de esperar que las hayan heredado.
La segunda es que el chat principal se mantiene enfocado. El trabajo ruidoso ocurre en los hilos de los agentes, y el hilo principal contiene requisitos, decisiones y resultados.
La tercera es que los hallazgos sobreviven a la ejecución. Lo que aprendió un subagente se anota, no se deja en un hilo que nunca volverás a abrir. Si te preocupan las sesiones largas, nuestra guía sobre el valor predeterminado de 500k de GPT-6.1 Sol en Codex cubre cuándo entra en juego la compactación.
Mejores prácticas para subagentes de Codex
Pide explícitamente. Indica cómo dividir el trabajo y qué devolver.
Incluye decisiones en las instrucciones. Un subagente puede comenzar solo con su tarea.
Establece permisos antes de delegar. Los subagentes los heredan del turno del padre.
Prefiere la lectura paralela sobre la escritura paralela. Usa subagentes para exploración, pruebas, triaje y revisión.
Mantén los agentes personalizados enfocados. Un trabajo, instrucciones claras, el modelo adecuado.
Configura los servidores MCP en el padre. Los archivos de agentes personalizados no pueden anularlos.
Guarda los hallazgos. Abre los hilos que importen y anota lo que aprendieron.
Conclusión
Los subagentes de Codex son agentes delegados que se ejecutan en paralelo, cada uno en su propio hilo, y devuelven sus resultados a tu chat principal como una respuesta consolidada. Están activados por defecto en las versiones actuales de Codex y en ChatGPT Work. Cada uno hereda tus ajustes de modelo, sandbox y aprobaciones, servidores MCP y habilidades, y puede comenzar solo con su tarea a menos que tu conversación se bifurque en él.
Dale a cada subagente unas instrucciones reales, establece los permisos primero, mantén el trabajo paralelo principalmente como solo lectura y anota lo que los subagentes encontraron antes de que los hilos desaparezcan de la vista.