
Qué es la memoria automática
Claude Code tiene dos sistemas de memoria. La documentación de Anthropic dice: "Ambos se cargan al inicio de cada conversación". La diferencia es quién los escribe:
- Archivos CLAUDE.md. Tú los escribes. Contienen instrucciones y reglas: estándares de código, flujos de trabajo, arquitectura del proyecto.
- Memoria automática. Claude la escribe. Contiene aprendizajes y patrones: "Tus preferencias, correcciones que le das a Claude, contexto del proyecto que Claude no puede derivar del código".
Ambos son contexto, no configuración. Anthropic dice que Claude "los trata como contexto, no como configuración forzada". Si necesitas que algo se cumpla pase lo que pase, la documentación sugiere usar un hook en su lugar.
Qué guarda Claude y qué omite
A medida que trabaja, Claude guarda notas de cuatro tipos, cada una registrada como un campo de tipo en el archivo de memoria:
- user: "tu rol, experiencia y preferencias de trabajo"
- feedback: "correcciones que le das a Claude y enfoques que confirmas"
- project: "trabajo en curso, plazos y decisiones que Claude no puede derivar del código o del historial de git"
- reference: "dónde encontrar información fuera del proyecto, como un rastreador de problemas o un tablero"
También omite cosas a propósito. "Claude omite cualquier cosa que pueda derivar de la base de código, como la arquitectura, las rutas de archivos o las correcciones de depuración. También omite cualquier cosa que tus archivos CLAUDE.md ya digan".
Y no guarda algo cada vez. "Claude no guarda algo en cada sesión. Decide qué vale la pena recordar basándose en si la información sería útil en una conversación futura".
También puedes pedirlo directamente. Ejemplo de Anthropic: cuando le pides a Claude que recuerde algo, como usar siempre pnpm en lugar de npm, "Claude lo guarda en la memoria automática". Para poner una instrucción en CLAUDE.md en su lugar, pídelo explícitamente o edita el archivo tú mismo.
Dónde vive MEMORY.md
"Cada proyecto tiene su propio directorio de memoria en ~/.claude/projects/<project>/memory/". La ruta del proyecto proviene de tu repositorio git, por lo que "todos los worktrees y subdirectorios dentro del mismo repositorio comparten un único directorio de memoria automática". Fuera de un repositorio git, se utiliza la raíz del proyecto.
Dentro del directorio, MEMORY.md es el índice, con una línea por memoria, y cada memoria tiene su propio archivo de tema. Anthropic describe MEMORY.md actuando "como un índice del directorio de memoria".
Vale la pena conocer tres propiedades de esa carpeta:
- Es local de la máquina. "Los archivos no se comparten entre máquinas o entornos en la nube". Nuestra guía sobre por qué Claude Code lo olvida todo en tu otra máquina cubre lo que eso significa en la práctica.
- Se comparte entre worktrees. Un repositorio, una carpeta de memoria, sin importar cuántos worktrees abras. Nuestra guía sobre si los worktrees comparten memoria cubre lo que carga cada sesión de worktree.
- No se limpia con las transcripciones. Claude Code elimina las transcripciones de sesiones antiguas después de su período de retención, pero los archivos de memoria están excluidos. "MEMORY.md y los archivos de temas permanecen hasta que tú o Claude los editen o eliminen".
Moverlo a otra ubicación
Para almacenar la memoria automática en otra ubicación, configura autoMemoryDirectory en tus ajustes. La documentación dice que el valor "debe ser una ruta absoluta o comenzar con ~/". Cuando se establece en el archivo de configuración de un proyecto, Claude Code aplica la misma regla de confianza del espacio de trabajo que utiliza para los hooks.
Qué se carga al inicio de cada sesión
No toda la memoria automática se carga a la vez. "Las primeras 200 líneas de MEMORY.md, o los primeros 25KB, lo que ocurra primero, se cargan al inicio de cada conversación. El contenido que supere ese umbral no se carga al inicio de la sesión".
Los archivos de temas funcionan de manera diferente. "Claude Code no carga archivos de temas como user_role.md o feedback_testing.md al inicio. Claude los lee bajo demanda utilizando sus herramientas de archivos estándar cuando necesita la información".
Mantener el índice bajo el límite
Claude Code vigila el tamaño del índice. Después de que Claude escribe en MEMORY.md, Claude Code lo verifica contra los límites de 200 líneas y 25KB. Cerca de un límite, le recuerda a Claude que acorte el archivo: una línea por entrada, detalles movidos a archivos de temas, entradas obsoletas fusionadas o eliminadas. Si se supera el límite, la escritura sigue teniendo éxito, pero se le indica a Claude que reescriba el índice, "porque todo lo que pase del límite se descarta en la siguiente carga".
Este límite es específico para MEMORY.md. Anthropic señala que Claude obtiene la totalidad de cada archivo CLAUDE.md que se carga al inicio, hasta 4 MiB. Los archivos CLAUDE.md de subdirectorios y las reglas con alcance de ruta tienen su propio límite más pequeño; nuestra guía sobre el límite de CLAUDE.md en subdirectorios lo cubre.
Subagentes y forks
"La memoria automática de la conversación principal no se carga en los subagentes; la excepción es un fork, que hereda la conversación de origen y el prompt del sistema". Un subagente puede tener su propia memoria automática, habilitada con su campo de memoria, en un directorio separado.
Lo que te indica la interfaz
Cuando Claude lee o escribe en la memoria, lo verás. Anthropic dice que los mensajes de la interfaz como Saved 2 memories o Recalled 2 memories significan que Claude está "actualizando o leyendo activamente de" la carpeta de memoria. Cada archivo de memoria con frontmatter también recibe una marca de tiempo de modificación, que "muestra qué tan actual es el hecho, tanto para ti como para Claude cuando vuelve a leer la memoria".
Cómo activar o desactivar la memoria automática
"La memoria automática está activada por defecto en sesiones locales". Las sesiones en un entorno auto-hospedado se ejecutan con ella desactivada por defecto, fuera de las sesiones de Claude Tag.
Hay tres formas de desactivarla:
- El interruptor /memory. Abre
/memoryen una sesión y usa el interruptor de memoria automática. GuardaautoMemoryEnableden tus ajustes de usuario. - Por proyecto. Establece
autoMemoryEnableden false en los ajustes de ese proyecto. - Una variable de entorno. Establece
CLAUDE_CODE_DISABLE_AUTO_MEMORY=1.
Por qué el interruptor no la volverá a activar
Hay un caso que debes conocer. El interruptor puede desactivar la memoria automática, pero no puede volver a activarla en una sesión en segundo plano, o en una sesión iniciada por otra sesión de Claude Code. Allí, el interruptor muestra off · can't be turned on here; use a session started outside Claude Code. Para volver a activarla, ejecuta Claude Code directamente en tu terminal y usa /memory allí.
Cómo ver y editar lo que se guardó
"Los archivos de memoria automática son markdown simple que puedes editar o eliminar en cualquier momento". Ejecuta /memory para navegar y abrirlos. Enumera tus archivos CLAUDE.md y ubicaciones de memoria, te permite alternar la memoria automática y tiene una opción para abrir la carpeta de memoria automática.
Si no estás seguro de qué guardó la memoria automática, la respuesta de solución de problemas de Anthropic es directa: "Ejecuta /memory y selecciona la carpeta de memoria automática para explorar lo que Claude ha guardado".
En la extensión de VS Code, el menú Customize tiene una entrada de Memory que muestra los interruptores de memoria automática, las memorias guardadas y las carpetas de memoria.
Memoria automática vs CLAUDE.md: dónde pertenece cada cosa
La división de Anthropic es una regla útil: "Usa archivos CLAUDE.md cuando quieras guiar el comportamiento de Claude. La memoria automática permite que Claude aprenda de tus correcciones sin esfuerzo manual".
- Reglas y estándares del equipo pertenecen a CLAUDE.md, subidos al repositorio, para que todos los tengan. Para reglas que solo se aplican a algunos archivos, nuestra guía sobre reglas de Claude Code cubre la carga con alcance de ruta.
- Tus preferencias y correcciones encajan en la memoria automática, en tu máquina.
- Repositorios que usan AGENTS.md siguen sus propias reglas de carga; nuestra guía sobre Claude Code y AGENTS.md explica cuándo se lee.
Cuando la memoria automática parece no funcionar
Está desactivada en esta sesión. Revisa /memory. Las sesiones en segundo plano y las sesiones iniciadas por otra sesión de Claude Code no pueden volver a activarla.
Estás en una ruta de repositorio diferente. La carpeta es por repositorio. Un clon separado del mismo código en otra ubicación puede tener una carpeta diferente.
Estás en otra máquina. La memoria automática no se sincroniza entre máquinas ni con entornos en la nube.
El índice ha superado su límite. Cualquier cosa que pase de las primeras 200 líneas o 25KB de MEMORY.md no se carga.
Estás en un subagente. Los subagentes no cargan la memoria automática de la conversación principal, a menos que sean forks.
Claude decidió que no valía la pena guardarlo. No guarda en cada sesión. Pídele que recuerde algo explícitamente. Para encontrar lo que se discutió en una sesión anterior, nuestra guía para encontrar el historial de sesiones de Claude Code cubre dónde viven las transcripciones.
Lo que la gente intenta primero
Editar MEMORY.md como si fuera CLAUDE.md. Funciona, pero MEMORY.md es un índice que Claude mantiene. Las reglas que quieres que se sigan pertenecen a CLAUDE.md.
Dejar que el índice crezca. Pasadas las 200 líneas o 25KB, el resto no se carga al inicio de la sesión.
Esperar memoria en una segunda máquina. La carpeta es local de la máquina.
Volver a activarla desde una sesión en segundo plano. No se puede activar allí. Usa una sesión iniciada directamente en tu terminal.
Asumir que las transcripciones eliminadas se llevan la memoria con ellas. Los archivos de memoria están excluidos de la limpieza de transcripciones.
La solución: Mantén la memoria automática pequeña, actual y en el lugar correcto
Paso 1: Mira lo que hay allí
Ejecuta /memory, abre la carpeta de memoria automática y lee MEMORY.md. Verifica que cada línea siga siendo cierta. Elimina lo que esté obsoleto; los archivos son markdown simple.
Paso 2: Mueve las reglas a CLAUDE.md
Cualquier cosa que deba aplicarse a todos en el proyecto, o que necesites que se siga siempre, pertenece a CLAUDE.md. Pídele a Claude que lo añada allí, o edita el archivo a través de /memory.
Paso 3: Decide qué debe viajar
La memoria automática se queda en una máquina y en un repositorio. Para preferencias y decisiones que necesites en varias máquinas, repositorios o herramientas, mantén una copia en algún lugar que no esté atado a esta carpeta.
Configurando esto en MemoryLake
La memoria automática funciona bien dentro de un repositorio en una máquina. Sus límites provienen del mismo diseño: la carpeta es por repositorio, no sale de tu máquina y solo se carga la primera parte del índice. Las preferencias y decisiones que querrías en todas partes no viajan con ella.
MemoryLake es una capa de memoria para mantener esas preferencias en una lista que tú mantienes, disponible para Claude Code y los otros asistentes que conectes, como ChatGPT y Codex.
Tú mismo escribes las entradas, con tus propias palabras. No se lee, escribe ni elimina nada de tu carpeta de memoria automática, tu MEMORY.md, tus archivos CLAUDE.md o el almacenamiento de cualquier proveedor. La memoria automática sigue funcionando de la manera que Anthropic describe.
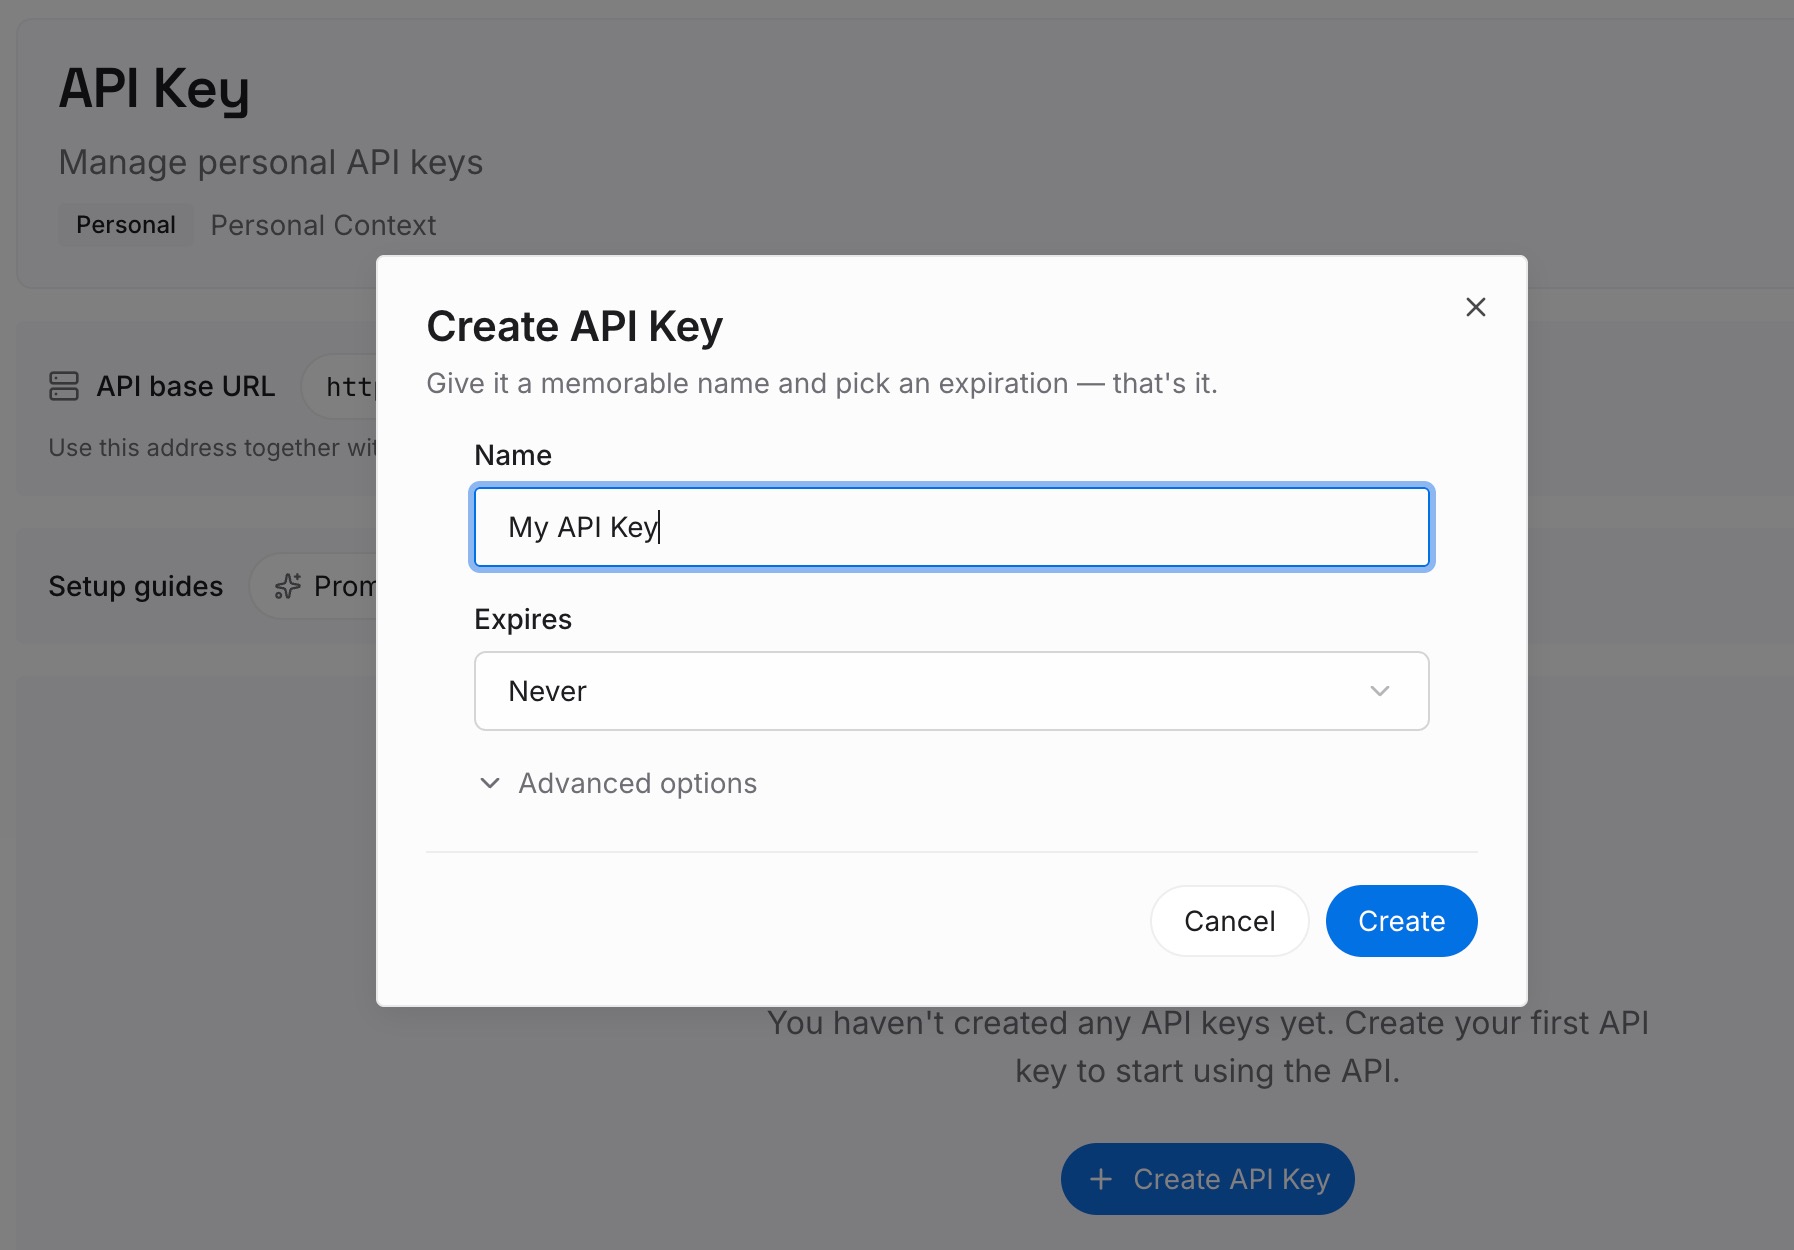
Paso 1: Crea una clave API
Inicia sesión y genera una clave desde el panel de control. La clave pertenece a tu espacio de trabajo de MemoryLake y es independiente de tu cuenta de Claude.
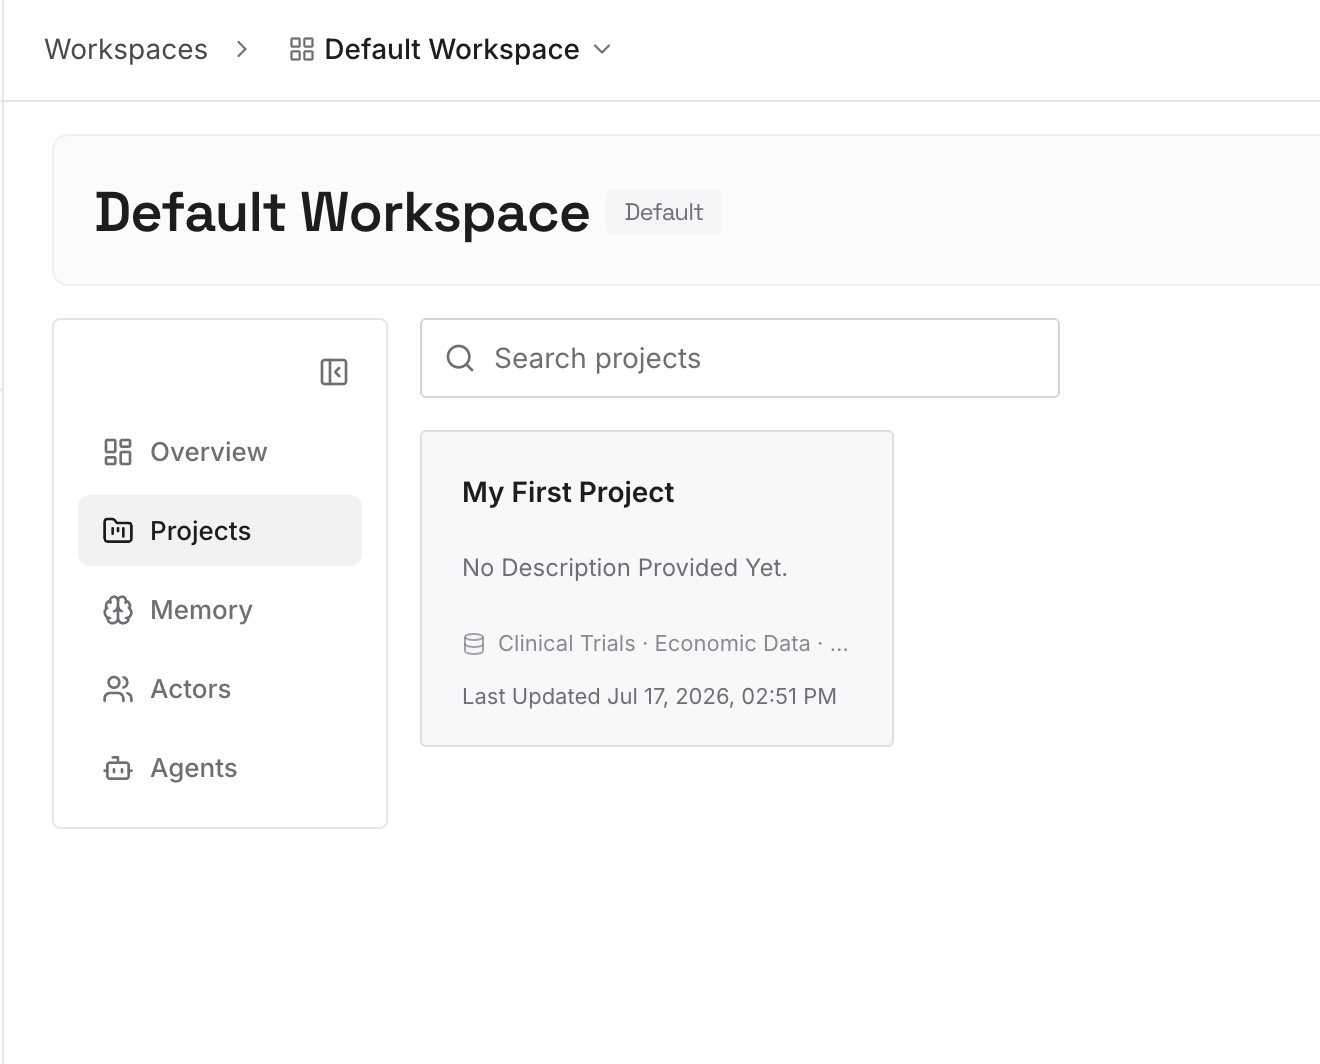
Paso 2: Sube tus primeras memorias
Comienza con lo que identificaste en el Paso 3 de la solución: las preferencias y decisiones que necesitas más allá de un repositorio. Un punto por entrada, con fecha, para que esté claro cuándo estaba vigente cada una.
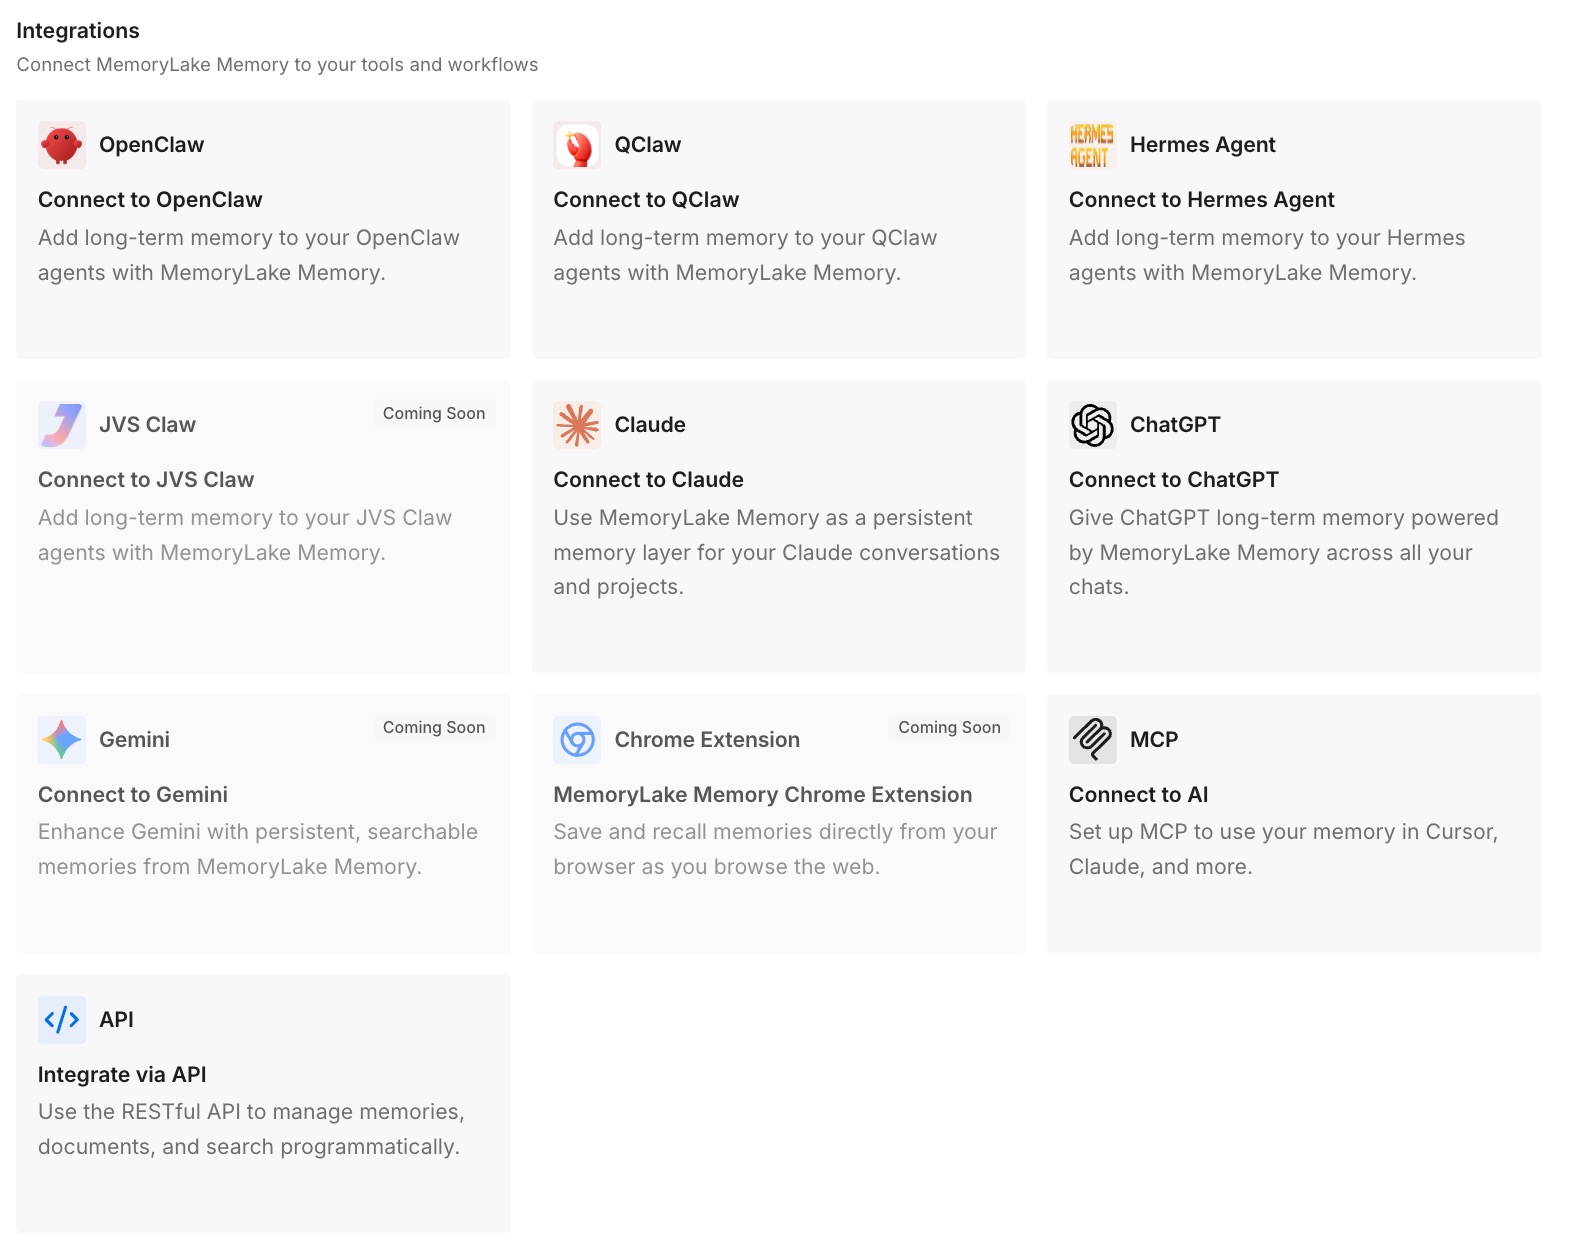
Paso 3: Conecta tu IA y agentes
Conecta Claude Code y los otros asistentes que utilices. Los mismos hechos estarán disponibles en otra máquina, en otro repositorio o en otra herramienta.
Qué cambia esto en la práctica
La primera diferencia es que la memoria automática deja de ser una caja negra. Sabes dónde está, qué guarda y cuánto de ella se carga.
La segunda es que puedes arreglarla cuando se comporta mal. La mayoría de los problemas se reducen al interruptor, la ruta del repositorio, la máquina, el límite del índice o un subagente.
La tercera es que cada tipo de contexto termina donde funciona mejor. Reglas en CLAUDE.md, correcciones personales en la memoria automática y cualquier cosa que tenga que viajar en un lugar propio.
Mejores prácticas para la memoria automática de Claude Code
Lee MEMORY.md de vez en cuando. Es markdown simple, y las líneas obsoletas consumen contexto.
Mantén el índice corto. Solo se cargan las primeras 200 líneas o 25KB.
Pon las reglas del equipo en CLAUDE.md. La memoria automática es por máquina y por usuario.
Pide a Claude que recuerde explícitamente. No guarda algo en cada sesión.
Usa una única ruta de repositorio. La memoria está vinculada al repositorio git.
Vuelve a activarla desde una sesión directa. Las sesiones en segundo plano solo pueden desactivarla.
Planifica para otras máquinas. La memoria automática no se sincroniza.
Conclusión
La memoria automática de Claude Code es el conjunto de notas que Claude escribe para sí mismo: tus preferencias, correcciones, contexto del proyecto y referencias. Vive en una carpeta por repositorio en tu máquina, con MEMORY.md como índice. Las primeras 200 líneas o 25KB de ese índice se cargan al inicio de cada conversación, y los archivos de temas se leen cuando es necesario.
Está activada por defecto en sesiones locales, y puedes desactivarla con /memory, un ajuste del proyecto o una variable de entorno. Cuando parezca no funcionar, revisa el interruptor, el repositorio, la máquina, el tamaño del índice y si estás en un subagente. Mantén las reglas en CLAUDE.md y el índice corto.