
Perplexity가 발표한 내용
"Building shared workspaces for people and agents"라는 제목의 이 포스트는 제품에서부터 시작합니다. Projects는 "사람과 에이전트가 Perplexity Computer에서 장기 실행 작업을 함께 수행하는 공간"이며, "각 프로젝트는 세션, 에이전트, 사용자 전반에 걸쳐 컨텍스트를 축적하는 파일 시스템이 있는 공유 워크스페이스에 위치합니다."
그런 다음 해당 워크스페이스에 대한 세 가지 요구 사항을 언급합니다:
- 지속성(Persistence): "작업은 개별 에이전트 세션이나 샌드박스를 넘어 지속되어야 하므로, 향후 동일한 사용자나 에이전트가 작업을 계속할 수 있고 협업자가 이를 기반으로 작업을 이어갈 수 있어야 합니다."
- 동시성(Concurrency): "동일한 프로젝트의 여러 사용자가 각각 병렬로 편집을 수행하는 여러 에이전트를 가질 수 있으며, 이는 서로 덮어쓰는 대신 공유 상태를 발전시킵니다."
- 추적 가능성(Traceability): "사용자와 에이전트 모두 히스토리를 볼 수 있어야 하므로, 전체 프로젝트를 다시 읽지 않고도 지난 세션 이후 누가 무엇을 변경했는지 확인하고 필요한 경우 편집을 되돌릴 수 있어야 합니다."
Git은 이미 소프트웨어 팀을 위해 이러한 문제를 해결하고 있으므로, Perplexity는 이를 기반으로 구축했습니다. "모든 Computer 프로젝트는 5개의 컴포넌트가 제공하는 Git 리포지토리에 의해 지원됩니다": 각 에이전트의 샌드박스 내부에 있는 소형 명령줄 도구, 컨트롤 플레인, Git 서비스, AWS S3 스토리지, 그리고 문서에서 텍스트를 추출하는 다운스트림 처리 단계입니다.
또한 포스트는 에이전트에게 "리뷰 화면, 브랜치 관리, 알림"이 필요하지 않다고 말합니다. 리포지토리는 공유 상태일 뿐, 코드 리뷰 도구가 아닙니다.
리포지토리가 보관하는 것
리포지토리는 프로젝트의 파일을 보관합니다. Perplexity 도움말 센터에서는 Project를 "검색, Perplexity Computer 작업, 파일, 지침 및 연결된 도구를 함께 유지하는 것"으로 설명하며, 파일이 바로 Git 레이어가 저장하는 대상입니다. Computer는 사용자를 대신하여 파일을 생성하고 업데이트할 수 있으며, 편집 권한이 있는 프로젝트 멤버는 파일을 업로드하고 삭제할 수 있습니다.
각 에이전트는 자체 복사본에서 작업합니다. "각 에이전트는 자체 격리된 샌드박스를 가집니다." 그 안에서 에이전트는 로컬 체크아웃으로 작업하며, "에이전트가 수행한 의미 있는 작업 단위마다 변경 사항을 커밋으로 제출합니다." 샌드박스는 일시적이고 스토리지는 영구적이기 때문에, 크래시가 발생해도 손실이 적습니다: "샌드박스가 다운되더라도 제출되지 않은 작업만 손실될 위험이 있습니다."
두 에이전트가 동시에 편집할 수 있습니다. Git 서비스는 수락된 최신 커밋을 추적하며, "제출을 받으면 해당 head를 기반으로 빌드된 경우에만 수락합니다." 다른 에이전트가 먼저 도달한 경우, 늦은 에이전트는 stale-base 응답을 받고 "새로운 head 위에 변경 사항을 다시 적용(replay)하고 다시 제출"해야 합니다. Perplexity의 요약: "이 설계는 동시 에이전트가 서로의 작업을 자동으로 덮어쓰지 않도록 보장합니다."
에이전트는 개발자와 같은 방식으로 프로젝트를 읽기도 합니다. "에이전트는 고정된 검색 파이프라인을 실행하는 대신 표준 파일 시스템 도구를 사용하여 샌드박스에 로드된 리포지토리 버전을 탐색"하며, 폴더를 나열하고 파일 콘텐츠를 검색합니다. 이는 실질적인 결과를 가져옵니다. 명확한 제목이 있는 명확하게 명명된 파일은 긴 세션에 묻혀 있는 동일한 사실보다 에이전트가 찾기 훨씬 쉽습니다.
도움말 센터는 공간의 크기를 제한합니다. "모든 Project는 최대 10,000개의 파일과 총 5 GB의 스토리지를 가질 수 있으며, 각 파일은 최대 100 MB까지 가능합니다." 2026년 8월 이전에 생성된 Projects는 이미 해당 스토리지 제한을 초과했을 수 있습니다. 이 프로젝트들은 계속 작동하지만, 새 파일을 업로드할 수는 없습니다.
히스토리가 보존하는 것
수락된 모든 변경 사항은 기록됩니다. "수락된 각 쓰기에 대해 아웃박스(리포지토리, 새 커밋, 변경을 수행한 사용자, 변경된 경로를 나열하는 로그)에 항목을 추가합니다." 이것이 실제로 적용된 추적 가능성 요구 사항입니다: 누가 무엇을 변경했는가.
하지만 히스토리가 무제한은 아닙니다. Perplexity는 이에 대해 직접적으로 언급합니다: "압축(Compaction)은 리포지토리 크기를 제한하면서 최근 히스토리를 계속 사용할 수 있도록 유지합니다." 제출 후 Git 서비스는 리포지토리 압축이 필요한지 확인하며, "유지되는 커밋 수가 임계값을 초과하면 Git 서비스는 가장 최근 커밋의 더 작은 세트만 유지합니다. 오래된 히스토리는 단일 시작 스냅샷으로 대체되고, 최근 커밋은 커밋 식별자를 업데이트하기 위해 다시 적용(replay)됩니다."
파일 자체는 이 작업의 영향을 받지 않습니다. 포스트의 다이어그램은 "새로운 head는 동일한 파일을 유지한다"고 명시합니다. 변경되는 것은 얼마나 먼 과거까지 볼 수 있는지입니다. 유지되는 윈도우 범위를 벗어나면, 누가 어떤 파일을 변경했는지에 대한 단계별 기록이 스냅샷으로 압축됩니다. 포스트에서는 임계값을 공개하지 않았습니다.
인프라와 인터페이스 간에도 차이가 있습니다. 포스트에서는 히스토리를 사용자가 보고 되돌릴 수 있어야 하는 것으로 설명합니다. 하지만 Projects에 대한 Perplexity 도움말 센터 문서에서는 파일, 제한, 공유, Brain에 대해 설명할 뿐, 버전 히스토리 보기나 프로젝트 파일 복원 버튼에 대해서는 설명하지 않습니다. 기능이 공식 문서화되기 전까지는 히스토리를 탐색할 수 있는 아카이브라기보다는 Perplexity의 안전 장치로 취급하는 것이 좋습니다.
실질적인 해석: 리포지토리는 현재 파일을 보관하는 신뢰할 수 있는 공간이며, 히스토리는 단기적인 보호 장치입니다. 팀이 무언가를 결정한 이유에 대한 기록은 커밋 로그가 아니라 파일에 보관되어야 합니다. 버전 관리되는 메모리의 일반적인 사례에 대해서는 AI 메모리의 모든 변경 사항에 히스토리가 필요한 이유를 참조하세요.
리포지토리 외부에 존재하는 것
여기서 Git이라는 프레임이 오해를 불러일으킬 수 있습니다. Project에서 Computer의 답변을 형성하는 여러 종류의 컨텍스트는 프로젝트 파일이 전혀 아닙니다.
문서에서 파싱된 텍스트
PDF나 Office 파일을 추가하면 백그라운드 파서가 텍스트를 추출합니다. "파싱된 출력물은 리포지토리 외부의, 원본 문서의 해시를 키로 하는 저장소에 저장됩니다. 이러한 아티팩트는 리포지토리에 다시 커밋되지 않습니다." 에이전트는 체크아웃과 함께 파싱된 텍스트를 수신하며, "PDF와 같은 문서의 경우 에이전트는 파싱된 텍스트를 먼저 읽고 필요한 경우에만 원본 파일을 다운로드합니다."
포스트는 "파싱이 비동기적으로 발생한다"고 덧붙입니다. 즉, 에이전트의 체크아웃 중이 아니라 백그라운드에서 진행됩니다. Computer가 대용량 문서에서 무언가를 놓치는 것처럼 보인다면, Perplexity가 업로드된 파일을 잊어버리는 이유에 대한 가이드에서 일반적인 원인을 확인해 보세요.
Brain의 메모리
Brain은 사람들이 프로젝트와 함께 저장된다고 가장 흔히 가정하는 부분입니다. 하지만 포스트는 다르게 말합니다: "Computer의 지식 위키인 Perplexity Brain은 자체 히스토리와 정책을 가진 지식 리포지토리에 메모리를 저장합니다. 지식을 프로젝트 파일과 분리하여 유지하면 백그라운드 메모리 업데이트가 해당 파일의 편집과 충돌하지 않습니다. 두 가지가 모두 필요한 세션은 두 리포지토리를 모두 로드합니다."
따라서 Project의 메모리와 Project의 파일은 함께 로드되는 두 개의 저장소입니다. 백그라운드 에이전트가 메모리 측면을 유지 관리합니다: 이들은 "기존 지식을 읽고, 새로운 정보를 통합하며, 업데이트된 페이지를 커밋으로 저장합니다."
도움말 센터는 두 가지 컨텍스트에서 Brain을 설명하며, 이를 구분해서 이해하는 것이 좋습니다. 계정 수준에서 Brain은 "Computer를 사용하는 Max 및 Enterprise Max 구독자에게 Research Preview로 출시 중"이며, "Brain은 오직 사용자의 활동에서만 학습합니다. 다른 사람의 데이터를 가져오지 않으며, 시크릿 세션은 완전히 무시합니다." Project 내부에서 Perplexity의 Memory 문서는 공유 레이어를 설명합니다: "프로젝트의 모든 구성원은 동일한 Brain을 봅니다. 이는 위키와 같습니다. 기여자는 편집할 수 있고, 뷰어는 읽을 수 있으며, 프로젝트 소유자가 메모리 토글을 제어합니다." 또한 "Brain은 Computer 세션에서만 사용할 수 있습니다. Search는 Brain에 액세스하지 않습니다."라고 덧붙입니다.
여기서 두 가지 결과가 도출됩니다. Brain의 항목은 편집할 수 있어 유용하며, "각 항목은 출처로 다시 링크되므로 확인하거나 수정할 수 있습니다." 그리고 Brain은 실행할 때마다 "오래된 정보가 무엇인지 표시"하므로, 고정된 기록이 아니라 변화하는 작동 모델입니다. 비용 청구는 소유자를 따릅니다: "자동 Brain 업데이트는 Project 소유자의 크레딧을 사용합니다."
개인 메모리
사용자 자신의 메모리는 세 번째 저장소이며, 이것이 Project에 적용되는지 여부는 설정에 따라 다릅니다. Projects 문서에서는 소유자 전용 제어 기능인 "세션 생성자의 메모리 사용(Use session creator's memory)"을 설명하며, 이는 쿼리가 "세션을 시작한 사람의 개인 메모리에서 정보를 가져올 수 있는지" 여부를 결정합니다. Memory 문서에서는 그 효과를 다음과 같이 명시합니다: "이 설정이 켜져 있으면 프로젝트의 각 세션은 해당 세션을 시작한 사람의 개인 메모리도 활용합니다. 꺼져 있으면 프로젝트의 세션은 공유된 Brain만 사용합니다."
How that plays out depends on the plan. 개인 계정의 경우, "Project에 다른 멤버가 추가되면 멤버의 개인 메모리를 사용할 수 없습니다." Enterprise 요금제의 경우, "조직의 메모리 설정에서 허용하지 않는 한, 공유된 Projects에서 개인 메모리를 사용할 수 있습니다." 이 경우, 동일한 Project에서 동일한 질문을 하는 두 팀원이 세션을 시작한 사람에 따라 서로 다른 컨텍스트를 얻을 수 있습니다.
Enterprise 메모리 문서에서는 이를 다른 문구인 "이 프로젝트에서 개인 세션 참조(Reference personal sessions in this project)" 옵션으로 설명하며, Project 내부에서 기록된 메모리는 "해당 Project로 범위가 제한되며, 글로벌 메모리로 흘러 들어가지 않는다"고 명시합니다. Enterprise를 사용 중이라면 Project 설정에 어떤 제어 옵션이 표시되는지 확인해 보세요.
커넥터의 파일
연결된 앱에서 가져온 파일은 원본과 연결된 상태로 유지되지 않습니다. "연결된 소스에서 추가한 파일은 일회성 복사본입니다. 연결된 앱에서 원본을 업데이트하거나 삭제해도 Project의 복사본은 변경되지 않습니다." 도움말 센터에서는 커넥터를 통해 Perplexity에 최신 버전을 가져오도록 요청하거나, 파일을 다시 추가할 것을 권장합니다.
사람들이 흔히 오해하는 부분
히스토리가 전체 아카이브라고 가정하는 것. 압축(Compaction)은 오래된 커밋을 하나의 스냅샷으로 합칩니다. 현재 파일은 보존되지만, 누가 무엇을 변경했는지에 대한 긴 기록은 사라집니다.
Brain이 프로젝트 파일 내에 존재한다고 가정하는 것. 이는 프로젝트 파일과 함께 로드되는 별도의 지식 리포지토리입니다.
공유된 Project의 모든 사람이 동일한 답변을 얻는다고 가정하는 것. Enterprise에서 세션 생성자의 메모리가 켜져 있으면, 각 세션은 서로 다른 사람의 메모리를 활용할 수 있습니다.
커넥터가 파일을 최신 상태로 유지한다고 가정하는 것. 커넥터 파일은 한 번 생성된 복사본입니다.
해결책: 결정을 파일에 기록하고, Brain 보관 내용을 확인하며, 복사된 내용을 새로 고침하기
1단계: 팀이 의존하는 결정을 프로젝트 파일에 기록하기
Project의 모든 사람에게 일관되게 적용되어야 하는 내용이 있다면, 이를 세션에 남겨두지 말고 Project 내의 파일에 기록하세요. 무엇이, 언제, 누구에 의해, 왜 결정되었는지를 담은 짧은 결정 사항 파일을 하나 유지하세요. 폴더를 검색하는 에이전트가 쉽게 찾을 수 있도록 명확한 이름의 일반 Markdown 파일로 작성하세요.
Project의 지침(instructions)은 조사 결과가 아니라 Computer가 작동하는 방식을 지정하는 데 사용하세요. 도움말 센터에서는 "최대 8,000자"의 지침을 허용하며, "선호하는 응답 형식이나 계속 업데이트할 상태 파일"과 같은 용도를 제안합니다. 상태 파일은 정확히 리포지토리에 속해야 하는 종류의 파일입니다.
2단계: Brain과 개인 메모리가 Project에 무엇을 추가하는지 확인하기
요금제에 Brain이 포함되어 있다면, Brain 탭 또는 새 레이아웃의 Sources > Brain을 열고 현재 보관된 내용을 읽어보세요. 잘못된 내용이 있다면 수정하세요. 도움말 센터에 따르면 수정 사항은 다음 실행에 반영됩니다. 그런 다음 Project의 Memory 설정을 확인하세요. Brain이 자동으로 업데이트되는지 수동으로 업데이트되는지, 그리고 세션 생성자의 메모리가 켜져 있는지 확인하세요.
Enterprise의 경우, Project가 공유되어 있고 팀 전체에서 답변이 일관되어야 한다면 세션 생성자의 메모리를 끄는 것을 고려해 보세요. 그렇게 하면 모든 세션이 동일한 공유 Brain과 동일한 파일에서 작동합니다. 이는 상황에 따른 판단 영역입니다. 주로 혼자 사용하는 Project에서는 개인 메모리가 유용할 수 있습니다.
3단계: 커넥터 복사본을 새로 고치고, 결정 이유에 대한 기록을 커밋 로그 외부에 보관하기
커넥터에서 가져온 Project 내 파일 목록을 작성하고, 어떤 파일을 최신 상태로 유지해야 하는지 결정하세요. 소스가 변경되면 해당 파일을 다시 추가하거나, 이에 의존하기 전에 Perplexity에 최신 버전을 가져오도록 요청하세요.
그런 다음 중요한 결정의 배경이 되는 논리를 커밋 보존 윈도우에 의존하지 않는 곳에 보관하세요. Project 내부의 결정 사항 파일이 이 역할을 합니다. 여러 Projects와 도구에 걸쳐 필요한 컨텍스트의 경우, 별도의 저장소를 사용하는 것이 더 효과적입니다. 동시에 이전 Perplexity 작업을 통합하려는 경우, Perplexity 채팅 히스토리 이동 가이드에서 내보내기 방법을 확인할 수 있습니다.
MemoryLake에서 설정하기
Project의 파일, 히스토리, Brain은 모두 Perplexity 내부에 존재하며, 각 Project는 자체적인 공간입니다. 단일 Project보다 오래 지속되는 결정 사항들은 자체적인 보금자리가 필요합니다. MemoryLake는 이러한 결정 사항들을 사용자가 관리하는 하나의 목록에 보관하여 Perplexity 및 다른 어시스턴트가 사용할 수 있도록 하는 메모리 레이어입니다.
항목은 사용자가 직접 자신의 언어로 작성합니다. 사용자의 Perplexity Projects, Brain, 개인 메모리 또는 다른 벤더의 저장소에서 데이터를 읽거나, 쓰거나, 삭제하지 않습니다. Project에 고객사나 회사 작업이 포함되어 있다면, 세부 정보를 다른 곳에 복사하기 전에 조직의 정책을 확인하세요.
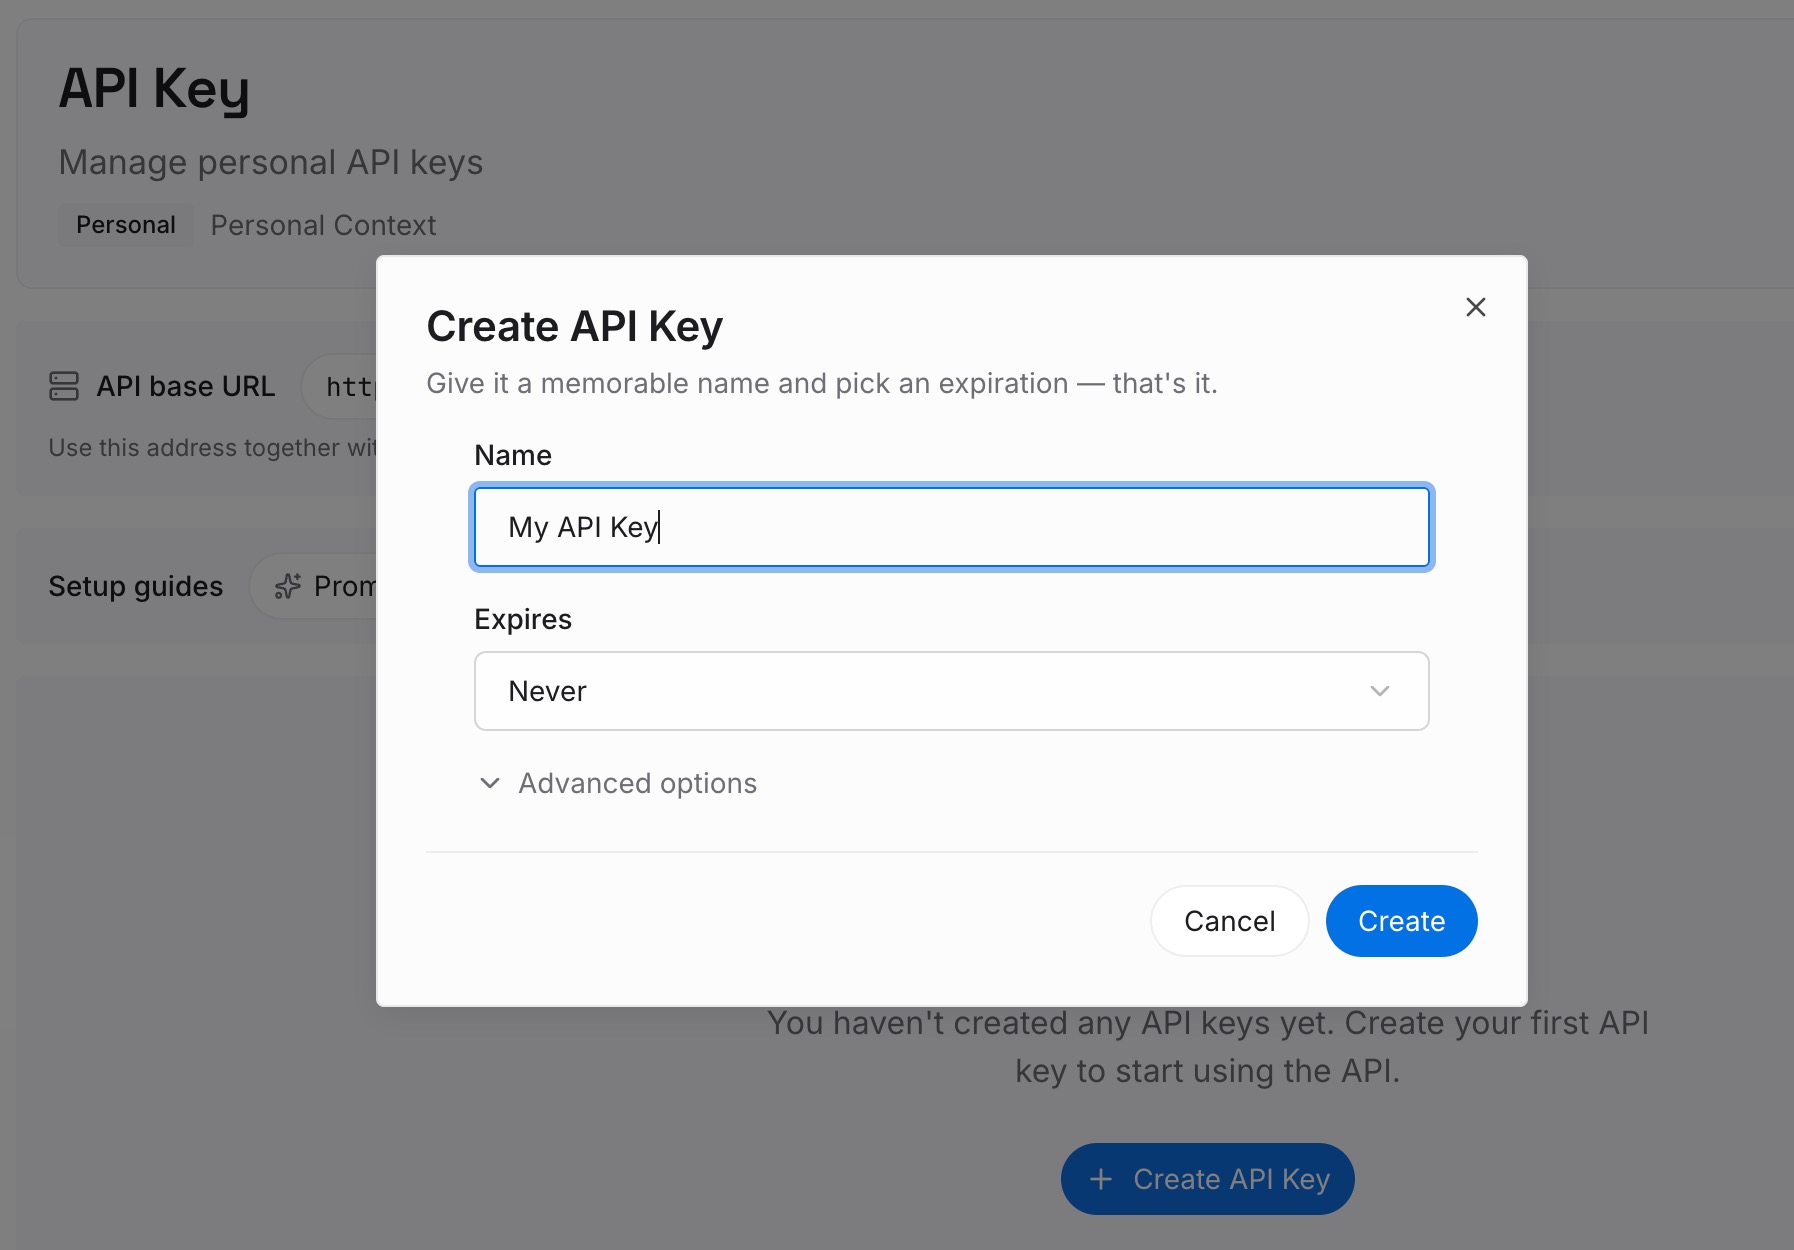
1단계: API 키 생성하기
로그인한 후 대시보드에서 키를 생성합니다. 이 키는 MemoryLake 워크스페이스에 속하며 Perplexity 계정과는 별개입니다.
2단계: 첫 번째 메모리 업로드하기
Project의 결정 사항 파일부터 시작해 보세요. 항목당 하나의 결정을 날짜, 이유, 출처 Project와 함께 기록합니다.
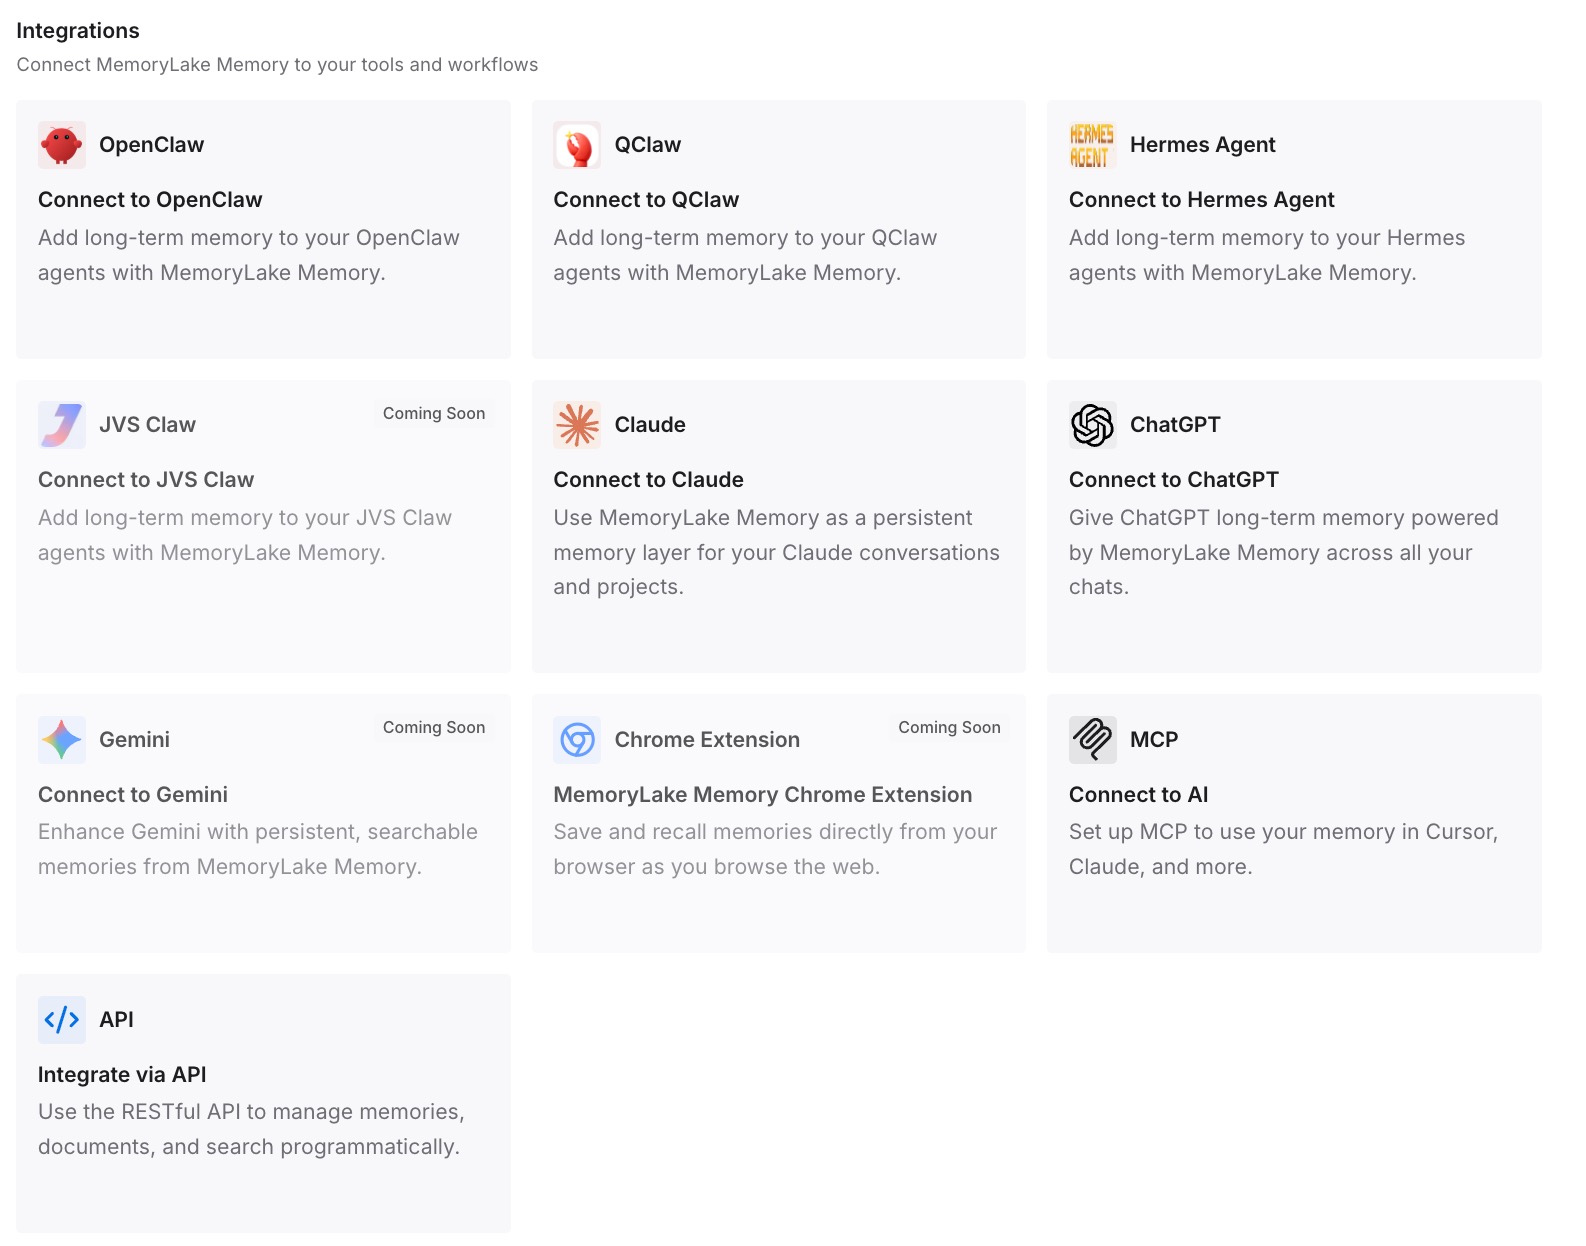
3단계: AI 및 에이전트 연결하기
사용 중인 어시스턴트를 연결하세요. 그러면 단일 Project의 Brain이나 히스토리에 의존하지 않고도, 새로운 Perplexity Project나 다른 도구에서 동일한 결정 사항을 사용할 수 있습니다.
실무에서 달라지는 점
첫 번째 차이점은 무엇을 신뢰할 수 있는지 알게 된다는 것입니다. Project의 현재 파일은 영구적이며 자동 덮어쓰기로부터 보호됩니다. 하지만 그 뒤에 있는 히스토리는 단기적입니다.
두 번째는 공동 작업에서 예상치 못한 상황이 줄어든다는 점입니다. Brain과 개인 메모리가 별도의 저장소라는 점을 알고 나면, 왜 한 팀원의 세션이 알고 있는 내용을 다른 팀원의 세션은 모르는지 설명하기가 더 쉬워집니다. 이러한 분리는 다른 곳에서도 나타납니다: Claude Code Projects도 프로젝트 메모리를 리포지토리와 분리하여 유지하며, Devin의 메모리는 자체 Git repo에 저장됩니다.
Perplexity Projects 모범 사례
결정 사항을 파일에 기록하세요. 세션과 히스토리는 영구적인 기록이 아닙니다.
Brain을 정기적으로 확인하세요. 출처를 확인하면서 잘못된 항목을 수정하세요.
Project별로 개인 메모리 사용 여부를 결정하세요. 공유 Projects에서는 이 기능을 끄는 것이 좋은 경우가 많습니다.
커넥터 파일을 새로 고치세요. 이 파일들은 한 번 생성된 복사본입니다.
스토리지 제한을 주의하세요. 제한을 초과한 오래된 Projects에는 새 파일을 업로드할 수 없습니다.
여러 Project에 걸친 지식은 다른 곳에 보관하세요. 각 Project는 독립된 공간입니다. 이전 Spaces 콘텐츠도 동일한 문제를 야기하며, 이에 대해서는 Perplexity가 Spaces 콘텐츠를 잊어버리는 현상에 대한 가이드에서 설명하고 있습니다.
결론
Perplexity의 10월 12일 포스트는 모든 Project가 Git 리포지토리에 의해 지원됨을 확인해 줍니다. 에이전트는 자체 샌드박스에서 커밋을 수행하고, 다른 변경 사항과 충돌하는 변경 사항은 자동으로 덮어쓰는 대신 다시 적용(replay)되며, 수락된 모든 변경 사항은 작성자와 함께 로그에 기록됩니다.
두 가지 중요한 제한 조건이 있습니다. 히스토리는 임계값을 초과하면 압축되어 오래된 커밋이 단일 스냅샷으로 합쳐집니다. 또한 파싱된 문서 텍스트, Brain의 지식 리포지토리, 개인 메모리, 커넥터 복사본의 원본 등 여러 종류의 컨텍스트가 리포지토리 외부에 존재합니다.
리포지토리를 현재 파일을 보관하는 공간으로 취급하고, 결정 사항을 해당 파일에 기록하며, 나중에 필요한 논리적 근거는 압축 단계가 닿지 않는 안전한 곳에 보관하세요.