
Anthropic 实际发布的内容
实质内容包含在两个文档页面中:“在云端使用 Claude Code”和云端环境参考。第一页指出:“云端会话可在 Pro、Max 和 Team 计划中使用,也适用于拥有高级席位或 Chat + Claude Code 席位的 Enterprise 用户。”你可以从浏览器、移动应用、桌面应用或终端使用 claude --cloud 启动一个会话。
第二页包含对上下文至关重要的部分。其“从你的设置中继承了什么”部分以三句话开篇,总结了整个设计:“云端会话从你的仓库的全新克隆开始。你提交到仓库的任何内容都是可用的。你仅在自己机器上安装或配置的任何内容在会话中都不可用。”
下面是一个逐行的表格。显示“是”的行都有相同的理由:“克隆的一部分。”你的仓库的 CLAUDE.md、它的 .claude/rules/、它的 .claude/skills/、.claude/agents/ 和 .claude/commands/ 都会到达,因为它们是仓库中的文件。
显示“否”的行则是人们在没有思考的情况下所依赖的内容:
- 你的用户级
~/.claude/CLAUDE.md,因为它“存在于你的机器上,而不是仓库中。” - 你的用户技能、智能体(agents)和命令,它们“存在于你的机器上,而不是仓库中。请将它们提交到仓库的
.claude/目录中。” - 你仅在用户设置中启用的插件。
- 你在默认本地作用域或用户作用域添加的 MCP 服务器,因为“这些会写入你机器上的
~/.claude.json,而不是仓库。”
设置文档从另一个方向说明了同样的事情。用户和项目本地设置(~/.claude/settings.json 和 .claude/settings.local.json)“不被读取。两者都保留在你的机器上,且本地文件不在克隆中。”云端环境页面针对钩子(hooks)添加了特定警告:“如果你的用户级 ~/.claude/settings.json 中有 SessionStart 钩子,不要指望它们在云端运行。用户级设置保留在你的机器上。”
而在此次发布之前的记忆文档,已经回答了关于 Claude 在你的机器上学到了什么的问题:“自动记忆是机器本地的。同一个 git 仓库中的所有工作树和子目录共享一个自动记忆目录。文件不会跨机器或云端环境共享。”
Anthropic 得出的一行结论很直白:“要使你自己的配置在云端会话中可用,请将其提交到仓库。”
这改变了什么,没有改变什么
正式版(GA)并没有改变云端会话的工作方式;该表格在预览期间就已经存在。改变的是规模:云端会话现在是整个团队每天都可以使用的功能,包括在无人看管的情况下执行任务。
这把问题转移到了“它启动时知道什么”。本地会话启动时带有几层上下文:仓库的 CLAUDE.md、你的个人 ~/.claude/CLAUDE.md、你的个人技能、你的 MCP 服务器、你的钩子,以及 Claude 在这台机器上为该项目积累的任何自动记忆。而云端会话启动时只包含第一层,以及你刻意放在云端可以访问到的地方的任何内容。
它也没有改变从终端交接的方向。文档明确指出:“从 CLI 来看,会话交接是单向的:你可以使用 --teleport 将云端会话拉取到你的终端,但你不能将现有的终端会话推送到云端。”桌面应用是个例外,其 Continue in 菜单“可以将本地会话发送到云端”。
传送(Teleporting)也是创建副本而不是链接。当你拉取一个云端会话时,“终端会获得该会话的专属副本:那里的新工作保留在本地,不会出现在 claude.ai 或 Claude 移动应用上的云端会话中。”文档还将其与恢复(resuming)区分开来:“--resume 从这台机器的本地历史记录中重新打开对话,不列出云端会话;--teleport 则拉取云端会话及其分支。”
如果你读过为什么 Claude Code 在你的另一台机器上会遗忘,你已经了解了自动记忆这部分故事。本文则是关于用户层的其余部分:指令、技能、服务器、钩子和设置,正是这些让本地会话表现出它们特有的行为,而除非你移动它们,否则它们都不会随之迁移。
人们会从中得到什么启示 —— 以及他们不应该误解什么
“我的设置现在都在云端了。” 并没有。你的账号已登录,且你组织的服务器管理设置确实会到达 —— 表格指出它们是“在会话启动时从 Anthropic 的服务器获取的”。但是你在主目录中构建的配置仍然在你的笔记本电脑上。
“云端会话将从我的终端离开的地方继续。” 只有在相关状态存在于仓库中时才会如此。终端会话无法从 CLI 推送到云端,而传送的会话会变成一个独立的本地副本。两个看起来像同一个对话的会话可能会悄悄分叉,就像 分叉的 Claude Code 会话 会将副本学到的内容据为己有一样。
“仓库的设置文件涵盖了一切。” 大部分情况下,对于单个仓库是这样。对于 .claude/settings.json 中的钩子和权限规则,表格写着“是的,在包含单个仓库的会话中” —— 然后补充道“包含多个仓库的会话(包括项目线程)启动于克隆之上,不会读取它们。”在仓库中声明的插件是另一种情况:“云端会话不会安装仓库在 enabledPlugins 下启用的插件。”
“Claude 安装的任何东西下次都会存在。” 文档对于临时安装有不同的说法:“你也可以要求 Claude 在会话中途安装包,但这些安装不会结转到其他会话。”对于会话始终需要的内容,请使用设置脚本。
“我会把我的 token 放在环境变量中。” Anthropic 的警告很直接:“任何使用该环境的人都可以读取其环境变量和设置脚本。”在 Pro 和 Max 计划中,文档指向了由智能体代理(agent proxy)附加的 API 凭据。
这些都不是设计缺陷。云端会话故意设计为一个干净的机器,而干净的机器只知道你给它的东西。
解决方案:决定每个会话应该知道什么,然后将其放在云端可以读取的地方
云端会话应该从与优秀的本地会话相同的运行上下文开始,并且它做出的任何决定都应该最终保存在下一个会话可以找到的地方。
步骤 1:盘点你的用户层并将其分类为团队和个人
打开你的主文件夹,列出 Claude Code 为该项目从中读取的内容:
~/.claude/CLAUDE.md—— 你的个人指令。~/.claude/skills/、~/.claude/agents/、~/.claude/commands/—— 你的个人程序。~/.claude/settings.json—— 钩子、权限规则和用户作用域的插件。~/.claude.json—— 在本地或用户作用域添加的 MCP 服务器。- 该项目的自动记忆目录,其
MEMORY.md是 Claude 已保存内容的索引。
对于每个项目,问一个问题:开始这项任务的队友会需要它吗?构建命令、测试规范以及代码库依赖的 MCP 服务器都是团队上下文,只是碰巧存在于你的主文件夹中。而你偏好的回答长度和个人审查清单则是个人上下文。
特别仔细地阅读你的自动记忆。这是 Claude 记录它在与你合作时摸索出的内容的地方:不稳定的测试、实际起作用的命令。任何整个团队都应该知道的内容都属于仓库。
如果你的个人指令文件和项目指令文件发生了冲突,请先解决它。调和冲突的 CLAUDE.md 层 介绍了该问题的本地版本,而当其中一层在云端完全消失时,情况会变得更糟。
步骤 2:将每个项目移动到文档指定的位置
Anthropic 的表格告诉了你每样东西应该去哪里,所以请遵循它。
团队指令放入仓库的 CLAUDE.md 或 .claude/rules/。团队技能、智能体和命令放入仓库的 .claude/ 目录,表格将其标记为可用,因为它是“克隆的一部分”。
项目所需的 MCP 服务器应在项目作用域内添加。文档描述了途径:“使用 claude mcp add --scope project 添加服务器,这会写入仓库的 .mcp.json,然后提交该文件。包含单个仓库的会话会加载它。”
设置环境的钩子属于仓库的 .claude/settings.json 或设置脚本;文档指出钩子在“Claude Code 启动后,在每个会话(包括恢复的会话)中运行”。
你希望在所有地方都使用的个人技能和插件有第二条途径。表格指出“云端会话会自动加载你在 claude.ai 上启用的技能”,并且为你的 claude.ai 账号启用的插件会作为同步插件加载。
机密信息不适用这两种处理方式。不要将它们放在其他人可以读取的环境变量中,并在你的计划提供 API 凭据机制时使用该机制。
步骤 3:简报每个云端任务,并将做出的决定带回仓库
即使仓库状态良好,云端任务也能从简短的简报中受益:任务是什么、什么是“完成”、做出了哪些决定,以及哪些文件不要触碰。把它写给一个从未见过你笔记本电脑的承包商,因为实际情况就是这样。
然后闭环。当云端会话做出值得保留的决定时 —— 比如一个规范、一个变通方法、一个固定依赖版本的原因 —— 要求它将该决定作为同一个拉取请求的一部分写入仓库。否则,它只存在于该会话的转录记录中,而之后的每个会话启动时都不会包含它。
最后,决定长任务的规范副本存在于何处。如果你将一个会话传送(teleport)到你的终端并继续工作,请记住文档的措辞:那里的新工作“保留在本地,不会出现在云端会话中”。选择一个地方继续,并将另一个地方视为历史记录。
如果你使用 Claude Code 项目来协调多个云端线程,你将为此获得一个额外的层。项目文档将项目记忆描述为 Claude 记录的关于需求、决定和陷阱的笔记,并指出“它们与 Claude Code 在你机器上保留的自动记忆是分开的,即使两者都使用 MEMORY.md 索引。”该共享记忆如何在跨线程中工作在 Claude 重新设计的项目 中有详细介绍。
在 MemoryLake 中进行设置
将团队上下文移入仓库解决了属于单个代码库的部分。剩下的是跨越仓库、机器和工具的上下文:适用于三个服务的架构决策、规范背后的原因、你自己的工作偏好、上季度结束的项目教训。MemoryLake 是保留该层的地方,以便它能触及你启动的每个会话,无论是本地还是云端。
你自己用自己的话编写这些条目。不会从你的 ~/.claude 文件夹、你的自动记忆目录、你的云端会话或任何供应商的存储中读取、写入或删除任何内容。
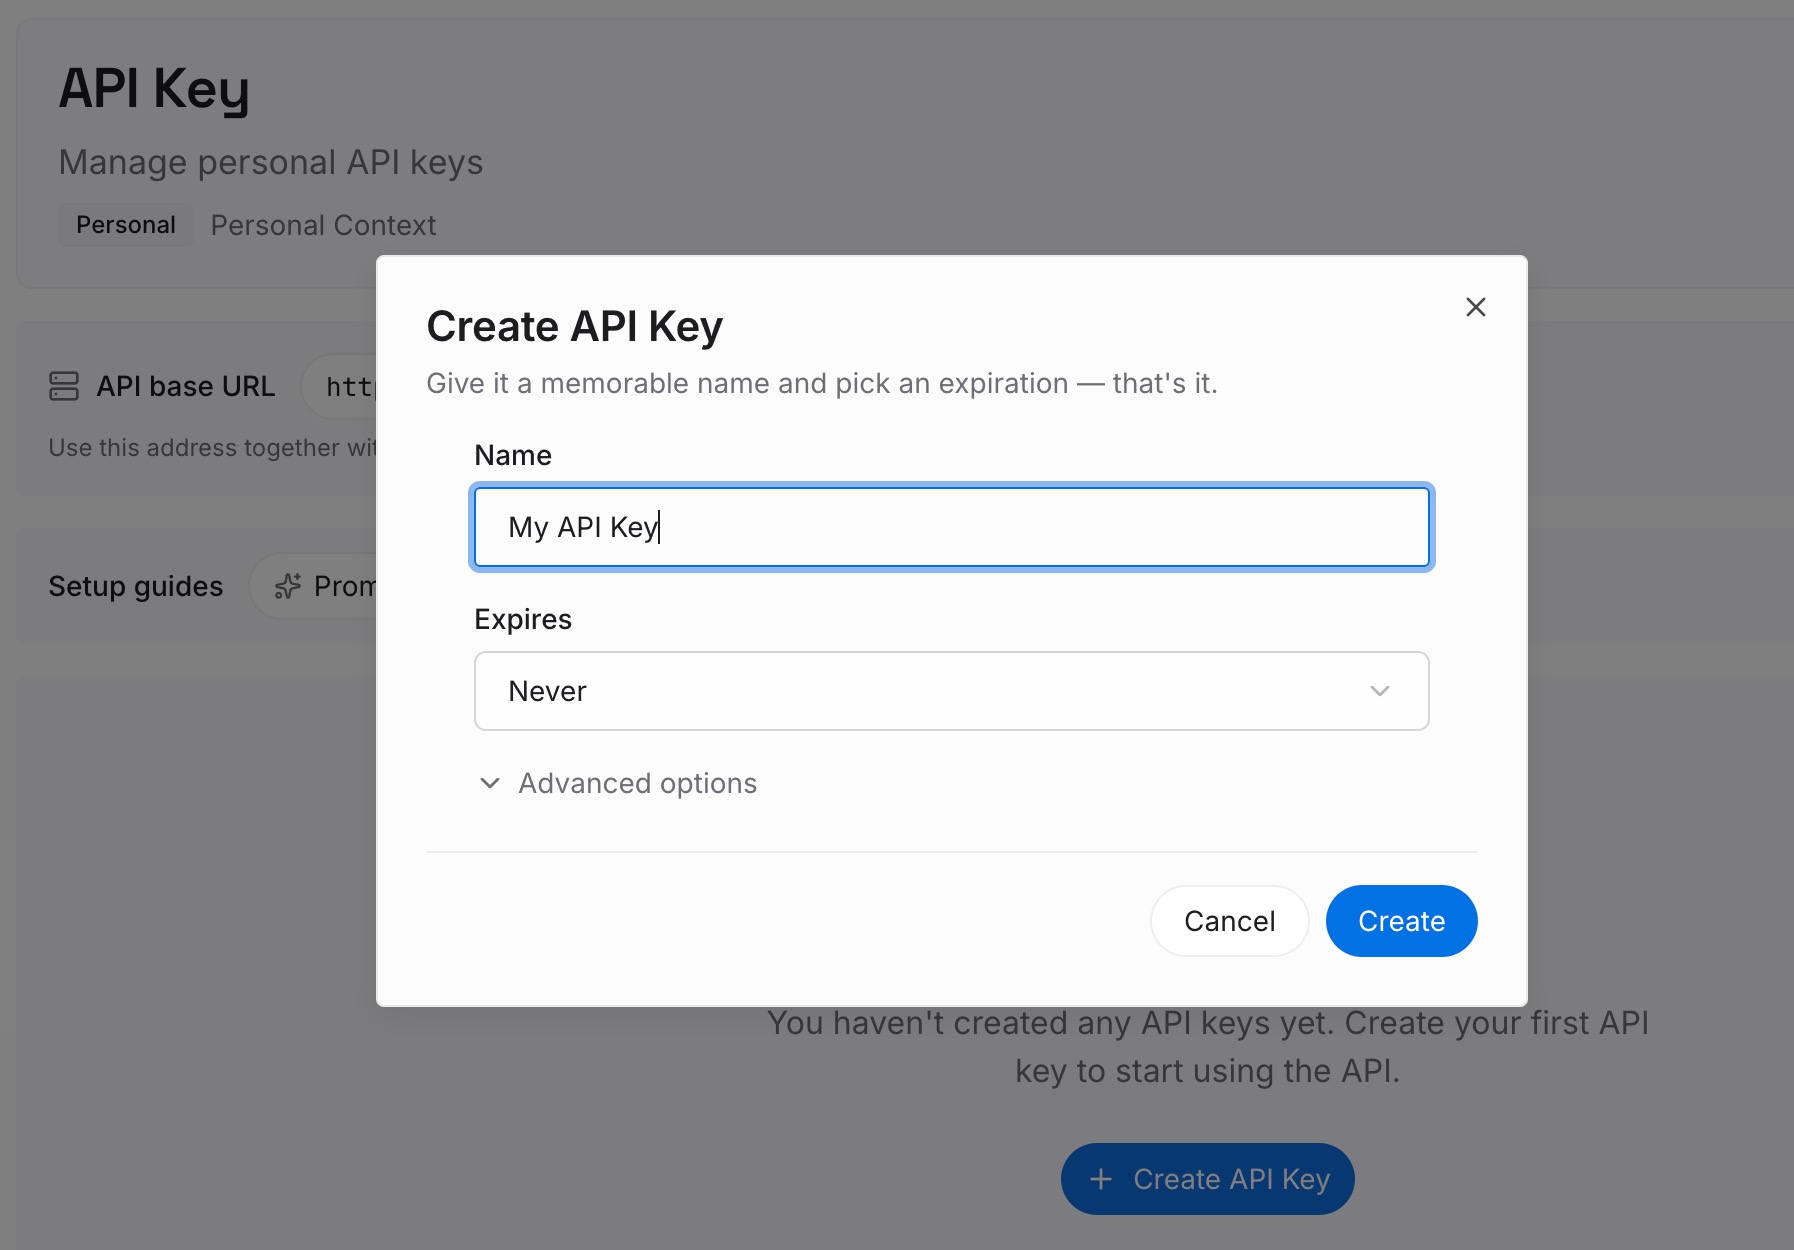
步骤 1:创建 API 密钥
登录并从控制面板生成一个密钥。该密钥属于你在记忆层中的工作空间,而不是任何一台机器,因此全新的云端克隆和你的笔记本电脑都能访问同一个地方。
步骤 2:上传你的第一批记忆
从上面解决方案中的步骤 1 盘点开始:跨项目决策、规范背后的原因,以及你原本会在每次简报中重复的偏好。每个条目包含一个事实,用你向新队友解释的方式来表述。
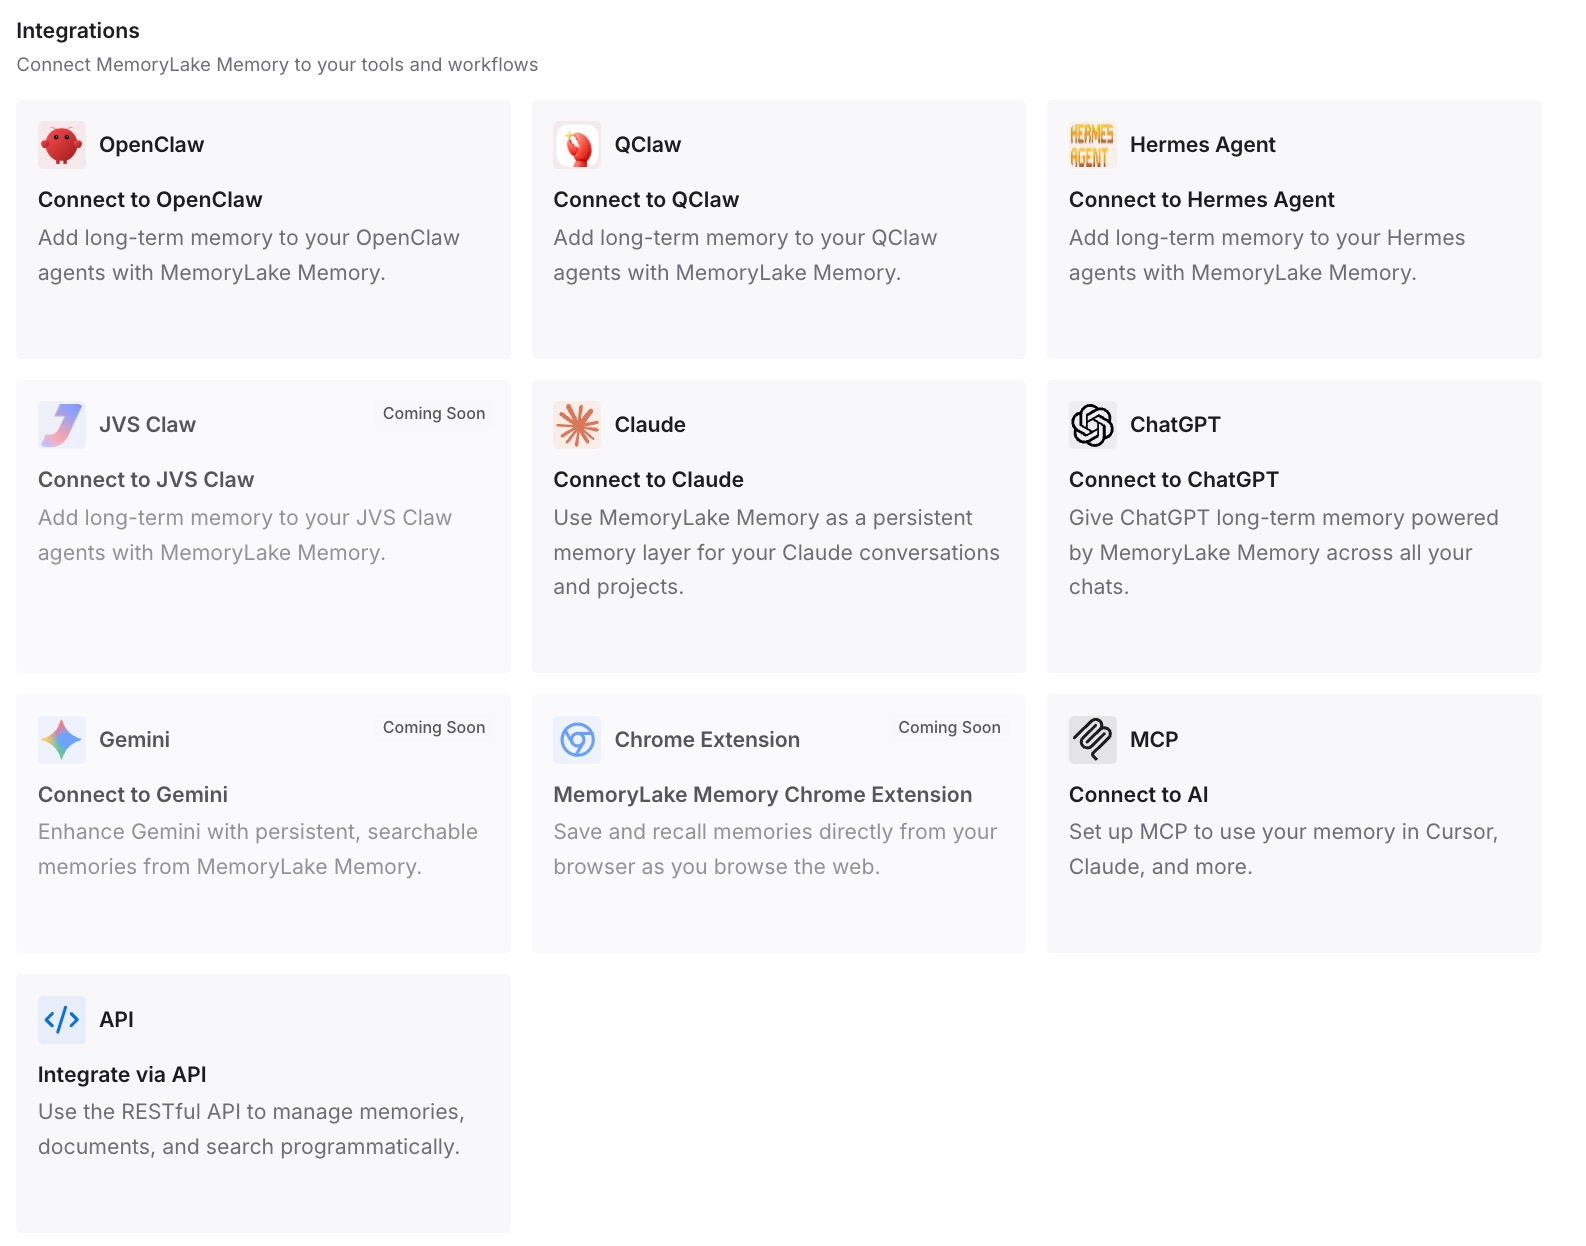
步骤 3:连接你的 AI 和智能体
连接 Claude Code 和你使用的其他助手。这样,无论会话在哪里运行,相同的条目都可用,包括那些根本不读取 CLAUDE.md 的工具。
这在实践中改变了什么
第一个区别是,云端会话不再让人觉得不如本地会话强大。人们注意到的大多数差距是主文件夹中缺失的上下文,而不是模型或机器的问题。
第二个区别是,个人和团队上下文终于分开了。决定 ~/.claude 中哪些项目属于团队知识这一行为本身就很有用,它往往会暴露出本应一直存在于仓库中的指令。这与在 Claude Code 会话之间共享上下文中描述的分类工作相同,只是期限更紧迫。
第三个区别是,长任务的交接变得更加安全。一个获得良好简报并将其决定写回仓库的会话会留下一条线索,供下一个会话遵循,无论它在哪里运行。
第四个区别是概念上的。在上下文工程(context engineering)方面,云端会话表明上下文是你组装出来的东西,而不是智能体随身携带的东西。同样的逻辑也适用于长期运行中,在压缩(compaction)期间你告诉 Claude Code 保留什么决定了什么能存活下来。
Claude Code 云端会话的最佳实践
将云端环境视为新队友的机器。 它只有仓库,没有你设置中的其他任何东西。据此对它进行简报。
提交团队上下文,而不是个人上下文。 构建命令、规范和项目 MCP 服务器放入仓库。你的个人风格偏好不需要放入。
对代码库所需的 MCP 服务器使用项目作用域。 在用户作用域添加的服务器存在于 ~/.claude.json 中,并保留在你的笔记本电脑上。
不要将机密信息放在环境变量中。 任何使用该环境的人都可以读取它们。
为长任务选择一个规范副本。 传送会创建一个本地副本;决定哪一边继续。
将决定作为拉取请求的一部分写回。 留在转录记录中的决定对下一个会话是不可见的。当你手动将会话移动到另一台机器时,情况也是如此。
结论
云端会话结束研究预览是一个真正的里程碑:给 Claude Code 一个任务,合上笔记本电脑,回来时工作就已经完成了。
Anthropic 的文档对另一半也同样清晰。云端会话是一个全新的克隆。你的用户级 CLAUDE.md、你的个人技能、你的用户作用域 MCP 服务器、你的钩子和你的自动记忆都保留在你的机器上。正如文档所说,“要使你自己的配置在云端会话中可用,请将其提交到仓库。”
盘点用户层,将团队上下文移入仓库或你的 claude.ai 账号,简报每个任务,并将决定带回。将跨仓库的上下文保留在每个会话都能触及的层中。