
Lo que la documentación dice ahora que es un proyecto
La definición de Anthropic es compacta: "Un proyecto es una conversación continua en la que Claude coordina un flujo de trabajo relacionado para ti". Envías trabajo a esa conversación y Claude lo canaliza.
Los trabajadores son hilos. La documentación describe a cada uno como "una sesión independiente con su propia ventana de contexto que realiza una tarea y reporta de vuelta a la conversación cuando termina". La conversación coordinadora tiene una visión más estrecha de lo que podrías suponer: "Ve lo que los hilos reportan de vuelta, no cada paso que dan".
La disponibilidad sigue siendo gradual. La documentación dice: "Los proyectos están en beta pública en los planes Pro y Max y se están implementando gradualmente, comenzando con las cuentas que han utilizado sesiones en la nube y no tienen proyectos existentes en el chat de claude.ai o Cowork". También añade: "Aún no están disponibles en los planes Team o Enterprise". Si tienes proyectos más antiguos en el chat o en Cowork, se mantendrán como están por ahora: "Esos proyectos seguirán funcionando como lo hacen hoy hasta que les llegue la experiencia rediseñada".
Cada hilo en la nube comienza con el mismo kit. Según la documentación, ese kit son los repositorios y archivos del proyecto más "sus instrucciones y memoria", el CLAUDE.md y las habilidades en cada uno de los repositorios del proyecto, los conectores en tu cuenta de claude.ai y un entorno en la nube. Una línea descarta el resto: "Los hilos en la nube no toman nada de la configuración de Claude Code en tu propia máquina".
Esa frase es el primer indicio de que la memoria en un proyecto no es la memoria que ya tienes.
Dónde reside la memoria del proyecto
La memoria del proyecto es un conjunto de archivos que Claude escribe en la nube
La tabla de contexto de la documentación describe la memoria del proyecto como "Notas que Claude guarda sobre el proyecto, como requisitos, decisiones y dificultades, almacenadas como archivos". También explica cómo la usan los hilos: "Cada hilo en la nube lee el archivo de índice MEMORY.md cuando se inicia y abre los demás archivos cuando los necesita".
Puedes ver esos archivos. La misma tabla indica: "Lee, edita y elimina los archivos en Configuración del proyecto > Memoria", y puedes cambiarlos hablando con Claude: "Pídele a Claude en la conversación del proyecto o en cualquier hilo en la nube que recuerde un requisito, una decisión o una dificultad, o que los olvide".
En la pantalla de configuración, los archivos se encuentran bajo una etiqueta que te resultará familiar. "Configuración del proyecto > Memoria enumera estos archivos bajo Memoria automática, porque Claude los escribe por sí mismo a medida que trabaja en el proyecto".
El mismo nombre de archivo, tres almacenamientos diferentes
Aquí es donde la gente se confunde. Claude Code en tu propia máquina también mantiene una memoria automática con un índice MEMORY.md. La documentación de memoria de Anthropic lo ubica en ~/.claude/projects/<project>/memory/ y es directa sobre su alcance: "La memoria automática es local de la máquina". Añade que "Los archivos no se comparten entre máquinas ni entornos en la nube".
La documentación de proyectos traza el límite desde el otro lado: "Son independientes de la memoria automática que Claude Code guarda en tu máquina, aunque ambos utilicen un índice MEMORY.md".
Así que un proyecto tiene su propio MEMORY.md, tu laptop tiene otro, y ninguno es el otro. Si has pasado meses dejando que Claude Code aprenda las peculiaridades de tu compilación localmente, ese aprendizaje se queda de forma local. Nuestra guía sobre por qué Claude Code olvida en otra máquina cubre ese límite para sesiones ordinarias; un proyecto es un lugar más al otro lado de esa frontera.
El tercer almacenamiento es el que tú escribes. "La memoria del proyecto también es independiente de los archivos CLAUDE.md en los repositorios del proyecto". Cada hilo en la nube carga esos archivos desde su clon, y Anthropic ofrece una regla clara sobre qué va en cada lugar: "coloca las instrucciones sobre un repositorio en su CLAUDE.md y las notas sobre el proyecto en la memoria del proyecto".
Luego están las instrucciones del proyecto, que se encuentran en la misma sección de Memoria de la configuración y son la parte más confiable de esta. La tabla las describe como "Texto enviado a cada nuevo hilo y a Claude en la conversación del proyecto, de hasta 16,000 caracteres".
En conjunto, el contexto permanente de un proyecto proviene de cuatro lugares:
- Archivos
CLAUDE.mddel repositorio, que tú escribes y confirmas (commit), y que cada hilo en la nube carga desde su clon. - Instrucciones del proyecto, que tú escribes en la configuración y que recibe cada nuevo hilo.
- Memoria del proyecto, que Claude escribe a medida que trabaja y que cada hilo en la nube lee a través de
MEMORY.md. - Memoria automática de tu máquina, que Claude escribe en tu laptop y que permanece en esa máquina.
Claude escribe la memoria del proyecto, y lo que escribe es una guía
La memoria del proyecto se llena por sí sola. Cuando le dices al coordinador cómo quieres que se ejecute el trabajo, "Claude guarda preferencias como estas en la memoria del proyecto por su cuenta y las sigue en los hilos de la nube posteriores".
La documentación es cuidadosa con respecto al peso que tienen esas preferencias guardadas: "Son instrucciones que Claude sigue, no configuraciones obligatorias, por lo que un límite de hilos que indiques de esta manera no es un límite estricto". Si algo debe redactarse con precisión y aplicarse desde el primer hilo, Anthropic te sugiere utilizar las instrucciones del proyecto en su lugar.
Las correcciones funcionan de la misma manera. La documentación recomienda que "cuando corrijas un hilo, también le digas a Claude que recuerde la corrección: esta va a la memoria del proyecto y los hilos en la nube posteriores comenzarán con ella". De lo contrario, la corrección se queda en una sola transcripción, el problema general descrito en por qué Claude Code olvida tus correcciones.
La memoria del proyecto también realiza un trabajo que una conversación larga no puede hacer. "No gestionas las ventanas de contexto en un proyecto. Los hilos se compactan automáticamente y la conversación funciona a partir de mensajes recientes, hilos recientes y la memoria del proyecto en lugar de su historial completo, por lo que continúa funcionando durante todo el tiempo que dure el proyecto". La instrucción que sigue es la línea más práctica de la página: "Coloca cualquier cosa que nunca deba perderse en la memoria del proyecto". Si quieres ver qué conserva y qué descarta la compactación en una sesión ordinaria, nuestra guía de autocompactación lo explica detalladamente.
Qué hilos se inician sin ella
Un hilo en tu propia computadora
Algunas tareas necesitan tu máquina: una base de datos local, un emulador, una API detrás de tu VPN. Para ellas, puedes pedirle al proyecto que ejecute un hilo en tu computadora a través de Remote Control. La documentación enumera lo que cambia, y destaca un punto: dicho hilo "comienza con las instrucciones del proyecto, pero sin sus archivos de memoria cargados".
También "funciona con los archivos, herramientas, servidores MCP y la configuración de Claude Code en esa máquina, incluyendo sus hooks y reglas de permisos, en lugar del entorno en la nube del proyecto". En otras palabras, un hilo local llega con la configuración de tu laptop y las instrucciones del proyecto, y las dificultades que Claude guardó en la memoria del proyecto no forman parte de su inicio.
Un hilo local es una sesión de Claude Code en una carpeta de tu máquina, conectada a través de Remote Control. Nuestro análisis sobre la bifurcación de una sesión remota explica cómo se relacionan esas sesiones con las copias realizadas a partir de ellas.
Un repositorio que un hilo añade a mitad del proceso
Los hilos en la nube pueden incorporar un repositorio que el proyecto no tiene. La documentación explica los tiempos: "La clonación ocurre a mitad de la tarea, por lo que el CLAUDE.md y las habilidades de ese repositorio no estaban allí cuando comenzó el hilo. El siguiente hilo se inicia sin él".
Si el CLAUDE.md de un repositorio contiene reglas que los hilos necesitan desde el primer paso, añádelo al proyecto.
Hilos que ya se están ejecutando cuando cambias la configuración
"Los cambios en las instrucciones, repositorios, plugins y el entorno en la Configuración del proyecto llegan a los nuevos hilos, no a los hilos que ya se están ejecutando". Una instrucción que añadas al mediodía se aplicará a los hilos que Claude inicie después del mediodía.
Los subagentes y el límite del proyecto
Los hilos pueden usar subagentes para tareas secundarias, cada uno en su propia ventana de contexto, como se explica en por qué los subagentes de Claude Code no comparten memoria. El límite exterior es el proyecto en sí. "Un hilo pertenece al único proyecto que lo inició. No puedes mover ni copiar un hilo a otro proyecto, ni extraerlo para que funcione de forma independiente". Y: "No puedes fusionar dos proyectos en uno". Un proyecto también es personal: "Un proyecto pertenece a un solo usuario. No puedes compartir un proyecto ni sus hilos con otro usuario".
La eliminación es definitiva. Eliminar "elimina permanentemente el proyecto junto con sus hilos, su memoria y sus archivos, y desactiva las rutinas del proyecto. Esto no se puede deshacer".
Lo que la gente intenta en su lugar
Asumir que la memoria automática local se transfiere. Está diseñada para ser local de la máquina, y los hilos en la nube comienzan desde el kit del proyecto.
Colocar las reglas del repositorio en la memoria del proyecto. La división de Anthropic es más limpia: las reglas del repositorio en CLAUDE.md, las notas del proyecto en la memoria del proyecto.
Tratar un límite hablado como una configuración. Un límite de hilos que expresas en voz alta se guarda como una preferencia, y la documentación indica que no es un límite estricto.
Esperar que la conversación lo recuerde todo. Funciona a partir de mensajes recientes, hilos recientes y la memoria del proyecto.
Esperar que un hilo local conozca las dificultades del proyecto. Comienza con las instrucciones, no con los archivos de memoria.
Eliminar un proyecto para empezar de cero. Eso también elimina lo que Claude aprendió. Archivar es la opción reversible.
La solución: Dale a cada tipo de contexto un único hogar, luego verifica con qué comienza cada hilo
Paso 1: Clasifica lo que sabes en los tres lugares que un hilo puede leer
Haz una lista de todo lo que un nuevo hilo debería saber: convenciones de ramas, comandos de prueba, decisiones ya tomadas, dificultades con las que te has topado. Luego, clasifica cada elemento.
Cualquier cosa específica de un repositorio, como comandos de compilación o estilo de código, va en el CLAUDE.md de ese repositorio. Cualquier cosa que deba aplicarse a cada hilo, redactada con precisión, va en las instrucciones del proyecto; el resumen sugerido por Anthropic cubre para qué sirve el proyecto, dónde se realiza el trabajo, cómo verifica un hilo su trabajo y qué requiere tu aprobación previa. Las notas en evolución sobre requisitos, decisiones y dificultades pueden residir en la memoria del proyecto, donde Claude las mantiene.
Paso 2: Lee los archivos de memoria del proyecto como un documento
Abre Configuración del proyecto > Memoria y lee lo que Claude ha guardado. Verifica que cada entrada siga siendo verdadera, que las preferencias que expresaste de manera informal sean las que realmente deseas conservar y que no se haya guardado información confidencial por accidente.
Cuando algo esté mal, edita el archivo o pídele a Claude que lo olvide. Cuando cambie una decisión, dilo en la conversación y pídele a Claude que actualice la memoria, para que el siguiente hilo no trabaje con la versión anterior. Haz esto después de los primeros hilos y luego con un ritmo regular.
Paso 3: Informa a los hilos locales a través de las instrucciones del proyecto
Dado que un hilo en tu computadora comienza con las instrucciones del proyecto pero no con los archivos de memoria, cualquier cosa que una tarea local deba saber pertenece a las instrucciones o a la tarea misma. Antes de solicitar un hilo local, verifica si la dificultad relevante está solo en la memoria. Si es así, mueve una versión corta a las instrucciones o pégala en la solicitud.
Haz lo mismo con los repositorios que los hilos añaden bajo demanda: si una regla debe estar allí desde el primer paso, añade el repositorio al proyecto para que su CLAUDE.md se cargue al inicio.
Configuración de esto en MemoryLake
La memoria de un proyecto está limitada a un proyecto y a un usuario, y tu laptop conserva otra. Si las mismas decisiones se aplican a varios proyectos, al trabajo local y en la nube, y a otros asistentes que utilizas, resulta útil guardarlas en un lugar que no esté vinculado a ninguno de ellos. MemoryLake es una capa de memoria que tú mismo mantienes y conectas a las herramientas que utilizas.
Tú mismo escribes las entradas, con tus propias palabras. No se lee, escribe ni elimina nada de los archivos de memoria de tu proyecto, de la memoria automática de tu máquina ni del almacenamiento de ningún proveedor.
Paso 1: Crea una clave API
Inicia sesión y genera una clave desde el panel de control. La clave pertenece a tu espacio de trabajo de MemoryLake y es independiente de tu cuenta de Anthropic.
Paso 2: Sube tus primeras memorias
Comienza con las decisiones que trascienden a un solo proyecto: elecciones de arquitectura, reglas de nomenclatura, las razones detrás de correcciones pasadas. Una decisión por entrada, con fecha, para que una entrada más nueva reemplace visiblemente a una más antigua.
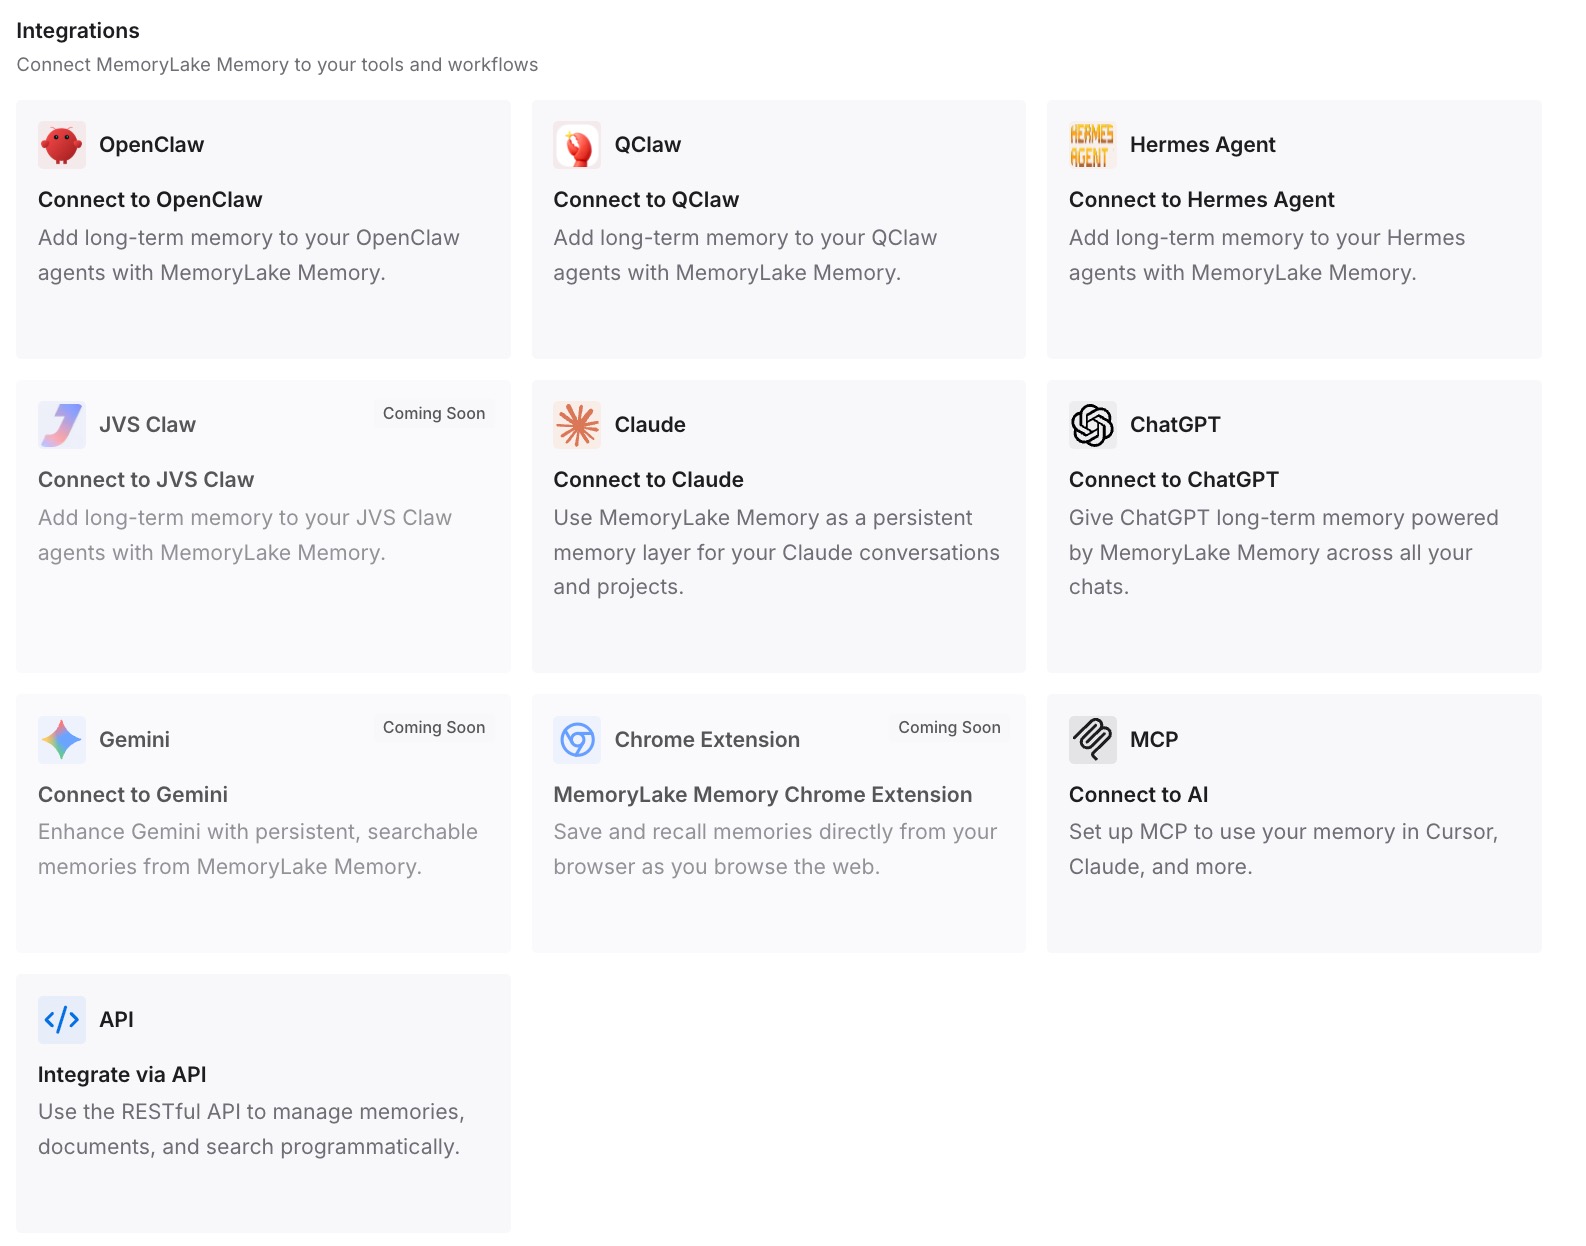
Paso 3: Conecta tu IA y agentes
Conecta Claude Code y los demás asistentes con los que trabajas. Las mismas decisiones estarán disponibles en cada uno de ellos, ya sea que la tarea se ejecute en un hilo del proyecto, en una sesión local o en cualquier otro lugar.
Qué cambia esto en la práctica
La primera diferencia es que hay menos correcciones repetidas. Una corrección guardada en la memoria del proyecto llega al siguiente hilo en la nube en lugar de quedarse en una sola transcripción.
La segunda es la predictibilidad de los hilos locales. Sabiendo que un hilo en tu computadora comienza con instrucciones pero no con memoria, lo informas adecuadamente.
La tercera es una división clara de autoridad. Las reglas del repositorio viven con el código, las reglas del proyecto en las instrucciones y las notas en evolución de Claude en la memoria, de modo que sabes qué archivo abrir cuando algo sale mal. Para sesiones locales y en la nube en general, nuestra guía sobre sesiones en la nube y tu configuración local enumera lo que se transfiere.
La cuarta es que hay menos pérdidas accidentales: archivas en lugar de eliminar, y conservas una copia de las decisiones que importan más allá del proyecto.
Buenas prácticas para la memoria del proyecto en Claude Code Projects
Escribe las instrucciones del proyecto antes del primer lote. Cada nuevo hilo las recibe, incluyendo los hilos en tu computadora.
Pídele a Claude que recuerde las correcciones. Así es como una solución llega a los hilos en la nube posteriores.
Revisa Configuración del proyecto > Memoria con regularidad. Edita o elimina las entradas que ya no sean verdaderas.
Mantén las reglas del repositorio en CLAUDE.md y los límites estrictos en las instrucciones. Las preferencias habladas se conservan, pero no se imponen.
Informa a los hilos locales explícitamente y añade los repositorios que contengan reglas. De lo contrario, ambos comenzarán sin el contexto que podrías estar asumiendo.
Archiva en lugar de eliminar. Eliminar borra hilos, memoria y archivos de forma definitiva.
Conclusión
Claude Code Projects ya está abierto para todos los usuarios de Pro y Max que se unieron a la lista de espera, y su documentación responde a la pregunta que surge después del acceso: dónde guarda un proyecto lo que aprende.
La memoria de un proyecto es un conjunto de archivos que Claude escribe en la nube, indexados por su propio MEMORY.md, legibles y editables en Configuración del proyecto > Memoria, e independientes tanto de la memoria automática de tu máquina como de los archivos CLAUDE.md de tus repositorios. Cada hilo en la nube la lee al inicio. Un hilo en tu propia computadora comienza con las instrucciones del proyecto, pero no con sus archivos de memoria.
Dale a cada tipo de contexto un único hogar, revisa lo que Claude guarda e informa a los hilos locales a través de las instrucciones. Así, el proyecto recordará lo que querías que recordara, en los hilos donde realmente importa.