La respuesta corta
- La memoria automática se comparte. Todos los worktrees de un repositorio utilizan un único directorio de memoria.
CLAUDE.mdproviene del propio checkout del worktree. Un nuevo worktree comienza desde tu rama predeterminada, por lo que tiene la versión confirmada allí.CLAUDE.local.mdno se comparte. Existe solo en el worktree donde lo creaste.- Los archivos ignorados por Git no están allí a menos que los listes en
.worktreeinclude. - Parte de la configuración se comparte con el checkout principal: plugins, aprobaciones de permisos y, en algunos casos, habilidades, agentes y comandos.
Memoria automática: un directorio para todo el repositorio
La memoria automática son las notas que Claude escribe para sí mismo: tus preferencias, correcciones y el contexto del proyecto que no puede derivar del código. La documentación de memoria de Anthropic define su alcance como "Por repositorio, compartido entre worktrees".
La sección de almacenamiento explica por qué. "Cada proyecto obtiene su propio directorio de memoria en ~/.claude/projects/<project>/memory/. La ruta <project> se deriva del repositorio de git, por lo que todos los worktrees y subdirectorios dentro del mismo repositorio comparten un directorio de memoria automática".
Así que una corrección que le des a Claude en una sesión de worktree puede aparecer en la siguiente sesión que inicies en otro worktree del mismo repositorio. Esa es la única capa que cruza los worktrees sin ninguna configuración. Sin embargo, se limita a la máquina: "La memoria automática es local de la máquina. Todos los worktrees y subdirectorios dentro del mismo repositorio de git comparten un directorio de memoria automática. Los archivos no se comparten entre máquinas o entornos en la nube". Nuestra guía sobre por qué Claude Code olvida entre máquinas cubre ese límite.
Debido a que el directorio de memoria vive bajo ~/.claude/projects/, se encuentra fuera del worktree. Eliminar un worktree elimina el directorio y la rama del worktree, lo cual no incluye esa carpeta.
CLAUDE.md: lo que tenga la rama del worktree
CLAUDE.md es un archivo en tu repositorio, por lo que un worktree lee su propia copia. Qué copia depende de dónde comenzó el worktree. La página de worktrees de Anthropic dice que Claude Code "crea una rama a partir de la rama predeterminada de tu repositorio y hace checkout solo de los archivos rastreados".
La base predeterminada es fresh, lo que significa "crear una rama a partir de la rama predeterminada del repositorio en el remoto, generalmente main, de modo que el worktree comience desde un árbol limpio que coincida con el remoto". Si editaste CLAUDE.md en tu checkout principal y no lo has confirmado ni subido, un nuevo worktree no tendrá esa edición. Su CLAUDE.md es el que está en la rama predeterminada remota.
Para crear una rama a partir de tu trabajo actual en su lugar, establece worktree.baseRef en head. La documentación dice que esa opción "creará una rama a partir de tu HEAD local actual, por lo que el worktree llevará tus commits no subidos y el estado de la rama de la función". Los cambios no confirmados no forman parte de ningún commit, por lo que se quedan en el checkout principal.
En las sesiones de worktree iniciadas desde la aplicación de escritorio, la documentación agrega que "los archivos CLAUDE.md y .claude/rules/ aún se cargan desde el worktree", aunque el resto de la configuración del proyecto se lee desde la raíz del checkout principal. Si las diferentes capas comienzan a discrepar, nuestra guía para reconciliar capas de CLAUDE.md en conflicto cubre cómo se combinan.
CLAUDE.local.md: solo en el worktree donde lo creaste
CLAUDE.local.md es para preferencias privadas que no confirmas. Debido a que está ignorado por git, un nuevo worktree no lo obtiene. Anthropic lo dice directamente: "Si trabajas en múltiples worktrees de git del mismo repositorio, un CLAUDE.local.md ignorado por git solo existe en el worktree donde lo creaste".
La solución de la documentación es mover el contenido a tu directorio de inicio e importarlo. Coloca tus instrucciones personales en un archivo como ~/.claude/my-project-instructions.md, luego haz referencia a él con una importación @, como muestra el ejemplo de Anthropic. Cada worktree leerá el mismo archivo desde tu directorio de inicio.
Archivos ignorados por Git y .worktreeinclude
La misma regla se aplica a otros archivos no rastreados. "Un worktree es un checkout limpio, por lo que los archivos no rastreados como .env o .env.local de tu repositorio principal no están presentes".
Para copiarlos, agrega un archivo .worktreeinclude a la raíz del proyecto. Este "utiliza la sintaxis de .gitignore" y "Solo se copian los archivos que coinciden con un patrón y que también están ignorados por git, por lo que los archivos rastreados nunca se duplican". Se aplica a "cada worktree que Claude Code crea con git", incluidos los worktrees de subagentes y las sesiones paralelas en la aplicación de escritorio.
Un patrón en .worktreeinclude copia un archivo una vez, cuando se crea el worktree. Un CLAUDE.local.md o .env copiado es entonces un archivo independiente en cada worktree, y las ediciones en uno no actualizan los demás. Para instrucciones personales que cambias constantemente, la importación desde el directorio de inicio es la opción más estable.
Qué más comparte un worktree con el checkout principal
Anthropic enumera lo que un worktree comparte con el checkout principal:
- El directorio
.gitdel repositorio, por lo que los commits realizados en un worktree van al mismo repositorio. - Plugins instalados a nivel de proyecto desde el checkout principal.
- Aprobaciones de permisos. Elegir permitir siempre un comando de Bash en un worktree "guarda la regla en el archivo
.claude/settings.local.jsondel checkout principal", por lo que se aplica en cada worktree del repositorio. En Windows y en algunos otros casos, la regla se queda en ese worktree. - Habilidades, agentes y comandos no rastreados, cuando el worktree no tiene su propio directorio
.claude/skills. "En un worktree con su propio directorio.claude/skills, solo se carga esa copia".
Las sesiones de worktree de la aplicación de escritorio van más allá. Allí, Claude Code "lee la configuración del proyecto, como ajustes, hooks, habilidades, agentes, comandos y servidores .mcp.json desde la raíz del checkout principal".
Los subagentes en worktrees toman sus instrucciones de la conversación principal
Los subagentes pueden ejecutarse en sus propios worktrees, ya sea a petición o con isolation: worktree en el frontmatter de un subagente personalizado. Sus instrucciones provienen de otro lugar. "Un subagente en su propio worktree toma los archivos de instrucciones con los que comienza de tu conversación principal, no de su worktree".
Y para los worktrees en la ubicación predeterminada, "el subagente tampoco carga el archivo CLAUDE.md ni el directorio .claude/rules/ en la raíz del worktree a medida que lee archivos allí, incluso si estos difieren en la rama del worktree". Si cambias CLAUDE.md en una rama y esperas que un subagente de un worktree lo siga, seguirá la versión de la conversación principal en su lugar.
Las sesiones y transcripciones siguen al worktree
Las conversaciones en sí permanecen en el worktree en el que se ejecutaron. El selector de sesiones muestra "Sesiones del worktree actual" de forma predeterminada, y puedes presionar Ctrl+W para ampliarlo a todos los worktrees del repositorio. Reanudar por nombre funciona en todos los worktrees del repositorio.
Cuando Claude entra o sale de un worktree, "la transcripción lo sigue", por lo que --resume encuentra la sesión en su nuevo directorio. Reanudar una sesión que terminó dentro de un worktree la devuelve allí. Si el worktree fue eliminado, Claude Code se reanuda en el directorio desde el que lo iniciaste y "borra la vinculación del worktree de la sesión". Nuestra guía para encontrar el historial de sesiones de Claude Code cubre el selector con más detalle.
Lo que la gente intenta primero
Editar CLAUDE.md in el checkout principal e iniciar un worktree. El nuevo worktree tiene la versión de la rama predeterminada remota, no la edición sin confirmar.
Esperar CLAUDE.local.md en cada worktree. Existe solo donde lo creaste.
Asumir que los worktrees aíslan la memoria. La memoria automática se comparte entre todos los worktrees del repositorio. Una corrección incorrecta en una sesión puede trasladarse a las demás.
Cambiar CLAUDE.md en una rama para un subagente de worktree. Los subagentes en worktrees de ubicación predeterminada comienzan con los archivos de instrucciones de la conversación principal.
Guardar notas solo en el worktree. Eliminar un worktree borra su directorio, su rama y el trabajo en ellos.
La solución: Coloca cada tipo de contexto donde cada worktree pueda acceder a él
Paso 1: Confirma las instrucciones compartidas e importa las personales desde el directorio de inicio
Cualquier cosa que deba seguir cada sesión va en el CLAUDE.md confirmado, subido a la rama predeterminada, para que los nuevos worktrees comiencen con él. Si necesitas que un worktree recoja cambios de instrucciones no subidos, establece worktree.baseRef en head y confirma el cambio primero.
Mueve las notas personales de CLAUDE.local.md a un archivo en tu directorio de inicio e impórtalo. Un solo archivo, leído por cada worktree, editado en un solo lugar.
Paso 2: Lista los archivos ignorados por git que necesita cada worktree
Agrega un archivo .worktreeinclude en la raíz del proyecto con los archivos ignorados por git sin los cuales una sesión no puede funcionar, como .env y .env.local. Trata las copias como puntos de partida. Si un valor cambia, actualízalo en el checkout principal para que los nuevos worktrees obtengan la nueva versión.
Revisa también la memoria automática de vez en cuando. Dado que cada worktree la comparte, una nota errónea de una sesión afecta a todas. Los archivos de memoria son Markdown simple bajo ~/.claude/projects/<project>/memory/, y puedes editarlos o eliminarlos.
Paso 3: Escribe lo que descubrió una sesión de worktree antes de limpiarla
Cuando finaliza una sesión de worktree, sus conclusiones quedan en su transcripción y posiblemente en la memoria automática. Antes de eliminar el worktree, escribe las decisiones y hallazgos que necesitan las otras sesiones. Las reglas duraderas van a CLAUDE.md. Todo lo demás va a tus propias notas.
Si las sesiones necesitan intercambiar hallazgos mientras se ejecutan, la página de worktrees señala la mensajería entre sesiones, que "permite a Claude pasar hallazgos entre las sesiones en tus worktrees".
Configurando esto en MemoryLake
Los worktrees dividen tu trabajo en checkouts paralelos, y cada capa de contexto maneja esa división de manera diferente. La memoria automática cruza los worktrees pero se detiene en la máquina. CLAUDE.md sigue a la rama. Las notas personales se quedan donde las escribiste.
MemoryLake es una capa de memoria para mantener las decisiones detrás de ese trabajo en una sola lista que tú mantienes, disponible para Claude Code y los otros asistentes que conectes, como Codex y ChatGPT.
Tú mismo escribes las entradas, con tus propias palabras. No se lee, escribe ni elimina nada de tus worktrees, tus archivos CLAUDE.md o CLAUDE.local.md, tu directorio de memoria automática, tus transcripciones de sesiones o el almacenamiento de cualquier proveedor. Guarda los secretos en tus archivos de entorno, no en las entradas de memoria.
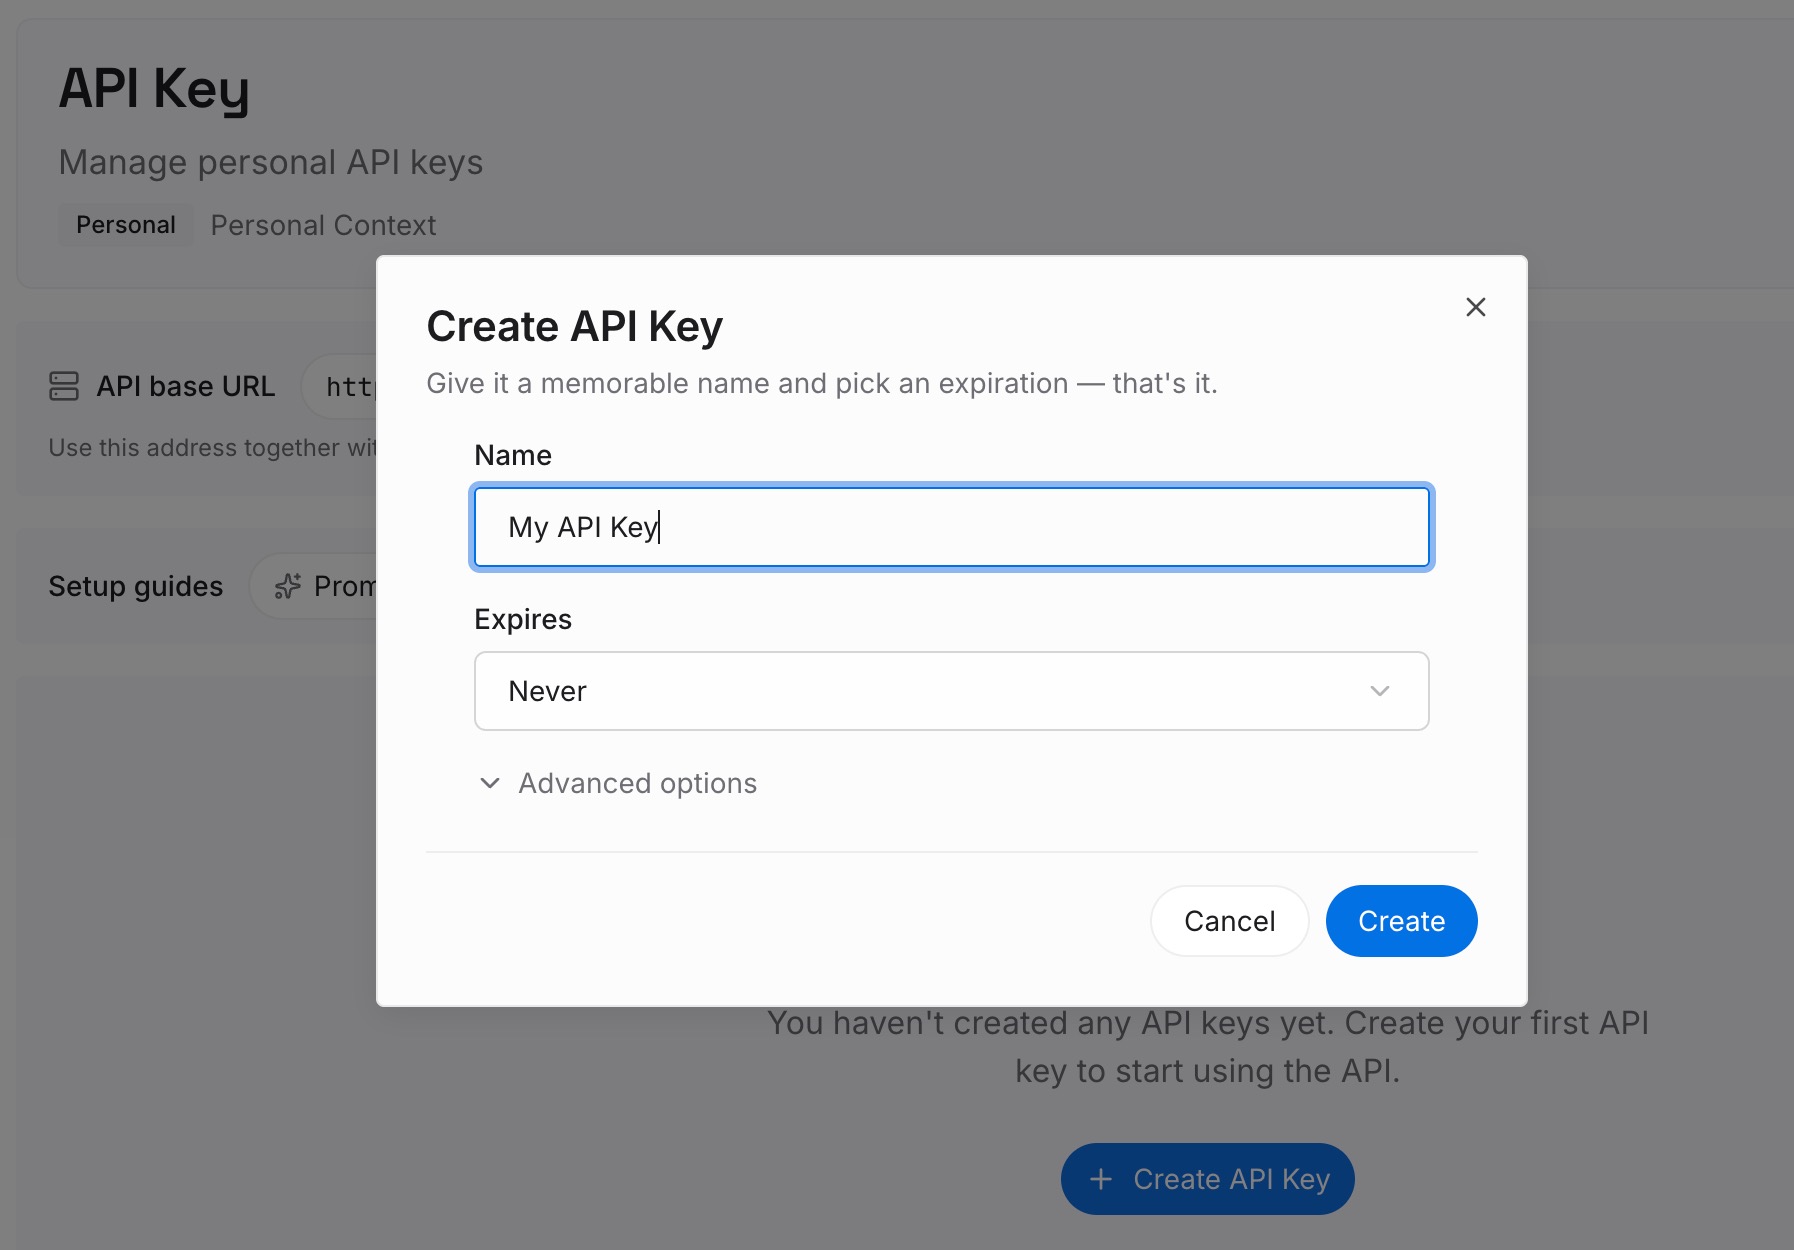
Paso 1: Crea una clave API
Inicia sesión y genera una clave desde el panel de control. La clave pertenece a tu espacio de trabajo de MemoryLake y es independiente de tu cuenta de Claude.
Paso 2: Sube tus primeras memorias
Comienza con lo que escribiste en el Paso 3 de la solución: las decisiones y hallazgos de las sesiones de worktree que estás a punto de limpiar. Un punto por entrada, con fecha y etiquetado con el repositorio y la rama.
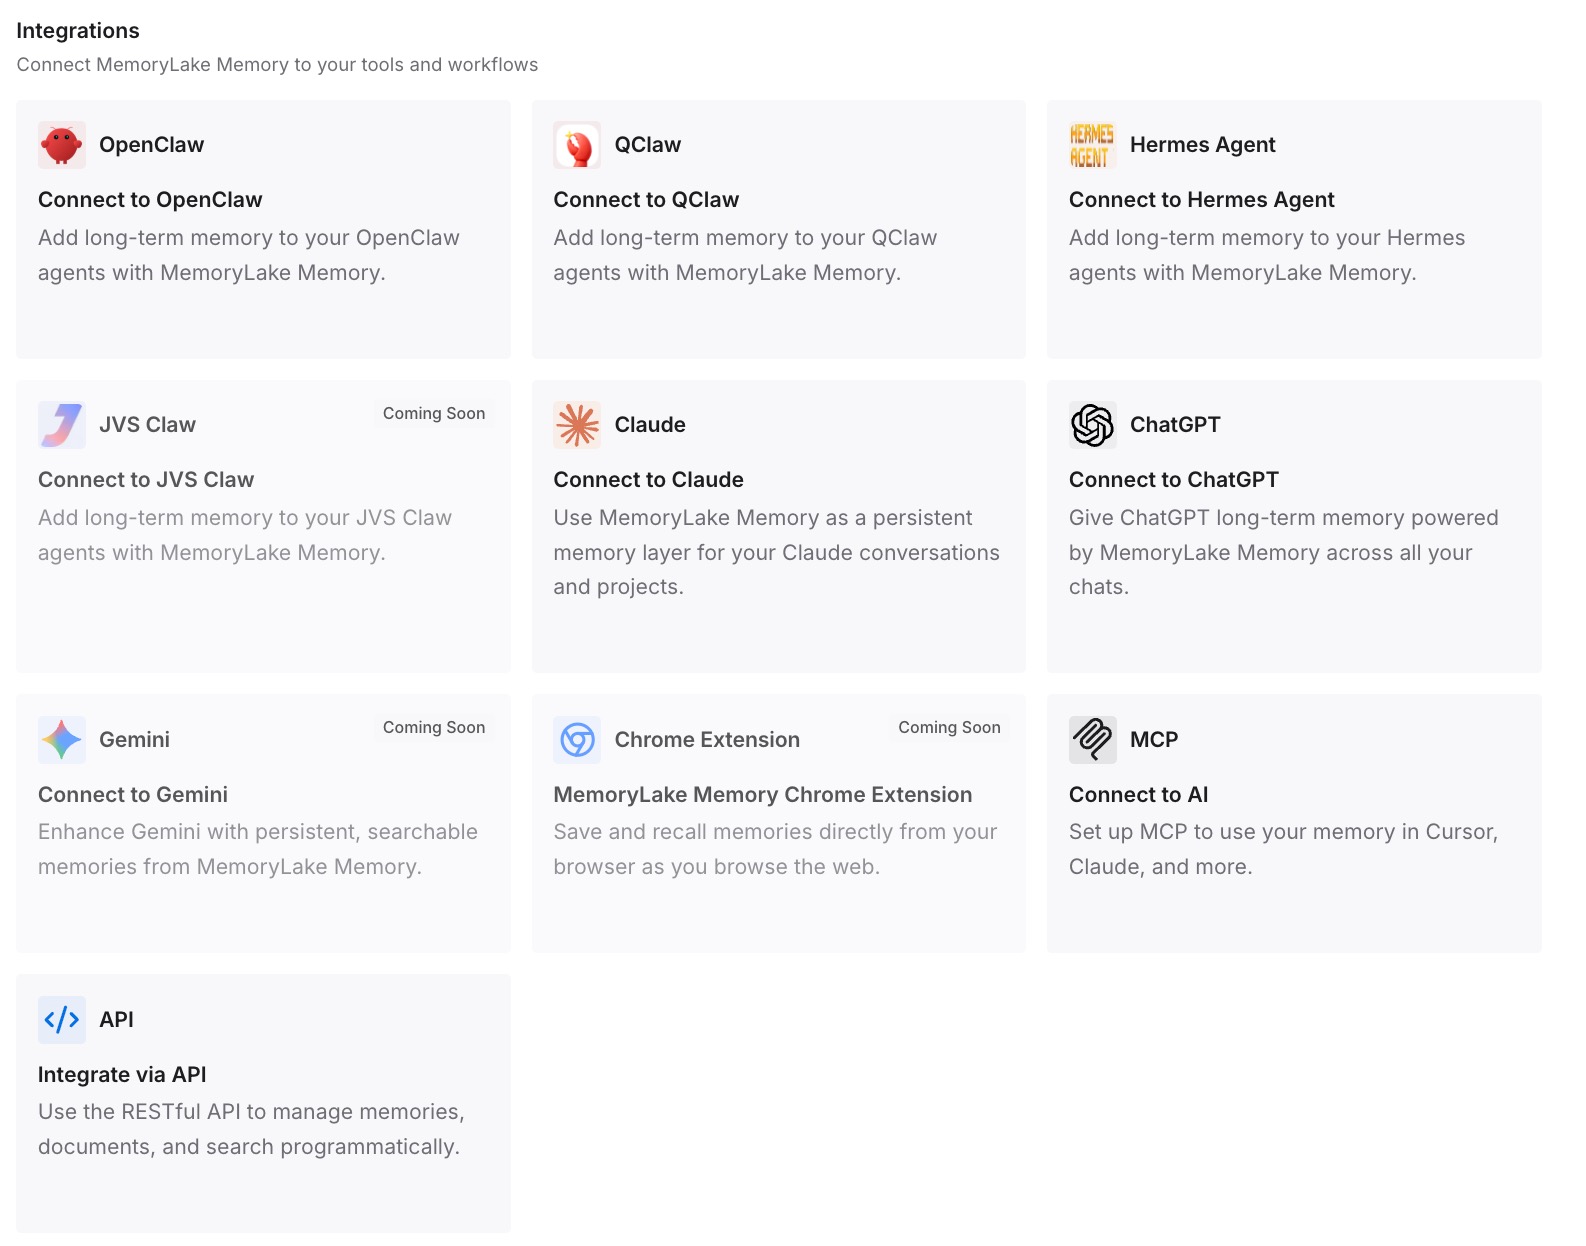
Paso 3: Conecta tu IA y agentes
Conecta Claude Code y los otros asistentes que utilices. Cada nueva sesión de worktree, en esta máquina o en otra, puede comenzar a partir de las mismas decisiones.
Qué cambia esto en la práctica
La primera diferencia es que los nuevos worktrees comienzan con las instrucciones correctas. Las reglas compartidas se confirman, las personales se importan desde el directorio de inicio y los archivos que necesita una sesión se copian.
La segunda es que las sesiones paralelas se mantienen consistentes. Sabes que la memoria automática se comparte, así que la revisas, y sabes qué CLAUDE.md lee cada worktree y subagente.
La tercera es que la limpieza deja de costarte contexto. Las conclusiones de un worktree se escriben antes de eliminar el worktree. Si también ejecutas sesiones en la nube, nuestra guía sobre lo que las sesiones en la nube de Claude Code traen de tu configuración local cubre lo que cruza ese límite.
Mejores prácticas para el contexto en worktrees de Claude Code
Confirma y sube los cambios de instrucciones. Los nuevos worktrees comienzan desde la rama predeterminada remota.
Importa instrucciones personales desde tu directorio de inicio. CLAUDE.local.md se queda en un solo worktree.
Usa .worktreeinclude para archivos de entorno. Solo se copian los archivos ignorados por git que coincidan.
Recuerda que la memoria automática se comparte. Revísala cuando las sesiones comiencen a discrepar.
Espera que los subagentes de worktree usen las instrucciones de la conversación principal. No el CLAUDE.md de la rama.
Agrega .claude/worktrees/ a .gitignore. Anthropic lo recomienda para que el contenido del worktree no aparezca como archivos no rastreados.
Escribe los hallazgos antes de eliminar un worktree. La eliminación borra su directorio y rama.
Conclusión
Los worktrees de Claude Code aíslan las ediciones de archivos, no el contexto. La memoria automática se comparte en cada worktree de un repositorio en la misma máquina. CLAUDE.md proviene del checkout de cada worktree, que por defecto es la rama predeterminada remota. CLAUDE.local.md y otros archivos ignorados por git existen solo donde los creaste, a menos que .worktreeinclude los copie. Los subagentes en worktrees toman sus instrucciones de la conversación principal.
Confirma las instrucciones compartidas, importa las personales desde el directorio de inicio, enumera los archivos que necesita cada worktree y escribe lo que descubrió una sesión antes de limpiarla.