Por qué la sesión se inicia sin tus chats
La documentación de Claude Code comienza su página de memoria con una declaración clara: "Cada sesión de Claude Code comienza con una ventana de contexto nueva. Dos mecanismos transmiten el conocimiento a través de las sesiones". Los nombra:
- "Archivos CLAUDE.md: instrucciones que escribes para darle a Claude un contexto persistente."
- "Memoria automática (auto memory): notas que Claude escribe por sí mismo basándose en tus correcciones y preferencias"
Ambos son archivos. CLAUDE.md reside en tu repositorio o en tu carpeta de inicio, y la memoria automática reside en un directorio de tu computadora. La documentación describe desde dónde se carga cada uno, y ambos lugares están del lado de Claude Code.
La memoria del chat de Claude funciona de manera diferente. El artículo sobre memoria de Anthropic dice: "Claude guarda la memoria como un conjunto de temas individuales a medida que chateas", y describe una memoria compartida entre el chat y Claude Cowork en la nube. La documentación de la memoria de Claude Code describe CLAUDE.md y la memoria automática, y no menciona la carga de la memoria de tu chat o el historial de tu chat en una sesión. Trata a ambos como elementos separados hasta que hayas copiado algo.
Lo mismo ocurre con los proyectos. Claude Code ahora tiene su propia función de Proyectos (Projects) para el trabajo en la nube, y su documentación la separa de la anterior: "Proyectos en el chat de claude.ai y Cowork: la experiencia de Proyectos anterior, que agrupa conversaciones y archivos de referencia sin hilos ni un coordinador". Un proyecto que creaste en el chat es algo diferente de un proyecto en Claude Code.
Lo que sí comparten ambos es tu plan. El artículo de Anthropic sobre el uso de Claude Code con Pro o Max dice: "Estos límites se comparten entre Claude y Claude Code, lo que significa que toda la actividad en ambas herramientas cuenta para los mismos límites".
Dónde va cada parte de un chat en Claude Code
Un chat útil contiene varios tipos de contexto. Cada uno tiene un hogar natural en Claude Code.
Decisiones y convenciones para la base de código
Estas van en el archivo CLAUDE.md del proyecto, en ./CLAUDE.md o ./.claude/CLAUDE.md. La documentación lo describe como "Instrucciones compartidas por el equipo para el proyecto", y los ejemplos que da son "Arquitectura del proyecto, estándares de codificación, flujos de trabajo comunes". Si en tu chat se acordó cómo se manejan los errores, qué biblioteca usar para las fechas o qué significa la estructura de carpetas, ese es material para el CLAUDE.md del proyecto.
El consejo de Anthropic sobre lo que pertenece allí: "Trata a CLAUDE.md como el lugar donde escribes lo que de otro modo tendrías que volver a explicar". Y sobre el tamaño, "intenta mantenerlo por debajo de las 200 líneas por archivo CLAUDE.md".
Tus preferencias personales
Las preferencias que se aplican a todos tus proyectos van en ~/.claude/CLAUDE.md, que la documentación llama "Preferencias personales para todos los proyectos". Las preferencias para un solo proyecto que no deseas confirmar (commit) van en ./CLAUDE.local.md, descrito como "Preferencias personales específicas del proyecto; añadir a .gitignore".
Si la memoria de tu chat sabe que prefieres commits pequeños, o que quieres explicaciones antes del código, aquí es donde va eso.
Información de contexto que Claude no puede obtener del código
Parte de lo que discutiste no aparecerá en el repositorio: por qué rechazaste un enfoque, una fecha límite, quién es el propietario de un servicio. La memoria automática de Claude Code está diseñada para este tipo de notas. La documentación enumera los tipos que guarda, incluyendo "proyecto: trabajo en curso, fechas límite y decisiones que Claude no puede derivar del código o del historial de git".
Puedes indicarle a Claude Code que guarde algo. Cuando le pides que recuerde un dato, lo guarda en la memoria automática. Para poner una instrucción en CLAUDE.md en su lugar, pídelo directamente o edita el archivo tú mismo.
La memoria automática tiene límites que vale la pena conocer antes de confiar en ella:
- "La memoria automática es local de la máquina". Se almacena en
~/.claude/projects/<project>/memory/, y "Los archivos no se comparten entre máquinas o entornos de nube". - "Las primeras 200 líneas de
MEMORY.md, o los primeros 25 KB, lo que ocurra primero, se cargan al inicio de cada conversación". Los archivos de temas se leen cuando Claude los necesita. - "Claude omite cualquier cosa que pueda derivar de la base de código, como la arquitectura, las rutas de archivos o las correcciones de depuración. También omite cualquier cosa que ya digan tus archivos CLAUDE.md".
Por lo tanto, si trabajas en más de una computadora o en sesiones de nube, coloca cualquier cosa importante en CLAUDE.md en lugar de en la memoria automática. Nuestra guía sobre por qué Claude Code olvida entre máquinas cubre esa brecha.
Material de referencia extenso
Las especificaciones, notas de investigación y explicaciones largas de un chat son mejores como archivos en el repositorio, como un documento bajo docs/, en lugar de como contenido de CLAUDE.md. Claude puede leerlos cuando los necesita, y CLAUDE.md puede apuntar a ellos. La documentación dice: "Los archivos CLAUDE.md pueden importar archivos adicionales utilizando la sintaxis @path/to/import", y esos archivos se cargan al inicio junto con el CLAUDE.md que los importa, así que importa solo lo que cada sesión necesite.
Si usas worktrees, otras computadoras o sesiones en la nube
El lugar donde ejecutas Claude Code cambia cuáles de estos archivos ve una sesión. El CLAUDE.md del proyecto viaja con el repositorio, por lo que cada clon y cada worktree lo tiene. La memoria automática se comparte dentro de un repositorio en una computadora: "Todos los worktrees y subdirectorios dentro del mismo repositorio de git comparten un directorio de memoria automática".
CLAUDE.local.md es el que suele confundir a la gente. La documentación señala que "un CLAUDE.local.md ignorado en git solo existe en el worktree donde lo creaste". Si trabajas en varios worktrees, mantén las instrucciones personales en tu archivo de usuario. Nuestra guía sobre lo que carga cada sesión de worktree de Claude Code cubre los detalles.
Si tu repositorio ya utiliza AGENTS.md para otras herramientas de programación, Claude Code puede leerlo. Nuestra guía para mover CLAUDE.md a AGENTS.md explica cómo funcionan juntos ambos archivos.
Lo que la gente intenta primero
Pegar un chat completo en el primer mensaje. Esa sesión tendrá el contexto. La siguiente comenzará con una ventana de contexto nueva, y lo pegado solo quedará en la transcripción antigua.
Pedirle a Claude Code que busque en tu memoria de Claude. Su memoria documentada es CLAUDE.md y la memoria automática. Copia lo que necesites en uno de ellos.
Copiar toda la exportación de memoria en CLAUDE.md. CLAUDE.md se carga en cada sesión, y Anthropic sugiere mantener cada archivo por debajo de las 200 líneas. Mueve solo lo que el repositorio necesite.
Esperar a que la memoria automática lo detecte. La documentación dice: "Claude no guarda algo en cada sesión. Decide qué vale la pena recordar basándose en si la información sería útil en una conversación futura". Si una decisión es importante, escríbela en CLAUDE.md o pídele a Claude que la recuerde.
Tratar a CLAUDE.md como reglas que Claude debe obedecer. Anthropic dice: "Claude los trata como contexto, no como una configuración obligatoria". Las instrucciones específicas y cortas se siguen de manera más consistente que las largas.
Buscar un proyecto de chat en los Proyectos de Claude Code. Son funciones diferentes. Reconstruye lo que necesites a partir de las instrucciones y archivos del proyecto.
La migración manual
Paso 1: Extraer el contexto del chat de Claude
Comienza con las conversaciones en las que todavía confías. Abre cada una y escribe un breve resumen de lo que estableció: la decisión, el motivo y cualquier restricción. Puedes pedirle a Claude en ese chat que redacte el resumen, y luego editarlo para que diga lo que realmente acordaron.
Luego exporta lo que Claude ha guardado sobre ti. El artículo sobre exportación de memoria ofrece una instrucción (prompt) para usar en un chat: "Escribe mis recuerdos textualmente, tal como aparecen en tu memoria". Guarda el resultado en un archivo de texto. También puedes leer tu memoria en Configuración > Memoria, donde Anthropic dice: "Todo lo que Claude recuerda se enumera bajo Temas".
Para obtener una copia completa de tu historial, utiliza la exportación de datos. Anthropic dice: "Los usuarios individuales de Claude pueden exportar la información del usuario y el historial de chat desde Configuración > Privacidad en la aplicación web o Claude Desktop. No es posible realizar una exportación desde Claude para iOS o Android". El enlace de descarga llega por correo electrónico y "caducará 24 horas después de la entrega". Nuestra guía para leer tu exportación de datos de Claude cubre lo que hay dentro.
Si el trabajo estaba en un proyecto de chat, copia las instrucciones del proyecto en un archivo de texto y asegúrate de tener los archivos de conocimiento.
Paso 2: Colocar cada pieza donde Claude Code la lee
Revisa tus resúmenes y clasifica cada punto:
- Se aplica a la base de código y al equipo: agrégalo al CLAUDE.md del proyecto. Mantén cada línea corta y específica.
- Se aplica a ti en todas partes: agrégalo a
~/.claude/CLAUDE.md. - Se aplica a ti solo en este repositorio: agrégalo a
./CLAUDE.local.md. - Información de contexto que Claude no puede derivar del código: pídele a Claude Code que la recuerde, o agrégala a CLAUDE.md si la necesitas en cada máquina.
- Material de referencia extenso: confírmalo (commit) como un documento y apunta a él desde CLAUDE.md.
Omite lo que Claude pueda leer del código. Luego inicia una nueva sesión y ejecuta /memory. La documentación dice que "enumera las ubicaciones de tus archivos CLAUDE.md, CLAUDE.local.md y otros archivos de memoria en los ámbitos de usuario y de proyecto". Pregúntale a Claude qué sabe sobre una decisión que moviste y verifica que la respuesta coincida.
La mejor manera: Mantener las decisiones de tus chats en una sola lista que ambos lados puedan usar
La migración manual funciona para un traslado único. El problema es que no se mantiene actualizada. Seguirás analizando cosas en el chat, porque ahí es más fácil pensar en voz alta, y cada nueva decisión tendrá que copiarse en el repositorio nuevamente. Mientras tanto, la memoria automática se queda en una sola computadora y la memoria del chat permanece en tu cuenta.
MemoryLake es una capa de memoria para mantener esas decisiones en una sola lista que tú administras, disponible para Claude Code y los demás asistentes que conectes, como ChatGPT y Codex.
Tú mismo escribes las entradas, con tus propias palabras. No se lee, escribe ni elimina nada de tus chats de Claude, tu memoria de Claude, tus archivos CLAUDE.md, tu carpeta de memoria automática ni del almacenamiento de ningún proveedor. Para repositorios de trabajo, sigue la política de tu organización sobre lo que guardas fuera de ellos.
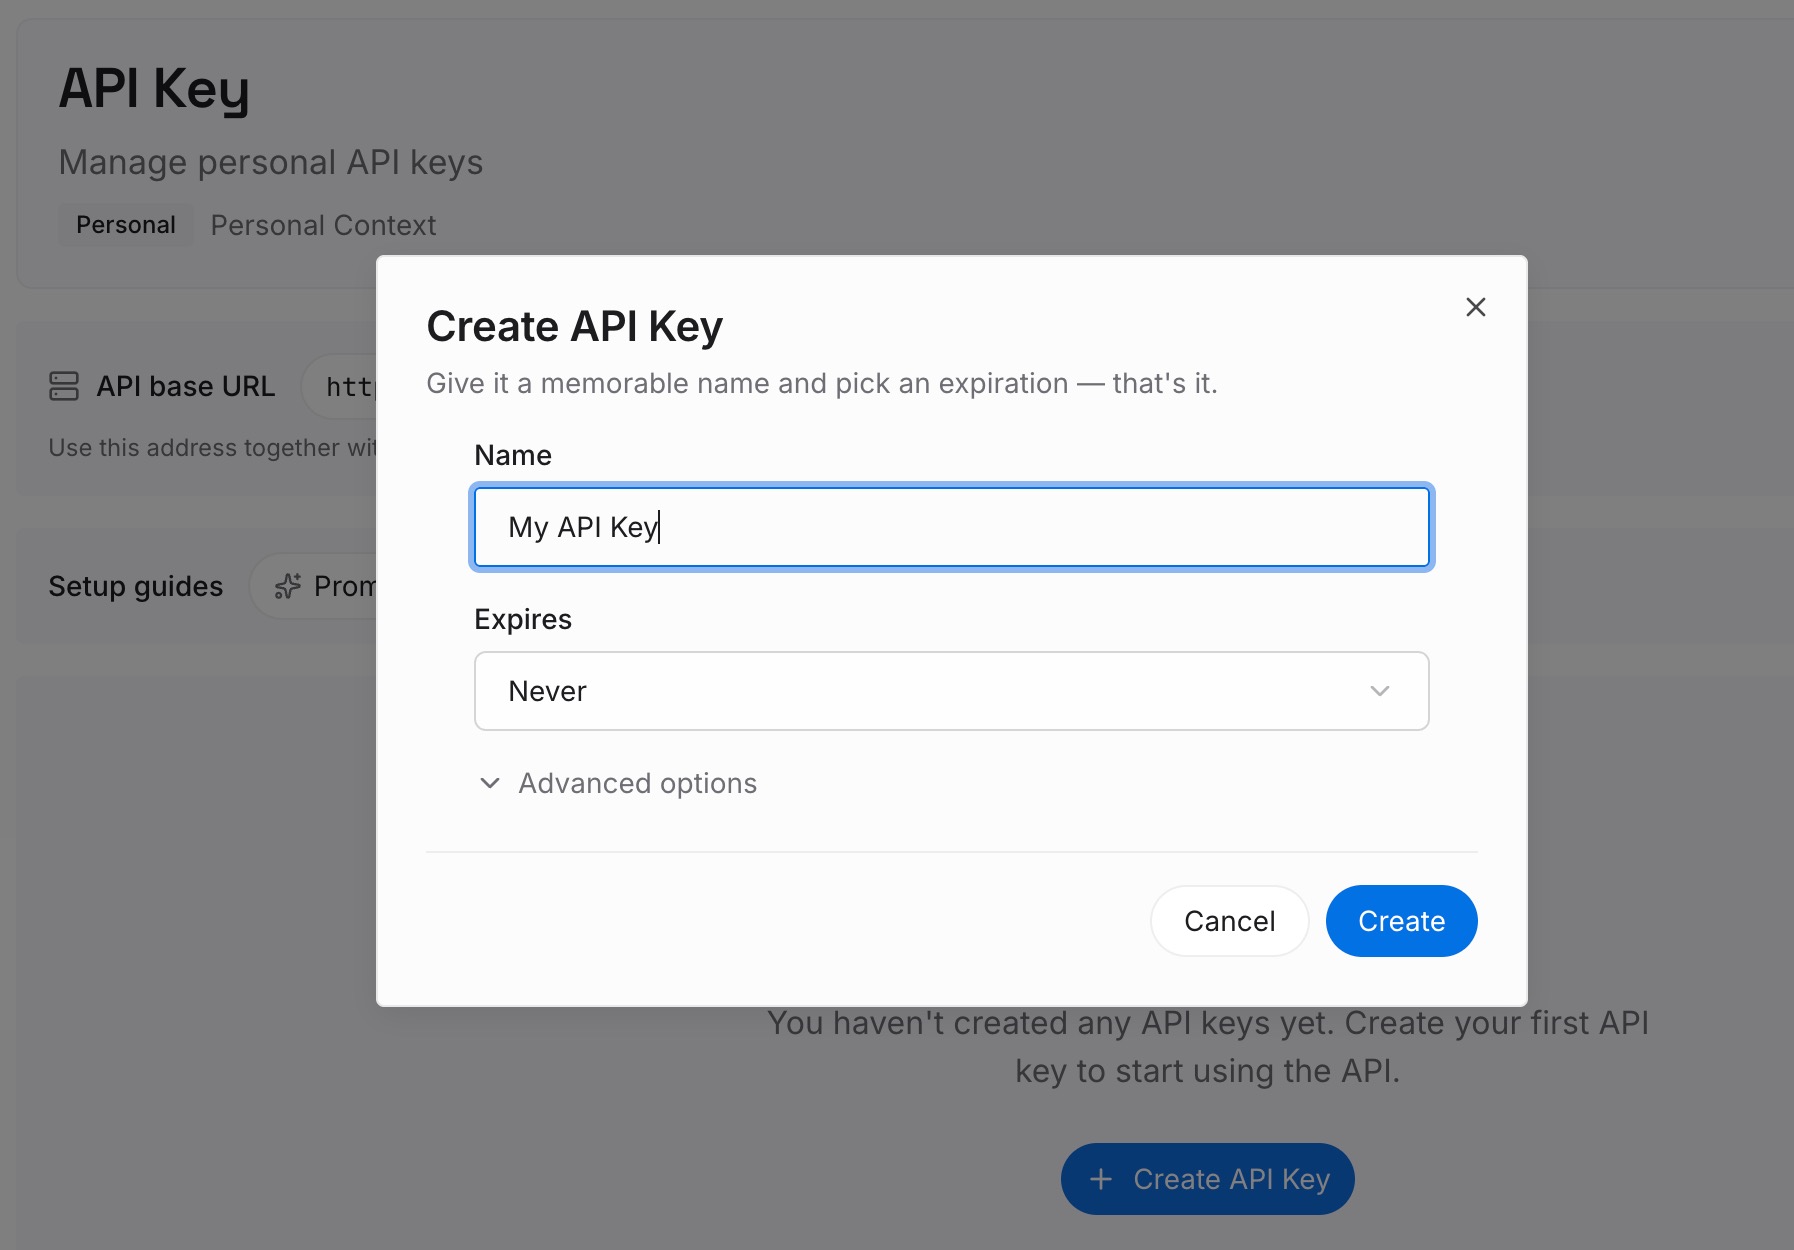
Paso 1: Crear una clave API
Inicia sesión y genera una clave desde el panel de control. La clave pertenece a tu espacio de trabajo de MemoryLake y es independiente de tu cuenta de Claude.
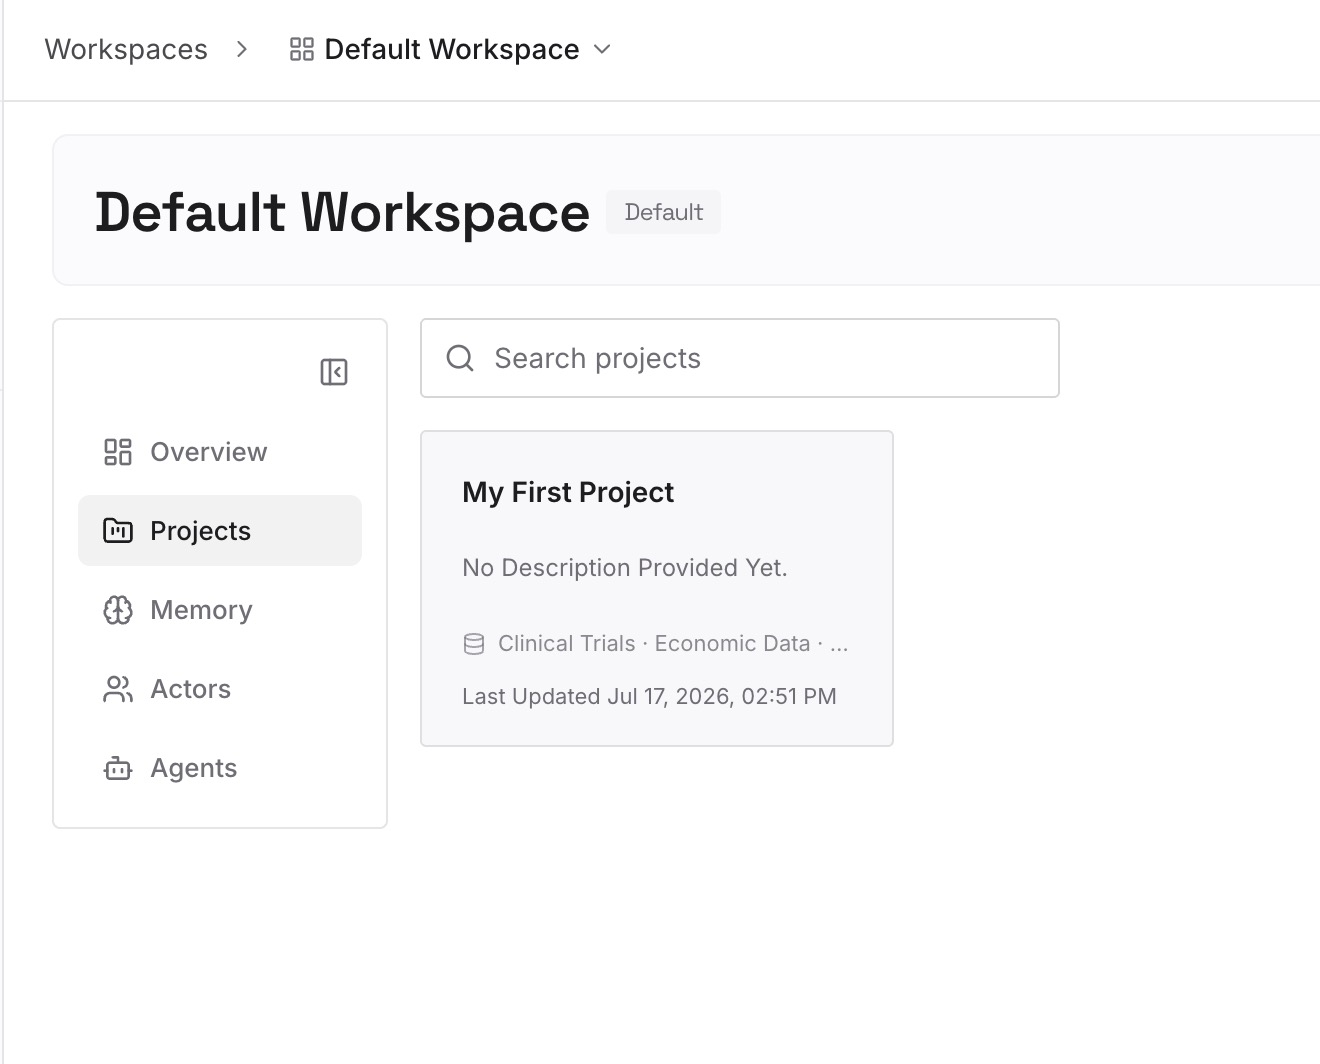
Paso 2: Subir tus primeras memorias
Comienza con los resúmenes del Paso 1 de la migración manual: las decisiones, restricciones y convenciones que definieron tus chats. Un punto por entrada, con fecha y etiquetado con el repositorio al que se aplica.
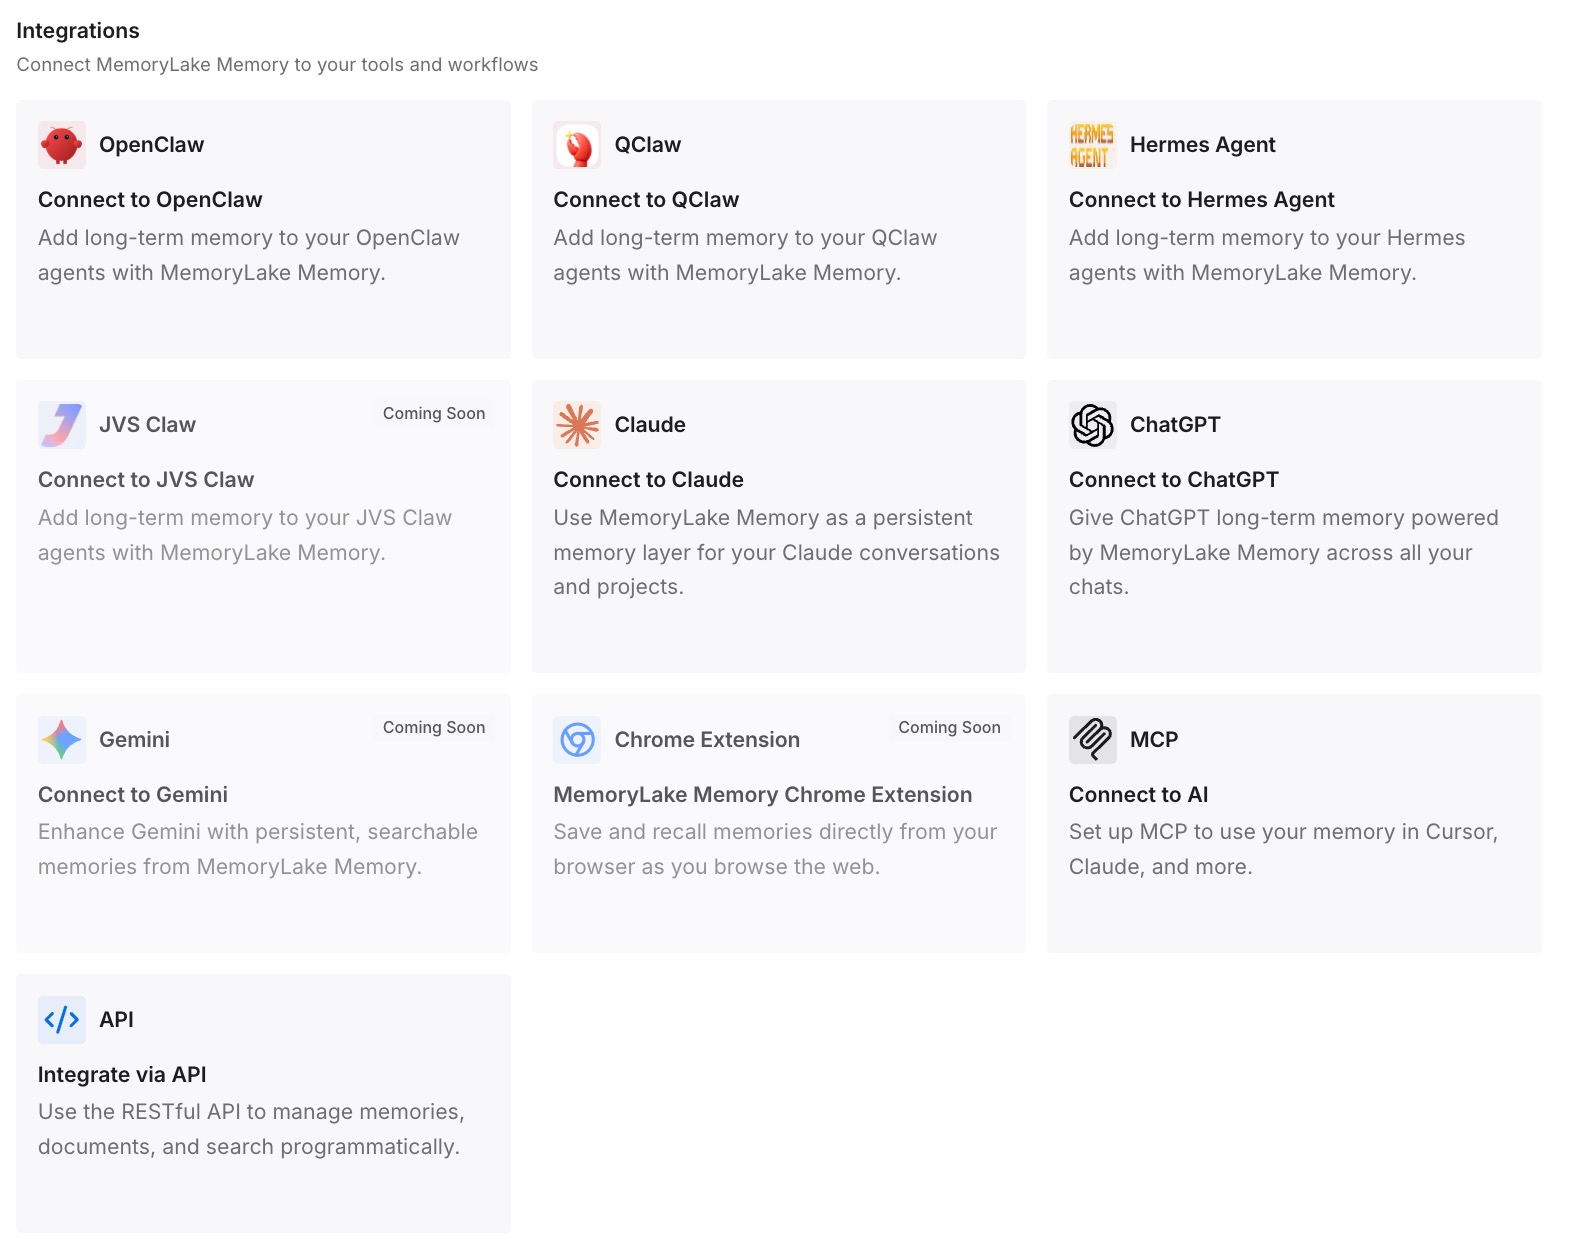
Paso 3: Conectar tu IA y agentes
Conecta Claude Code y los demás asistentes que utilices. Las mismas entradas estarán disponibles en cada computadora en la que ejecutes Claude Code y en las otras herramientas que conectes.
Qué cambia esto en la práctica
La primera diferencia es que tu primera sesión de Claude Code en un repositorio sabe lo que decidiste en el chat. La arquitectura, las convenciones y las restricciones están ahí, no hay que volver a descubrirlas.
La segunda es que sabes qué archivo contiene cada cosa. Las reglas del equipo están en el CLAUDE.md del proyecto, tus preferencias están en tu archivo de usuario y el contexto de fondo está en la memoria automática o en tu propia lista.
La tercera es que la próxima decisión en el chat no se queda aislada. La agregas una vez y estará allí la próxima vez que abras el repositorio.
Buenas prácticas para mover el trabajo del chat de Claude a Claude Code
Resume la conversación antes de moverla. Una decisión y su motivo son más útiles que una transcripción.
Coloca las reglas del equipo en el CLAUDE.md del proyecto. Se comparte a través del control de versiones.
Coloca las preferencias personales en tu archivo de usuario. ~/.claude/CLAUDE.md se aplica a todos tus proyectos.
Usa CLAUDE.local.md para preferencias no confirmadas (uncommitted). Agrégalo a .gitignore.
No confíes en la memoria automática entre computadoras. Es local de la máquina. Nuestra guía sobre por qué Claude Code olvida el contexto del proyecto cubre otras brechas.
Mantén CLAUDE.md corto. Anthropic sugiere menos de 200 líneas por archivo.
Verifica con /memory después del traslado. Confirma que los archivos que esperas estén en la lista.
Conclusión
El chat de Claude y Claude Code comparten una cuenta y un plan, pero guardan el contexto en lugares diferentes. El chat guarda la memoria en tu cuenta. Claude Code lee los archivos CLAUDE.md y su propia memoria automática, y cada sesión comienza con una ventana de contexto nueva.
Para mover tus chats, resume lo que establecieron, exporta tu memoria y coloca cada punto donde Claude Code lo lee: las reglas del equipo en el CLAUDE.md del proyecto, las preferencias en tu archivo de usuario y el contexto de fondo en la memoria automática o en un archivo que confirmes (commit). Verifica el resultado con /memory.