
Qué publicó Perplexity
El artículo, "Building shared workspaces for people and agents" (Construyendo espacios de trabajo compartidos para personas y agentes), parte del producto. Los Projects son el lugar donde "las personas y los agentes trabajan juntos en tareas de larga duración en Perplexity Computer", y "Cada proyecto se asienta sobre un espacio de trabajo compartido con un sistema de archivos que acumula contexto a lo largo de las sesiones, los agentes y los usuarios".
A continuación, nombra tres requisitos para ese espacio de trabajo:
- Persistencia: "El trabajo debe ser duradero más allá de cualquier sesión de agente o sandbox individual, de modo que el trabajo futuro pueda ser continuado por el mismo usuario o agente y aprovechado por cualquier colaborador".
- Concurrencia: "Múltiples usuarios en el mismo proyecto pueden tener cada uno múltiples agentes realizando ediciones en paralelo que avancen un estado compartido en lugar de sobrescribirse entre sí".
- Trazabilidad: "Tanto los usuarios como los agentes deben poder ver el historial para comprobar quién cambió qué desde su última sesión sin tener que volver a leer todo el proyecto, y revertir las ediciones cuando sea necesario".
Git ya resuelve esos problemas para los equipos de software, por lo que Perplexity se basó en él. "Cada proyecto de Computer está respaldado por un repositorio Git servido por 5 componentes": una pequeña herramienta de línea de comandos dentro del sandbox de cada agente, un plano de control, un servicio de Git, almacenamiento en AWS S3 y un paso de procesamiento posterior que extrae texto de los documentos.
El artículo también señala que los agentes no necesitan "pantallas de revisión, gestión de ramas ni notificaciones". El repositorio es un estado compartido, no una herramienta de revisión de código.
Qué contiene el repositorio
El repositorio contiene los archivos de tu proyecto. El centro de ayuda de Perplexity describe un Project como el lugar que mantiene unidos "tus búsquedas, tareas de Perplexity Computer, archivos, instrucciones y herramientas conectadas", y los archivos son lo que almacena la capa de Git. Computer puede crearlos y actualizarlos en tu nombre, y los miembros del proyecto con acceso de edición pueden subirlos y eliminarlos.
Cada agente trabaja en su propia copia. "Cada agente tiene su propio sandbox aislado". Dentro de él, el agente trabaja con una copia local (checkout), y "Por cada unidad de trabajo significativo realizada por el agente, este envía los cambios como un commit". Dado que los sandboxes son temporales y el almacenamiento no lo es, un fallo cuesta poco: "Si un sandbox falla, solo corre peligro el trabajo que no se haya enviado".
Dos agentes pueden editar a la vez. El servicio de Git rastrea el último commit aceptado y, "Cuando recibe un envío, lo acepta solo si se construyó sobre esa cabecera (head)". Si otro agente llegó primero, el rezagado recibe una respuesta de base obsoleta (stale-base) y tiene que "aplicar de nuevo su cambio sobre la nueva cabecera y volver a enviarlo". El resumen de Perplexity: "Este diseño garantiza que los agentes concurrentes no se sobrescriban silenciosamente entre sí".
Los agentes también leen el proyecto de la misma forma en que lo haría un desarrollador. "Los agentes exploran la versión del repositorio cargada en el sandbox utilizando herramientas estándar del sistema de archivos", listando carpetas y buscando en el contenido de los archivos en lugar de ejecutar un pipeline de recuperación fijo. Esto tiene una consecuencia práctica para ti: un archivo con un nombre claro y un encabezado preciso es más fácil de encontrar para un agente que ese mismo dato enterrado en una sesión larga.
El centro de ayuda establece el tamaño del espacio. "Cada Project admite hasta 10,000 archivos y 5 GB de almacenamiento total, con un tamaño máximo de archivo de 100 MB". Es posible que los Projects creados antes de agosto de 2026 ya superen ese límite de almacenamiento; seguirán funcionando, pero no podrás subir nuevos archivos a ellos.
Qué conserva el historial
Cada cambio aceptado queda registrado. "Por cada escritura aceptada, añade una entrada a una bandeja de salida (outbox), un registro que enumera el repositorio, el nuevo commit, el usuario que realizó el cambio y las rutas que cambiaron". Esa es la trazabilidad en la práctica: quién cambió qué.
Sin embargo, el historial no es ilimitado. Perplexity es directo al respecto: "La compactación mantiene disponible el historial reciente al tiempo que limita el tamaño del repositorio". Tras un envío, el servicio de Git comprueba si el repositorio necesita compactarse y, "Si el número de commits retenidos supera un umbral, el servicio de Git conserva solo un conjunto más pequeño de los commits más recientes. El historial más antiguo se reemplaza con una única instantánea (snapshot) inicial, y los commits recientes se vuelven a aplicar para actualizar los identificadores de commit".
Los archivos en sí no se ven afectados por esto. El diagrama del artículo señala que "la nueva cabecera conserva los mismos archivos". Lo que cambia es qué tan atrás puedes mirar. Más allá de la ventana de retención, el registro paso a paso de quién cambió qué archivo se unifica en una instantánea. El artículo no publica cuál es ese umbral.
También hay una diferencia entre la infraestructura y la interfaz. El artículo describe el historial como algo que los usuarios deberían poder ver y revertir. Los artículos del centro de ayuda de Perplexity sobre los Projects describen archivos, límites, uso compartido y Brain, pero no mencionan una vista de historial de versiones ni un botón de restauración para los archivos del proyecto. Hasta que se documente alguno, trata el historial como un mecanismo de seguridad de Perplexity en lugar de un archivo que puedas explorar.
La lectura práctica: el repositorio es un lugar confiable para los archivos actuales, y el historial es una protección a corto plazo. El registro de por qué tu equipo tomó una decisión debe estar en un archivo, no en el registro de commits. Para el caso general de la memoria con versiones, consulta por qué cada cambio en la memoria de IA necesita un historial.
Qué queda fuera del repositorio
Aquí es donde el enfoque de Git puede resultar engañoso. Varios tipos de contexto que dan forma a las respuestas de Computer en un Project no son archivos del proyecto en absoluto.
Texto extraído de tus documentos
Cuando añades un PDF o un archivo de Office, un analizador en segundo plano extrae su texto. "Los resultados analizados viven fuera del repositorio, en un almacén indexado por el hash del documento de origen. Estos artefactos nunca se confirman (commit) de vuelta al repositorio". Los agentes reciben el texto extraído junto con la copia local, y "Para documentos como los PDF, el agente lee primero el texto extraído y solo descarga los archivos de origen cuando es necesario".
El artículo añade que "El análisis se realiza de forma asíncrona", en segundo plano y no durante la copia local del agente. Si Computer parece pasar por alto algo en un documento grande, nuestra guía sobre por qué Perplexity olvida los archivos subidos cubre las causas habituales.
Memoria de Brain
Brain es la parte que la gente suele asumir que se almacena con el proyecto. El artículo dice lo contrario: "Perplexity Brain, la wiki de conocimiento de Computer, almacena la memoria en repositorios de conocimiento con su propio historial y políticas. Mantener el conocimiento separado de los archivos del proyecto significa que las actualizaciones de memoria en segundo plano no compiten con las ediciones de esos archivos. Una sesión que necesita ambos carga ambos repositorios".
Por lo tanto, la memoria de un Project y los archivos de un Project son dos almacenes que se cargan juntos. Los agentes en segundo plano mantienen el lado de la memoria: "leen el conocimiento existente, incorporan nueva información y guardan las páginas actualizadas como commits".
El centro de ayuda describe Brain en dos contextos, y vale la pena mantenerlos separados. A nivel de cuenta, Brain "se está implementando en Research Preview para suscriptores de Max y Enterprise Max que usan Computer", y "Brain solo aprende de tu propia actividad: nunca extrae datos de nadie más e ignora por completo las sesiones de incógnito". Dentro de un Project, el artículo sobre la memoria de Perplexity describe una capa compartida: "todos en el proyecto ven el mismo Brain. Es una wiki: los colaboradores pueden editarla, los lectores pueden leerla y el propietario del proyecto controla el interruptor de la memoria". Añade que "Brain está disponible únicamente en sesiones de Computer. Search no accede a Brain".
De esto se derivan dos consecuencias. Las entradas de Brain se pueden editar, lo cual es positivo, y "Cada entrada incluye un enlace a su origen, para que puedas verificarla o corregirla". And porque Brain sigue "marcando lo que está obsoleto" en cada ejecución, es un modelo de trabajo que cambia, no un registro fijo. La facturación sigue al propietario: "Las actualizaciones automáticas de Brain consumen los créditos del propietario del Project".
Memoria personal
Tu propia memoria es un tercer almacén, y el hecho de que se aplique en un Project depende de una configuración. El artículo sobre Projects describe un control exclusivo para el propietario, Use session creator's memory (Usar la memoria del creador de la sesión), que decide si las consultas pueden "nutrirse de la memoria personal de la persona que inició la sesión". El artículo sobre la memoria detalla el efecto: "Cuando está activado, cada sesión en el proyecto también se nutre de la memoria personal de quien haya iniciado esa sesión. Cuando está desactivado, las sesiones en el proyecto solo usan el Brain compartido".
Cómo se desarrolla esto depende del plan. En cuentas personales, "Una vez que un Project tiene otros miembros, no puede usar la memoria personal de los miembros". En planes Enterprise, "La memoria personal se puede usar en Projects compartidos a menos que la configuración de memoria de tu organización no lo permita". Allí, dos compañeros de equipo que hagan la misma pregunta en el mismo Project pueden obtener contextos diferentes, dependiendo de quién haya iniciado la sesión.
El artículo sobre la memoria en Enterprise describe esto con una redacción diferente, una opción Reference personal sessions in this project (Hacer referencia a sesiones personales en este proyecto), y señala que las memorias registradas dentro de un Project están "limitadas a ese Project: no se transfieren a tu memoria global". Si estás en Enterprise, comprueba qué control muestra la configuración de tu Project.
Archivos de conectores
Los archivos que importas desde una aplicación conectada no permanecen vinculados al original. "Los archivos que añades desde una fuente conectada son copias únicas. Si actualizas o eliminas el original en la aplicación conectada, la copia en tu Project no cambia". El centro de ayuda sugiere pedirle a Perplexity que obtenga la última versión a través del conector, o volver a añadir el archivo.
Lo que la gente asume en su lugar
Asumir que el historial es un archivo completo. La compactación unifica los commits más antiguos en una sola instantánea. Los archivos actuales sobreviven; el registro a largo plazo de quién cambió qué, no.
Asumir que Brain reside en los archivos del proyecto. Es un repositorio de conocimiento independiente que se carga junto a ellos.
Asumir que todos en un Project compartido obtienen la misma respuesta. En Enterprise, con la memoria del creador de la sesión activada, cada sesión puede nutrirse de la memoria de una persona diferente.
Asumir que un conector mantiene los archivos actualizados. Los archivos de los conectores son copias que se realizan una sola vez.
La solución: Mantener las decisiones en archivos, comprobar qué contiene Brain y actualizar lo copiado
Paso 1: Guarda las decisiones en las que confía tu equipo en los archivos del proyecto
Si algo debe seguir siendo válido para todos en el Project, escríbelo en un archivo dentro del Project en lugar de dejarlo en una sesión. Mantén un archivo breve de decisiones: qué se decidió, cuándo, quién lo hizo y por qué. Escríbelo en Markdown simple con un nombre claro, para que un agente que busque en la carpeta pueda encontrarlo.
Utiliza las instrucciones del Project para definir cómo debe trabajar Computer, no para los hallazgos. El centro de ayuda permite instrucciones de "hasta 8,000 caracteres" y sugiere usos como "un formato de respuesta preferido o un archivo de estado para mantener actualizado". Un archivo de estado es exactamente el tipo de elemento que pertenece al repositorio.
Paso 2: Comprueba qué aportan Brain y la memoria personal al Project
Si tu plan incluye Brain, abre la pestaña Brain, o Fuentes > Brain en el nuevo diseño, y lee lo que contiene actualmente. Corrige cualquier error; el centro de ayuda indica que tus correcciones se aplicarán en la siguiente ejecución. Luego, comprueba la configuración de Memory del Project: ¿se está actualizando Brain de forma automática o manual? ¿Está activada la memoria del creador de la sesión?
En Enterprise, si el Project es compartido y las respuestas deben ser consistentes en todo el equipo, considera desactivar la memoria del creador de la sesión, de modo que cada sesión trabaje a partir del mismo Brain compartido y los mismos archivos. Esa es una decisión de criterio. La memoria personal puede ser útil en un Project que utilizas principalmente a solas.
Paso 3: Actualiza las copias de los conectores y mantén el registro del porqué fuera del historial de commits
Enumera los archivos de tu Project que provienen de conectores y decide cuáles deben mantenerse actualizados. Vuelve a añadirlos cuando el origen cambie, o pídele a Perplexity que obtenga la última versión antes de confiar en ellos.
Luego, guarda el razonamiento detrás de las decisiones importantes en un lugar que no dependa de una ventana de retención de commits. Tu archivo de decisiones cumple esta función dentro del Project. Para el contexto que deseas compartir entre varios Projects y herramientas, es mejor utilizar un almacén independiente. Si estás consolidando trabajo antiguo de Perplexity al mismo tiempo, nuestra guía para mover el historial de chat de Perplexity muestra cómo exportarlo.
Configuración en MemoryLake
Los archivos, el historial y el Brain de un Project viven dentro de Perplexity, y cada Project es su propio espacio. Las decisiones que sobreviven a un solo Project necesitan un hogar propio. MemoryLake es una capa de memoria para mantenerlas en una única lista gestionada por ti, disponible para Perplexity y tus otros asistentes.
Tú mismo escribes las entradas, con tus propias palabras. No se lee, escribe ni elimina nada de tus Projects de Perplexity, Brain, memoria personal o el almacén de cualquier otro proveedor. Si tu Project contiene trabajo de clientes o de la empresa, consulta la política de tu organización antes de copiar detalles en cualquier otro lugar.
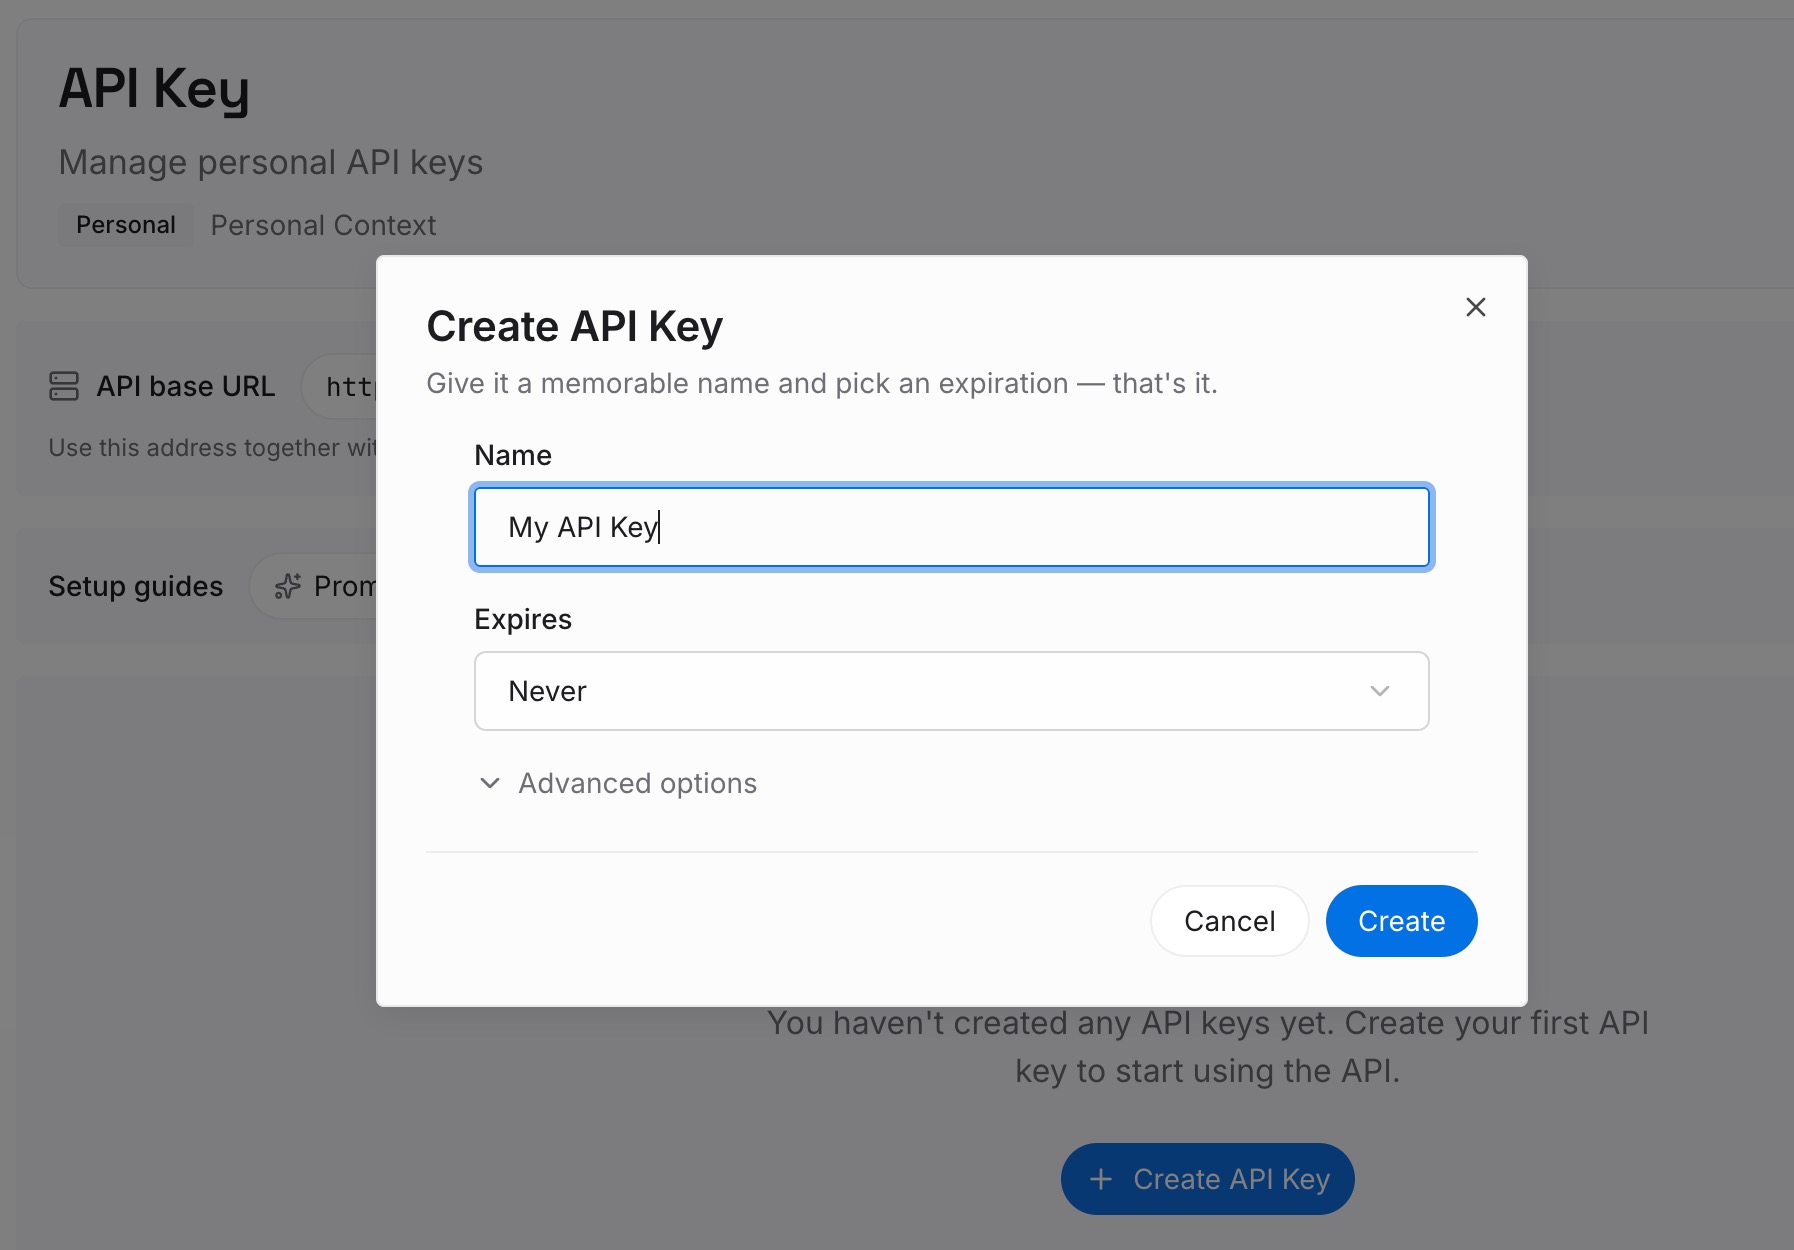
Paso 1: Crea una clave API
Inicia sesión y genera una clave desde el panel de control. La clave pertenece a tu espacio de trabajo de MemoryLake y es independiente de tu cuenta de Perplexity.
Paso 2: Sube tus primeras memorias
Comienza con el archivo de decisiones de tu Project. Una decisión por entrada, con fecha, el motivo y el Project del que proviene.
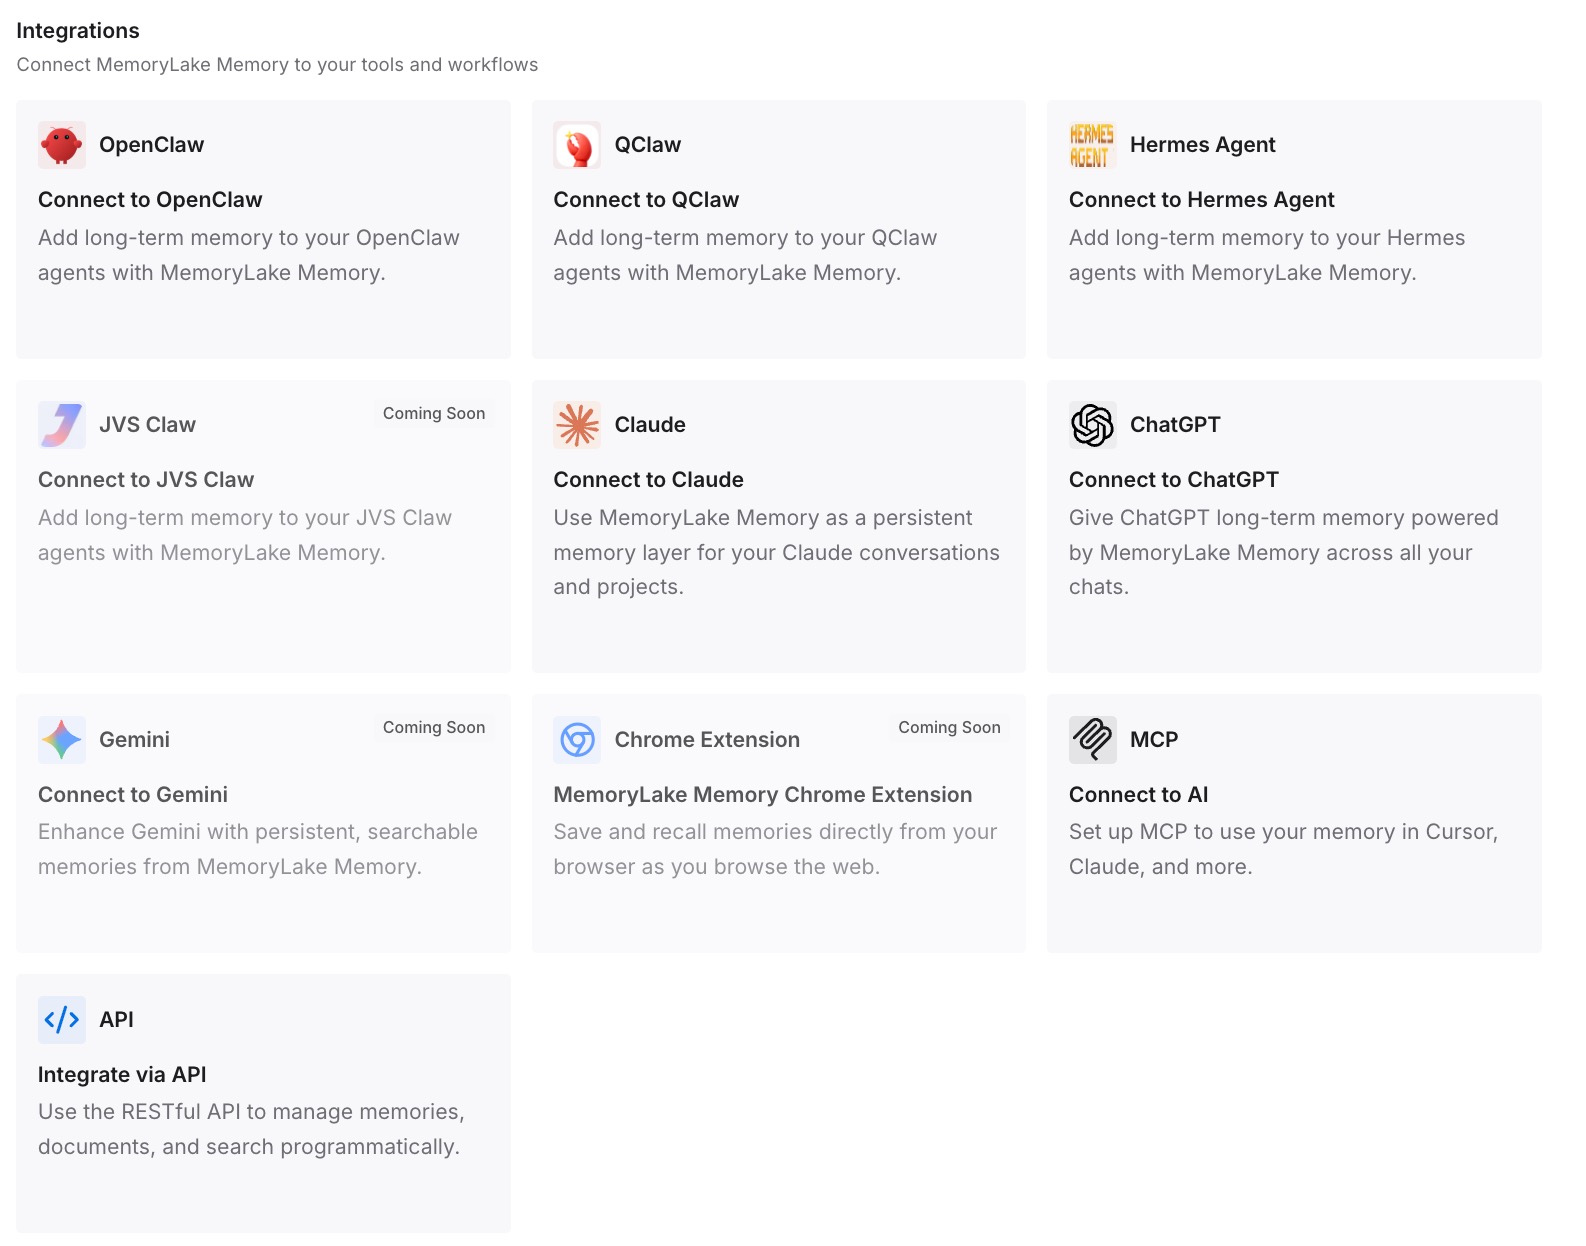
Paso 3: Conecta tu IA y agentes
Conecta los asistentes que utilizas. Las mismas decisiones estarán disponibles en un nuevo Project de Perplexity, o en otra herramienta, sin depender del Brain o del historial de un solo Project.
Qué cambia esto en la práctica
La primera diferencia es saber en qué puedes confiar. Los archivos actuales en un Project son duraderos y están protegidos contra sobrescrituras silenciosas. El historial detrás de ellos es a corto plazo.
La segunda es que hay menos sorpresas en el trabajo compartido. Una vez que sabes que Brain y la memoria personal son almacenes separados, es más fácil explicar por qué la sesión de un compañero de equipo sabía algo que la de otro no. Esta misma división aparece en otros lugares: los proyectos de Claude Code también mantienen la memoria del proyecto separada del repositorio, y la memoria de Devin reside en su propio repositorio Git.
Buenas prácticas para los Projects de Perplexity
Escribe las decisiones en archivos. Las sesiones y el historial no son el registro definitivo.
Lee Brain con regularidad. Corrige las entradas teniendo a la vista sus fuentes.
Decide sobre la memoria personal por cada Project. Los Projects compartidos a menudo requieren desactivarla.
Actualiza los archivos de los conectores. Son copias que se realizan una sola vez.
Vigila el límite de almacenamiento. Los Projects más antiguos que superen el límite no admitirán nuevas subidas.
Mantén el conocimiento compartido entre Projects en otro lugar. Cada Project es su propio espacio; el contenido de Spaces más antiguo plantea el mismo problema, como explica nuestra guía sobre por qué Perplexity olvida el contenido de Spaces.
Conclusión
El artículo del 12 de octubre de Perplexity confirma que cada Project está respaldado por un repositorio Git. Los agentes realizan commits desde sus propios sandboxes, los cambios que entran en conflicto con otros se vuelven a aplicar en lugar de sobrescribirse silenciosamente, y cada cambio aceptado se registra indicando quién lo realizó.
Hay dos matices importantes. El historial se compacta una vez que supera un umbral, unificando los commits más antiguos en una sola instantánea. Además, varios tipos de contexto quedan fuera del repositorio: el texto extraído de los documentos, los repositorios de conocimiento de Brain, la memoria personal y los originales detrás de las copias de los conectores.
Trata el repositorio como el hogar de los archivos actuales, guarda tus decisiones en esos archivos y mantén el razonamiento que necesitarás más adelante en un lugar al que ningún proceso de compactación pueda llegar.