
Lo que Anthropic realmente publicó
La sustancia está en dos páginas de documentación: "Use Claude Code in the cloud" y la referencia de entornos en la nube. La primera indica que "Las sesiones en la nube están disponibles en los planes Pro, Max y Team, y para usuarios de Enterprise con asientos premium o asientos de Chat + Claude Code". Puedes iniciar una desde el navegador, la aplicación móvil, la aplicación de escritorio o la terminal con claude --cloud.
La segunda página contiene la parte que importa para el contexto. Su sección "What carries over from your setup" se abre con tres frases que resumen todo el diseño: "Las sesiones en la nube comienzan a partir de una clonación limpia de tu repositorio. Cualquier cosa que confirmes (commit) en el repositorio estará disponible. Cualquier cosa que hayas instalado o configurado solo en tu propia máquina no estará disponible en la sesión".
Debajo de eso hay una tabla, fila por fila. Las filas que dicen sí tienen todas la misma razón: "Parte de la clonación". El archivo CLAUDE.md de tu repositorio, su .claude/rules/, su .claude/skills/, .claude/agents/ y .claude/commands/ llegan todos, porque son archivos en el repositorio.
Las filas que dicen no son aquellas en las que la gente confía sin pensar en ellas:
- Tu
~/.claude/CLAUDE.mda nivel de usuario, porque "Vive en tu máquina, no en el repositorio". - Tus habilidades, agentes y comandos de usuario, que "Viven en tu máquina, no en el repositorio. Confírmalos en el directorio
.claude/del repositorio en su lugar". - Los plugins que habilitaste solo en tu configuración de usuario.
- Los servidores MCP que agregaste en el alcance local predeterminado o en el alcance de usuario, porque "Esos escriben en
~/.claude.jsonen tu máquina, no en el repositorio".
La documentación de configuración dice lo mismo desde la otra dirección. Las configuraciones locales de usuario y proyecto (~/.claude/settings.json y .claude/settings.local.json) "no se leen. Ambas se quedan en tu máquina, y el archivo local no está en la clonación". La página de entornos en la nube agrega una advertencia específica sobre los hooks: "Si tienes hooks de SessionStart en tu ~/.claude/settings.json a nivel de usuario, no los esperes en la nube. Las configuraciones a nivel de usuario se quedan en tu máquina".
Y la documentación de memoria, que es anterior a este lanzamiento, ya respondía a la pregunta sobre lo que Claude ha aprendido en tu máquina: "Auto memory es local de la máquina. Todos los árboles de trabajo (worktrees) y subdirectorios dentro del mismo repositorio git comparten un directorio de auto memory. Los archivos no se comparten entre máquinas o entornos en la nube".
La conclusión de una sola línea que extrae Anthropic es clara: "Para que tu propia configuración esté disponible en las sesiones en la nube, confírmala en el repositorio".
Lo que esto cambia y lo que no
La disponibilidad general no cambia el funcionamiento de las sesiones en la nube; la tabla ya existía durante la vista previa. Lo que cambia es la escala: las sesiones en la nube son ahora algo que todo un equipo puede usar a diario, incluso para tareas que nadie está supervisando.
Eso traslada la pregunta a "qué sabe cuando comienza". Una sesión local comienza con varias capas de contexto: el CLAUDE.md del repositorio, tu ~/.claude/CLAUDE.md personal, tus habilidades personales, tus servidores MCP, tus hooks y cualquier auto memory que Claude haya acumulado para este proyecto en esta máquina. Una sesión en la nube comienza con la primera de esas capas y con lo que hayas colocado deliberadamente donde la nube pueda alcanzarlo.
Tampoco cambia la dirección de la transferencia desde la terminal. La documentación es explícita: "Desde la CLI, la transferencia de la sesión es unidireccional: puedes traer sesiones en la nube a tu terminal con --teleport, pero no puedes enviar una sesión de terminal existente a la nube". La aplicación de escritorio es la excepción, con un menú Continue in que "puede enviar una sesión local a la nube".
Teletransportarse también crea una copia en lugar de un enlace. Cuando descargas una sesión en la nube, "La terminal obtiene su propia copia de la sesión: el nuevo trabajo allí se queda en local y no aparece en la sesión en la nube en claude.ai ni en la aplicación móvil de Claude". La documentación también lo separa de la reanudación: "--resume reabre una conversación del historial local de esta máquina y no enumera las sesiones en la nube; --teleport descarga una sesión en la nube y su rama".
Si has leído why Claude Code forgets on your other machine, ya conoces la mitad de esta historia relacionada con auto memory. Este artículo trata sobre el resto de la capa de usuario: las instrucciones, habilidades, servidores, hooks y configuraciones que hacen que las sesiones locales se comporten como lo hacen, ninguno de los cuales viaja a menos que los muevas.
Lo que la gente asumirá de esto, y lo que no debería
"Mi configuración ya está en la nube". No lo está. Tu cuenta ha iniciado sesión y las configuraciones gestionadas por el servidor de tu organización sí llegan (la tabla señala que se "recuperan de los servidores de Anthropic cuando comienza la sesión"). Pero la configuración que creaste en tu directorio de inicio sigue en tu laptop.
"La sesión en la nube continuará donde lo dejó mi terminal". Solo si el estado relevante está en el repositorio. Una sesión de terminal no se puede enviar a la nube desde la CLI, y una sesión teletransportada se convierte en una copia local independiente. Dos sesiones que parecen una sola conversación pueden divergir silenciosamente, de la misma manera que a forked Claude Code session se guarda para sí misma lo que aprende la copia.
"El archivo de configuración del repositorio lo cubre todo". En su mayoría, para un solo repositorio. Para los hooks y las reglas de permisos en .claude/settings.json, la tabla dice "Sí, en una sesión con un repositorio", y luego agrega que "Una sesión con varios repositorios, incluido un hilo de proyecto, comienza por encima de las clonaciones y no las lee". Los plugins declarados en el repositorio son un caso aparte: "Una sesión en la nube no instala los plugins que un repositorio activa bajo enabledPlugins ".
"Cualquier cosa que instale Claude estará allí la próxima vez". La documentación dice lo contrario para las instalaciones ad hoc: "También puedes pedirle a Claude que instale paquetes a mitad de la sesión, pero esas instalaciones no se trasladan a otras sesiones". Usa un script de configuración para cualquier cosa que una sesión necesite siempre.
"Pondré mis tokens en variables de entorno". La advertencia de Anthropic es directa: "Cualquier persona que use el entorno puede leer sus variables de entorno y su script de configuración". En los planes Pro y Max, la documentación apunta en su lugar a las credenciales de API adjuntas por el proxy del agente.
Nada de esto es un fallo de diseño. Una sesión en la nube es una máquina limpia a propósito, y una máquina limpia solo sabe lo que le diste.
La solución: Decide qué debe saber cada sesión y colócalo donde la nube pueda leerlo
Una sesión en la nube debería comenzar con el mismo contexto de trabajo que tiene una buena sesión local, y lo que decida debería terminar donde la siguiente sesión pueda encontrarlo.
Paso 1: Haz un inventario de tu capa de usuario y clasifícala en equipo y personal
Abre tu carpeta de inicio y enumera lo que Claude Code lee de ella para este proyecto:
~/.claude/CLAUDE.md— tus instrucciones personales.~/.claude/skills/,~/.claude/agents/,~/.claude/commands/— tus procedimientos personales.~/.claude/settings.json— hooks, reglas de permisos y plugins con alcance de usuario.~/.claude.json— servidores MCP agregados con alcance local o de usuario.- El directorio de auto memory para este proyecto, cuyo
MEMORY.mdes un índice de lo que Claude ha guardado.
Para cada elemento, hazte una pregunta: ¿lo necesitaría un compañero de equipo que comience esta tarea? Los comandos de compilación, las convenciones de prueba y el servidor MCP del que depende la base de código son contexto de equipo que resulta que vive en tu carpeta de inicio. Tu longitud de respuesta preferida y tu lista de verificación de revisión personal son contexto personal.
Lee tu auto memory con especial cuidado. Es donde Claude registró lo que descubrió mientras trabajaba contigo: esa prueba inestable, el comando que realmente funciona. Cualquier cosa que todo el equipo deba saber pertenece al repositorio.
Si tus archivos de instrucciones personales y de proyecto han entrado en conflicto, soluciónalo primero. Reconciling conflicting CLAUDE.md layers cubre la versión local de este problema, y empeora cuando una de las capas desaparece por completo en la nube.
Paso 2: Mueve cada elemento al lugar que indica la documentación
La tabla de Anthropic te dice dónde debe ir cada cosa, así que síguela.
Las instrucciones de equipo van al CLAUDE.md del repositorio o a .claude/rules/. Las habilidades, agentes y comandos de equipo van al directorio .claude/ del repositorio, que la tabla marca como disponible porque es "Parte de la clonación".
Los servidores MCP que necesita el proyecto deben agregarse con alcance de proyecto. La documentación describe la ruta: "Agrega el servidor con claude mcp add --scope project, lo que escribe el .mcp.json del repositorio, y confirma ese archivo. Una sesión con un solo repositorio lo cargará".
Los hooks que configuran el entorno pertenecen al .claude/settings.json del repositorio o a un script de configuración; la documentación señala que los hooks se ejecutan "Después de que se inicia Claude Code, en cada sesión, incluidas las reanudadas".
Las habilidades personales y los plugins que deseas tener en todas partes tienen una segunda ruta. La tabla señala que "Las sesiones en la nube cargan automáticamente las habilidades que habilitas en claude.ai", y que los plugins habilitados para tu cuenta de claude.ai se cargan como plugins sincronizados.
Los secretos no reciben ninguno de los dos tratamientos. Manténlos fuera de las variables de entorno que otras personas puedan leer y utiliza el mecanismo de credenciales de API donde tu plan lo proporcione.
Paso 3: Informa sobre cada tarea en la nube y devuelve sus decisiones al repositorio
Incluso con el repositorio en buen estado, una tarea en la nube se beneficia de un breve informe: la tarea, qué significa "terminado", qué decisiones se han tomado y qué archivos no se deben tocar. Escríbelo para un contratista que nunca ha visto tu laptop, porque esa es la situación.
Luego, cierra el ciclo. Cuando una sesión en la nube tome una decisión que valga la pena conservar (una convención, una solución alternativa, la razón por la que se fijó una dependencia), pídele que la escriba en el repositorio como parte del mismo pull request. De lo contrario, vivirá solo en la transcripción de esa sesión, y cada sesión posterior comenzará sin ella.
Finalmente, decide dónde vive la copia canónica de una tarea larga. Si teletransportas una sesión a tu terminal y sigues trabajando, recuerda la redacción de la documentación: el nuevo trabajo allí "se queda en local y no aparece en la sesión en la nube". Elige un lugar para continuar y trata el otro como historial.
Si usas proyectos de Claude Code para coordinar varios hilos en la nube, obtienes una capa adicional para esto. La documentación de proyectos describe la memoria del proyecto como notas que Claude guarda sobre requisitos, decisiones y dificultades, y establece que "Son independientes de la auto memory que Claude Code guarda en tu máquina, aunque ambas usan un índice MEMORY.md ". Cómo funciona esa memoria compartida entre hilos se cubre en Claude's redesigned projects.
Configuración de esto en MemoryLake
Mover el contexto de equipo al repositorio resuelve la parte que pertenece a una sola base de código. Lo que queda es el contexto que abarca repositorios, máquinas y herramientas: decisiones de arquitectura que se aplican a tres servicios, las razones detrás de una convención, tus propias preferencias de trabajo, lecciones de un proyecto que terminó el trimestre pasado. MemoryLake es un lugar para mantener esa capa de modo que llegue a cada sesión que inicies, ya sea local o en la nube.
Tú mismo escribes las entradas, con tus propias palabras. No se lee, escribe ni elimina nada de tu carpeta ~/.claude, tu directorio de auto memory, tus sesiones en la nube o el almacenamiento de cualquier proveedor.
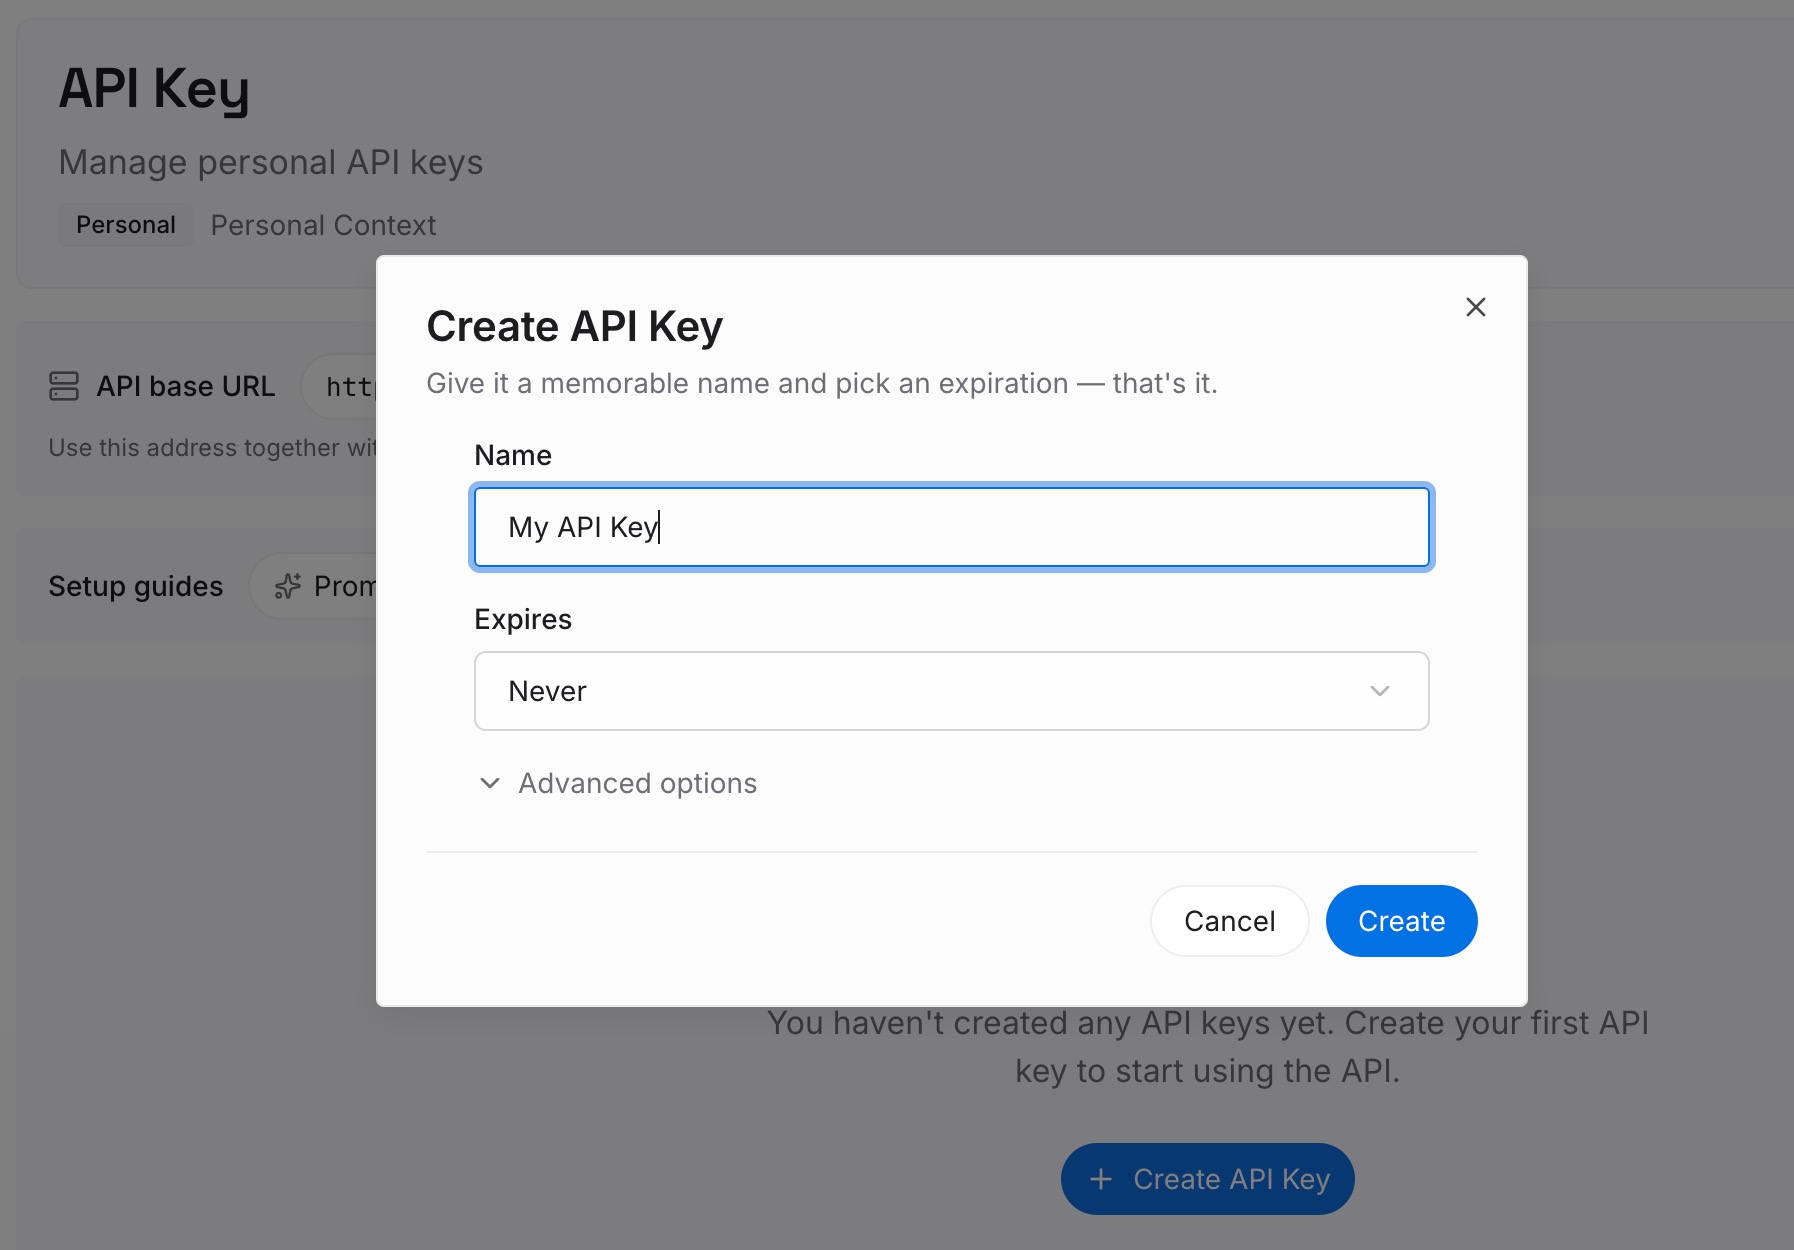
Paso 1: Crea una clave de API
Inicia sesión y genera una clave desde el panel de control. La clave pertenece a tu espacio de trabajo en la capa de memoria, no a una máquina en particular, por lo que una clonación limpia en la nube y tu laptop llegarán al mismo lugar.
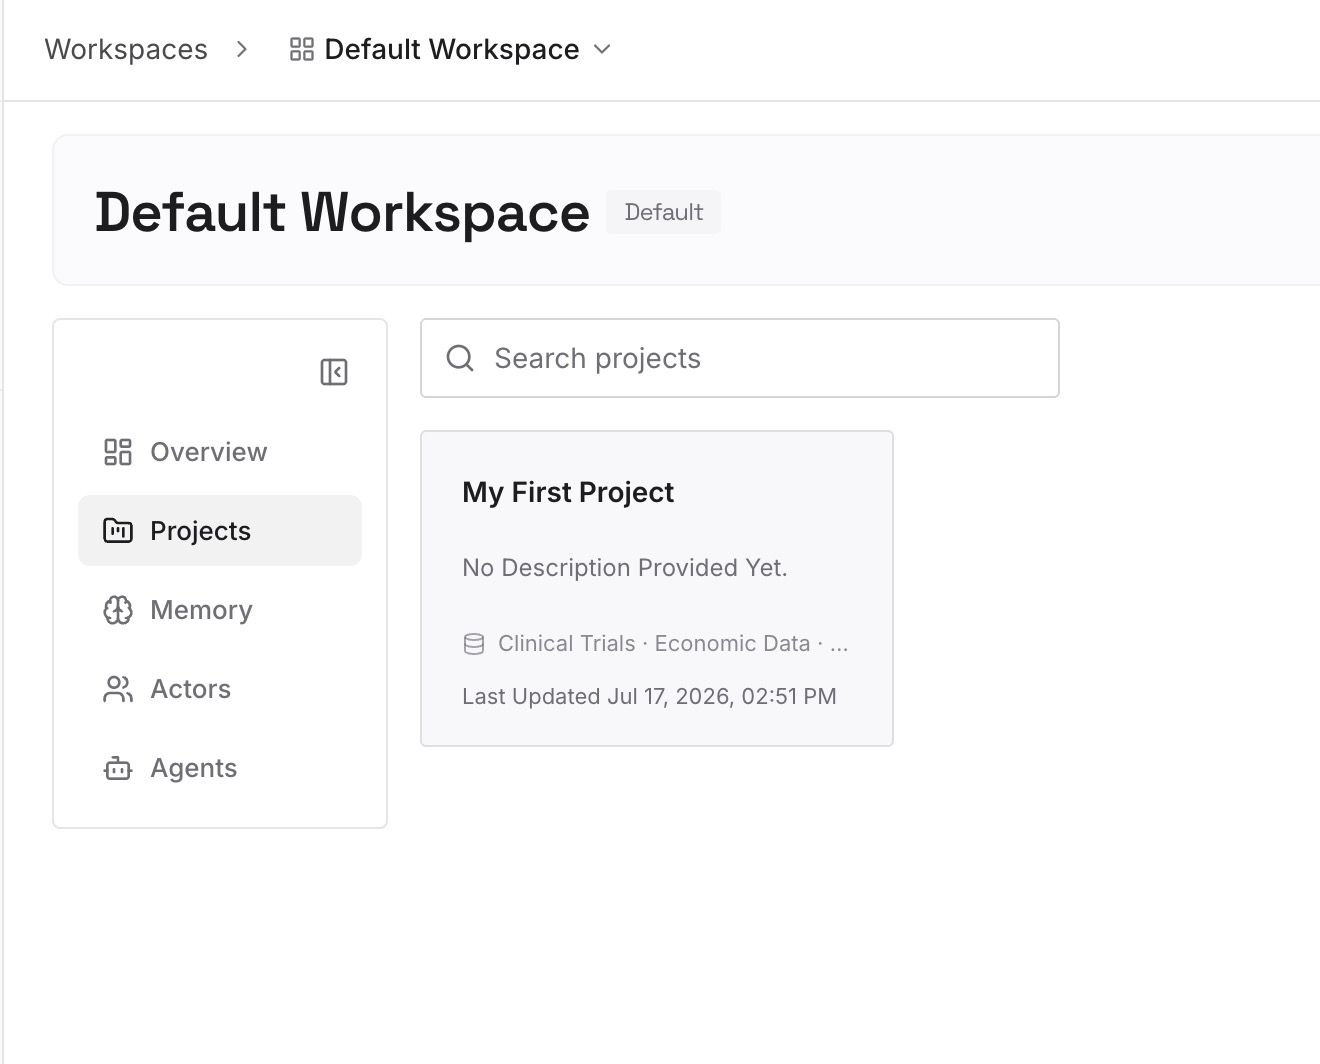
Paso 2: Sube tus primeras memorias
Comienza con el inventario del Paso 1 de la solución anterior: las decisiones entre proyectos, las razones detrás de las convenciones y las preferencias que de otro modo repetirías en cada informe. Un dato por entrada, redactado de la forma en que se lo explicarías a un nuevo compañero de equipo.
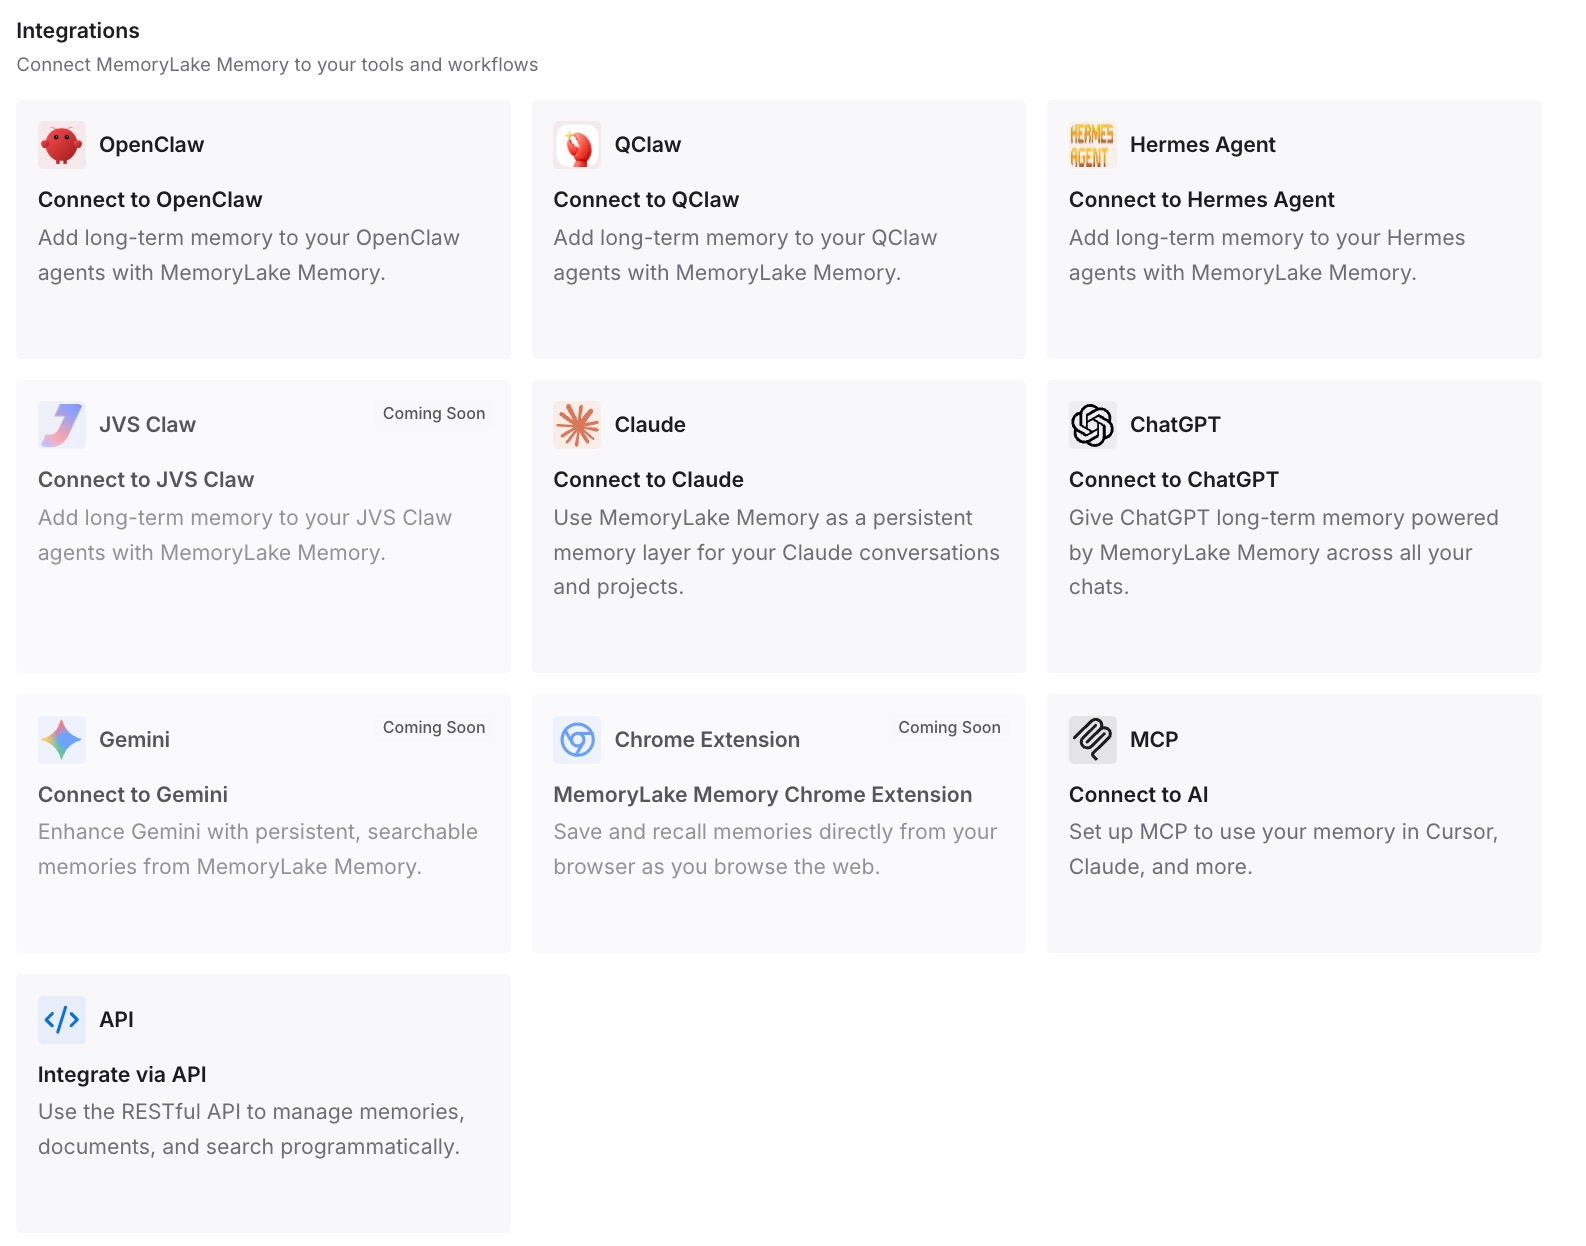
Paso 3: Conecta tu IA y agentes
Conecta Claude Code y los demás asistentes que utilices. Las mismas entradas estarán disponibles dondequiera que se ejecute una sesión, incluso en herramientas que nunca leen CLAUDE.md en absoluto.
Lo que esto cambia en la práctica
La primera diferencia es que las sesiones en la nube dejan de sentirse menos capaces que las locales. La mayor parte de la brecha que la gente nota es la falta de contexto que vivía en una carpeta de inicio, no en el modelo o la máquina.
La segunda es que el contexto personal y el de equipo finalmente se separan. El acto de decidir qué elementos de ~/.claude son conocimiento del equipo es útil por sí mismo, y tiende a sacar a la luz instrucciones que deberían haber estado en el repositorio desde el principio. Es el mismo trabajo de clasificación descrito en sharing context between Claude Code sessions, con un plazo más estricto.
La tercera es que las tareas largas se vuelven más seguras de delegar. Una sesión que está bien informada y escribe sus decisiones de vuelta en el repositorio deja un rastro que la siguiente sesión puede seguir, dondequiera que se ejecute.
La cuarta es conceptual. En términos de ingeniería de contexto, una sesión en la nube demuestra que el contexto es algo que tú ensamblas, no algo que un agente lleva consigo. La misma lógica se aplica dentro de una ejecución larga, donde what you tell Claude Code to keep durante la compactación decide qué sobrevive.
Buenas prácticas para las sesiones en la nube de Claude Code
Trata el entorno de la nube como la máquina de un nuevo compañero de equipo. Tiene el repositorio y nada más de tu configuración. Infórmale en consecuencia.
Confirma (commit) el contexto de equipo, no el contexto personal. Los comandos de compilación, las convenciones y los servidores MCP del proyecto van en el repositorio. Tus preferencias de estilo personal no necesitan ir allí.
Usa el alcance de proyecto para los servidores MCP que necesita la base de código. Un servidor agregado con alcance de usuario vive en ~/.claude.json y se queda en tu laptop.
Mantén los secretos fuera de las variables de entorno. Cualquier persona que use el entorno puede leerlos.
Elige una copia canónica de una tarea larga. Teletransportarse crea una copia local; decide qué lado continúa.
Escribe las decisiones de vuelta como parte del pull request. Una decisión que se queda en una transcripción es invisible para la siguiente sesión. Lo mismo se aplica cuando move a session to another machine manualmente.
Conclusión
Que las sesiones en la nube salgan de la vista previa de investigación es un verdadero hito: entrégale una tarea a Claude Code, cierra la laptop y regresa al trabajo terminado.
La documentación de Anthropic es igualmente clara sobre la otra mitad. Una sesión en la nube es una clonación limpia. Tu CLAUDE.md a nivel de usuario, tus habilidades personales, tus servidores MCP con alcance de usuario, tus hooks y tu auto memory se quedan en tu máquina. Como dice la documentación: "Para que tu propia configuración esté disponible en las sesiones en la nube, confírmala en el repositorio".
Haz un inventario de la capa de usuario, mueve el contexto de equipo al repositorio o a tu cuenta de claude.ai, informa sobre cada tarea y trae de vuelta las decisiones. Mantén el contexto que abarca repositorios en una capa a la que cada sesión pueda acceder.