
Las rutinas ahora se llaman tareas programadas
Anthropic cambió el nombre de la función. Su documentación comienza con: "Una tarea programada en la nube, anteriormente una rutina, es una configuración guardada de Claude Code: un prompt, uno o más repositorios y un conjunto de conectores, empaquetados una vez y ejecutados automáticamente".
El nombre antiguo no ha desaparecido. La documentación tiene una sección sobre dónde sigue apareciendo: en algunas cuentas, la barra lateral y los botones todavía dicen Routines y New routine, la dirección web es claude.ai/code/routines, la CLI mantiene /routines como un alias para /schedule, y el endpoint /fire de la API mantiene la nomenclatura de routine. Todos se refieren a la misma función.
Una tarea programada en la nube puede tener tres tipos de disparadores: una programación, una llamada a la API a su propio endpoint y un evento de GitHub como un pull request. Una sola tarea puede combinarlos.
Tres formas de programar el trabajo en Claude Code
La documentación compara las tres opciones en una tabla. Las filas que más importan para el contexto son:
- Cloud: se ejecuta en la infraestructura gestionada por Anthropic de forma predeterminada, no necesita que su máquina esté encendida y tiene acceso "No (clon fresco)" a los archivos locales.
- Desktop: se ejecuta en su máquina, necesita que esté encendida, pero no necesita una sesión abierta, y tiene acceso a los archivos locales.
/loop: se ejecuta en su máquina dentro de una sesión abierta y hereda los servidores MCP y los permisos de esa sesión.
El consejo de la propia documentación: "Use cloud tasks para trabajos que deban ejecutarse de manera confiable sin su máquina. Use Desktop tasks cuando necesite acceso a archivos y herramientas locales. Use /loop para sondeos rápidos durante una sesión".
Con qué comienza una tarea programada en la nube
Una nueva sesión, cada ejecución
Cada ejecución de una tarea programada en la nube es su propia sesión. La documentación dice que cuando abres una ejecución de la lista de Historial de la tarea, esta "se abre como una sesión completa, una nueva para cada ejecución". Para los disparadores de GitHub es explícito: "Claude Code no reutiliza sesiones entre eventos, por lo que dos actualizaciones de PR producen dos sesiones independientes".
Por lo tanto, la ejecución del martes no comienza con la conversación del lunes. Comienza con el prompt guardado y lo que el repositorio y el entorno proporcionen.
Un clon fresco del repositorio
"Cada repositorio que agregas se clona en cada ejecución. Claude comienza desde la rama predeterminada del repositorio a menos que tu prompt especifique lo contrario". El trabajo se envía a una rama con el prefijo claude/ a menos que el prompt diga lo contrario.
Ese clon es lo principal que hereda una ejecución. La página de entornos en la nube de Claude Code enumera lo que viene con él: el CLAUDE.md de su repositorio, .claude/rules/ y .claude/skills/ están disponibles porque son "Parte del clon". La página también establece el principio: "Cualquier cosa que confirmes (commit) en el repositorio está disponible. Cualquier cosa que hayas instalado o configurado solo en tu propia máquina no está disponible en la sesión".
Nada de su propia máquina
Su configuración personal se queda en casa. La misma tabla indica que su ~/.claude/CLAUDE.md de usuario no está disponible, porque "Vive en su máquina, no en el repositorio". La memoria automática (auto memory) también es local: la documentación de memoria de Claude Code dice que "La memoria automática es local de la máquina" y "Los archivos no se comparten entre máquinas o entornos en la nube". Nuestra guía sobre sesiones en la nube de Claude Code y su configuración local tiene la lista completa de lo que se queda atrás.
Es por eso que la nota sobre la prueba inestable no se mantuvo. Se lo dijo a la ejecución del lunes, en la sesión del lunes. La sesión del martes comenzó desde el mismo prompt y un clon fresco, y la nota no estaba en ninguno de los dos.
Usted mismo puede continuar una ejecución finalizada
Una ejecución no queda sellada cuando termina. "Haga clic en cualquier ejecución para abrirla como una sesión completa. Desde allí puede ver lo que hizo Claude, revisar los cambios, crear un pull request o continuar la conversación". Continuar una ejecución continúa esa sesión; no cambia con qué comienza la próxima ejecución programada.
La excepción: tareas programadas en un proyecto
Los nuevos Projects de Claude Code cambian una cosa. La documentación dice: "En un proyecto, una ejecución puede continuar un hilo en lugar de iniciar una nueva sesión". Las tareas programadas creadas desde un proyecto aparecen en la pestaña de tareas programadas de ese proyecto y se ejecutan como hilos allí.
Los proyectos también tienen su propia memoria. La documentación de proyectos la describe como "Notas que Claude guarda sobre el proyecto, como requisitos, decisiones y trampas, almacenadas como archivos", y cada hilo en la nube lee su índice MEMORY.md cuando comienza. Cuando corriges un hilo, la documentación sugiere decirle a Claude que recuerde la corrección: "va a la memoria del proyecto y los hilos de la nube posteriores comienzan con ella".
Así que dentro de un proyecto, una ejecución programada puede continuar un hilo o iniciar un hilo que lea la memoria del proyecto. De cualquier manera, comienza con más que un clon fresco. Los proyectos están en beta pública en los planes Pro y Max y se están implementando gradualmente. Nuestra guía sobre Claude Code Projects y la memoria de proyecto cubre cómo funciona esa memoria.
Con qué comienza una tarea programada en Desktop
Las tareas de Desktop se ejecutan en su computadora. La documentación dice: "Las tareas programadas inician una nueva sesión automáticamente a la hora y frecuencia que elijas". Al igual que las tareas en la nube, cada ejecución es una nueva sesión.
Lo que difiere es la máquina. Una tarea de Desktop tiene "acceso directo a tus archivos y herramientas", por lo que se ejecuta con su configuración local, y la documentación de memoria de Claude Code dice que los archivos CLAUDE.md y la memoria automática se cargan en cada sesión. Una ejecución de Desktop en su computadora portátil puede comenzar desde la misma memoria automática que usan sus sesiones interactivas allí.
El directorio de trabajo también importa. La documentación señala: "Por defecto, las tareas programadas locales se ejecutan sobre cualquier estado en el que se encuentre su directorio de trabajo, incluidos los cambios no confirmados". Puede darle a cada ejecución su propio árbol de trabajo (worktree) aislado en su lugar, y nuestra guía sobre si los worktrees de Claude Code comparten memoria explica qué carga una sesión de worktree.
Las tareas de Desktop solo se ejecutan mientras la aplicación está abierta y la computadora está despierta. La vista de Historial muestra las ejecuciones omitidas y por qué se omitieron.
Lo que mantiene /loop
/loop es la única opción que se ejecuta dentro de una conversación existente. La documentación describe "tareas programadas con alcance de sesión" que "permiten a Claude volver a ejecutar un prompt automáticamente en un intervalo dentro de una sesión de Claude Code". Debido a que cada repetición ocurre en la misma sesión, tiene el contexto de esa sesión, incluido lo que encontraron las repeticiones anteriores.
La desventaja es la vida útil. "Las tareas tienen alcance de sesión". Cuando reanuda con --resume o --continue, Claude Code restaura las tareas que no han expirado, y la documentación establece una expiración de siete días. Para una programación que sobreviva a una sesión, apunta a las tareas en la nube o de Desktop.
Lo que la gente intenta primero
Decirle a la ejecución que recuerde. En una tarea en la nube fuera de un proyecto, la siguiente ejecución es una nueva sesión con un clon fresco, por lo que la instrucción se queda en la sesión donde la dio.
Editar ~/.claude/CLAUDE.md para una tarea en la nube. Los archivos a nivel de usuario no son parte del clon.
Confiar en la memoria automática en la nube. Es local de la máquina.
Usar /loop para un trabajo nocturno. Necesita una sesión abierta en su máquina y expira.
Asumir que una ejecución exitosa hizo el trabajo. La documentación advierte que las etiquetas de resultado "indican cómo terminó la sesión, no si Claude completó el trabajo que describe su prompt", así que lea la transcripción.
La solución: Dar a cada ejecución algo que leer y un lugar donde escribir
Paso 1: Poner el conocimiento permanente en el repositorio
Cualquier cosa que cada ejecución deba saber va donde cada ejecución lo vea. Para una tarea en la nube, eso es un archivo confirmado: el CLAUDE.md raíz, una regla en .claude/rules/ o un archivo de notas al que apunte el prompt. Una línea que diga que la prueba inestable es conocida, está bajo seguimiento y no debe marcarse pertenece a un archivo confirmado, no a una respuesta a la ejecución del lunes.
Paso 2: Hacer que el prompt lea y actualice un registro continuo
Si cada ejecución debe basarse en la anterior, dígalo en el prompt guardado. Apúntelo a un archivo en el repositorio, como docs/nightly-review-log.md, y dígale que lea el archivo primero y añada lo que encontró antes de terminar. Debido a que la ejecución empuja a una rama claude/, decida cómo se fusionan esas actualizaciones para que el clon de la siguiente ejecución las incluya. En un proyecto, pídale a Claude que recuerde el hallazgo en su lugar, y los hilos posteriores comenzarán con él.
Paso 3: Revisar las ejecuciones y corregir la fuente
Abra las ejecuciones regularmente y lea lo que hizo Claude. Cuando una ejecución haga algo mal, corríjalo donde la siguiente ejecución lo lea: el archivo confirmado, el prompt o la memoria del proyecto. Corregirlo solo en la conversación de esa ejecución deja a la siguiente ejecución donde estaba.
Configurando esto en MemoryLake
Una tarea programada comienza desde su prompt y su repositorio. Sus convenciones, las decisiones detrás de ellas y lo que ya ha descartado a menudo viven en otro lugar: en su cabeza, en el historial de chat o en la memoria automática de una máquina.
MemoryLake es una capa de memoria para mantener ese contexto en una lista que usted mantiene, disponible para Claude Code y los otros asistentes que conecte, como ChatGPT y Codex.
Usted mismo escribe las entradas, con sus propias palabras. No se lee nada, ni se escribe, ni se elimina de sus tareas programadas, sus sesiones de ejecución, su memoria automática, su memoria de proyecto o el almacén de cualquier proveedor. Para repositorios de trabajo, siga la política de su organización sobre lo que guarda fuera de ellos.
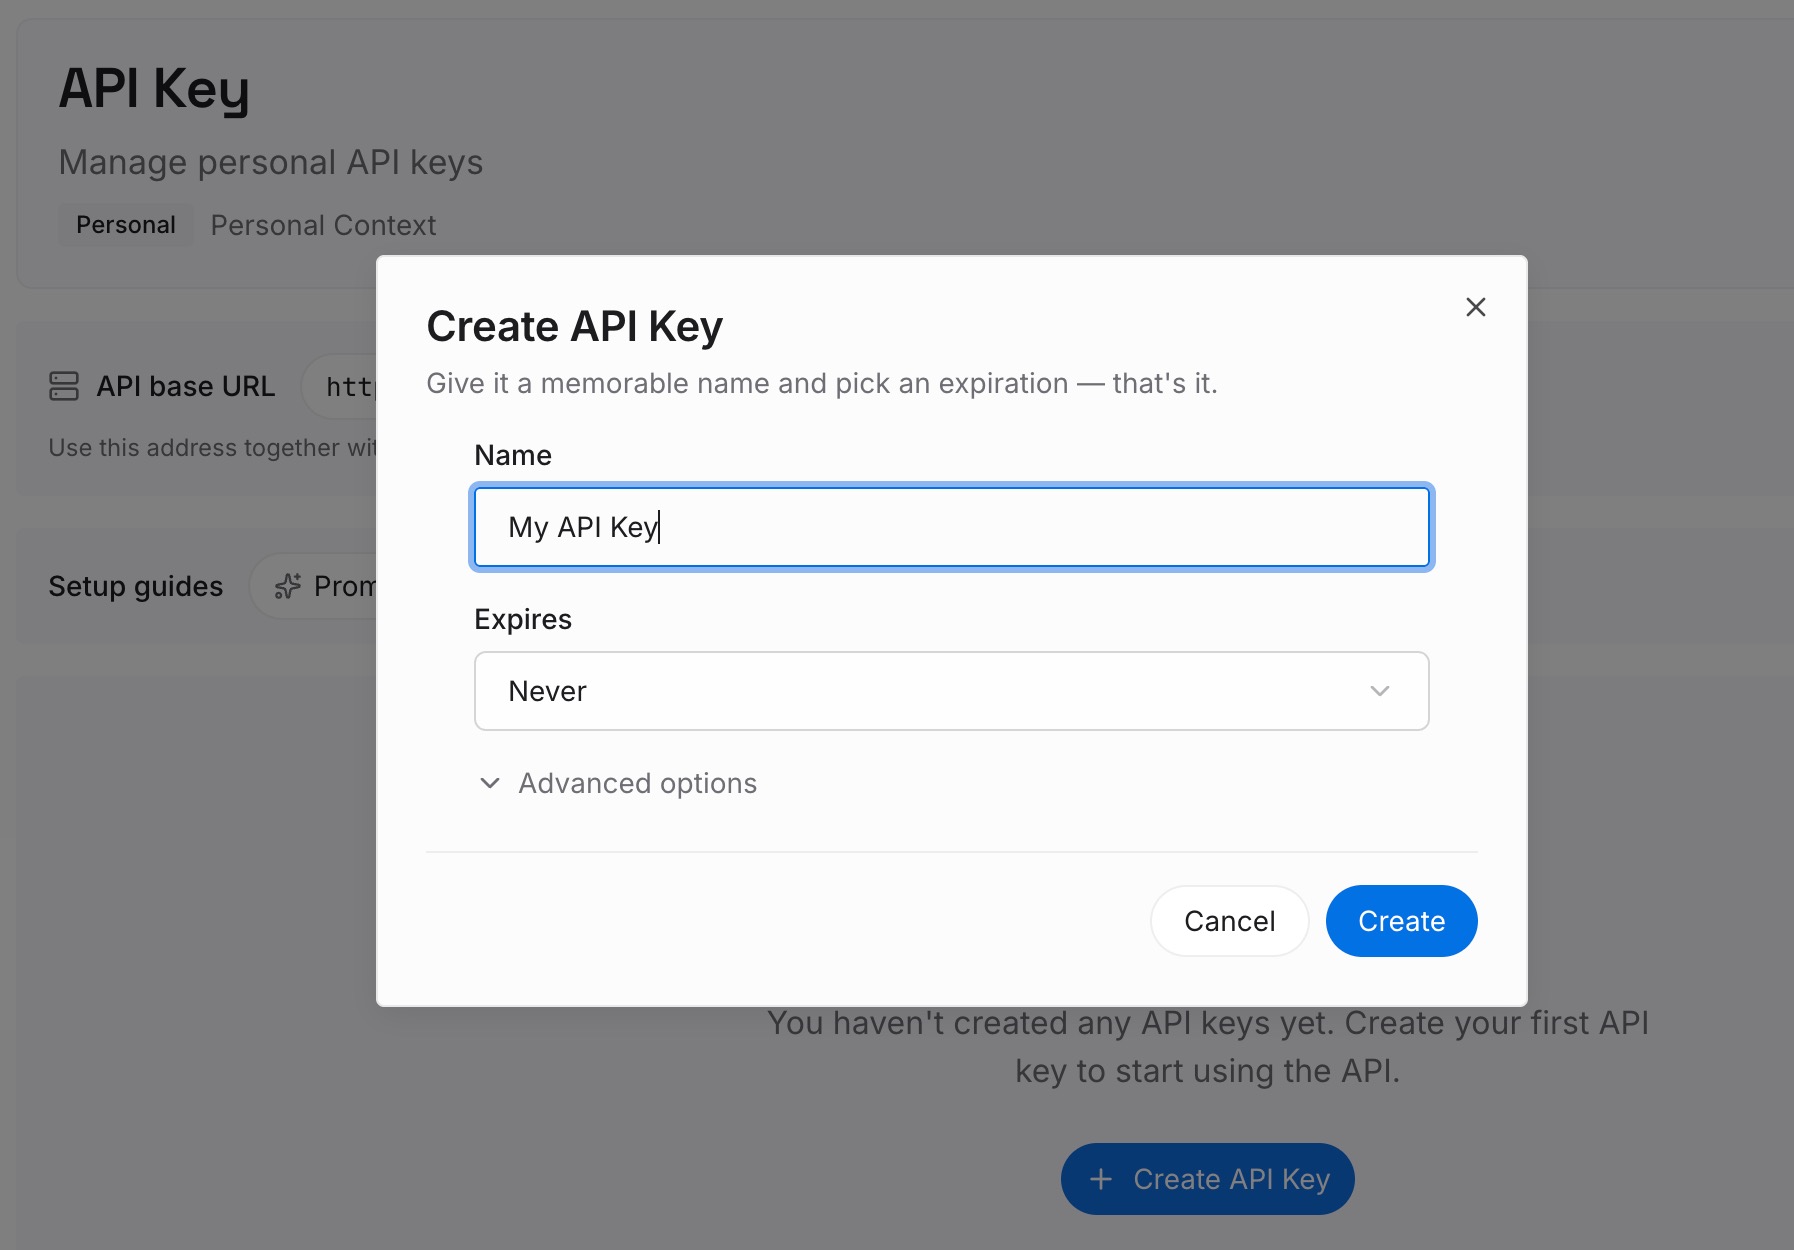
Paso 1: Crear una clave API
Inicie sesión y genere una clave desde el panel de control. La clave pertenece a su espacio de trabajo de MemoryLake y es independiente de su cuenta de Claude.
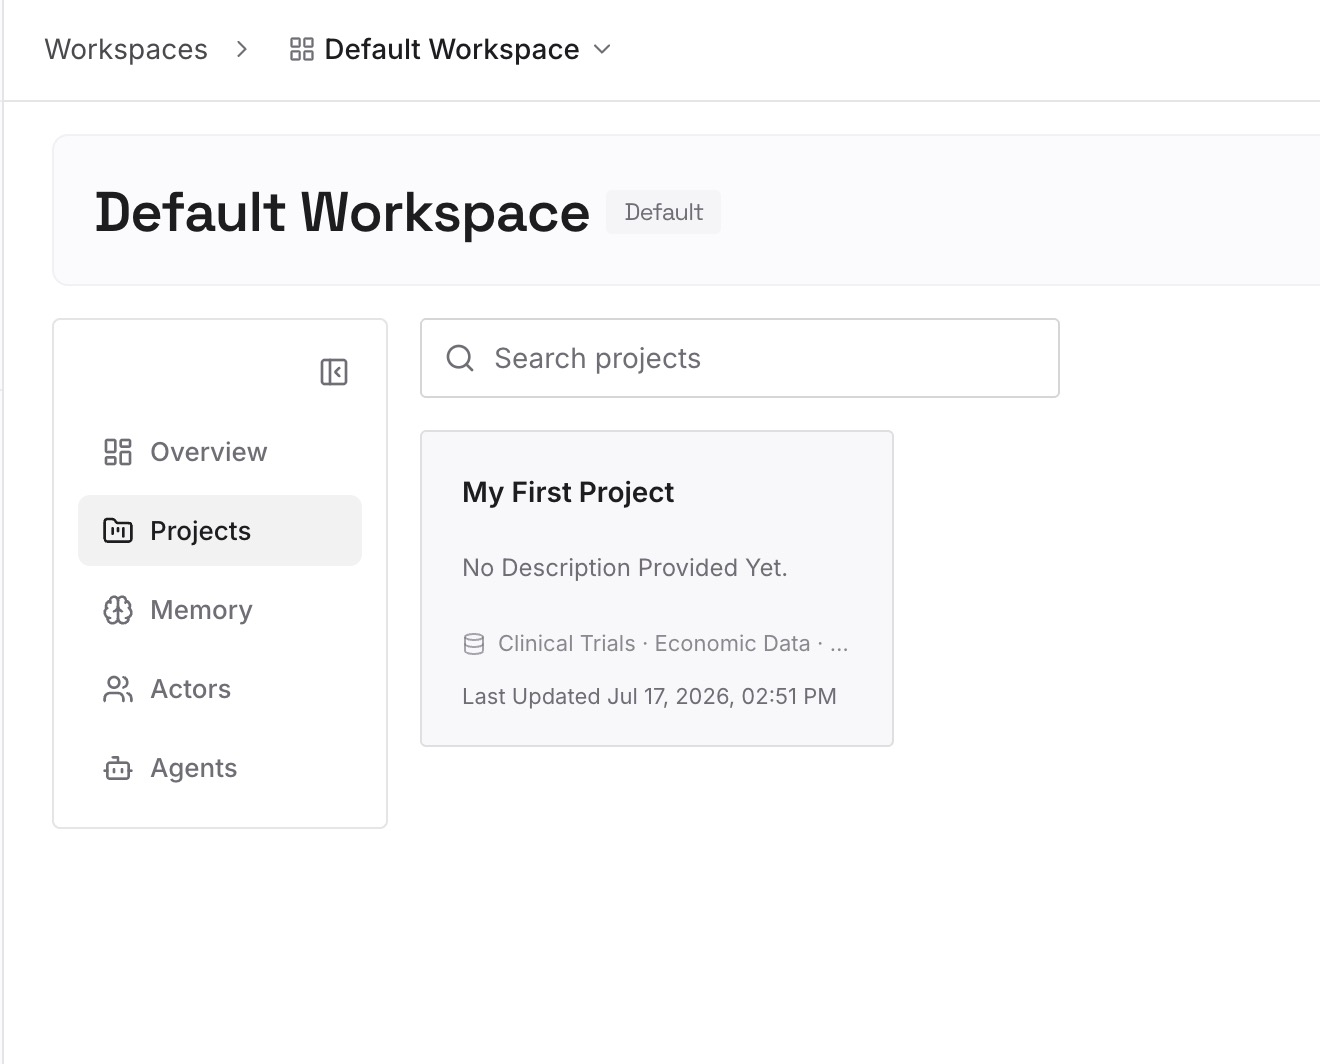
Paso 2: Subir sus primeras memorias
Comience con lo que de otro modo repetiría en cada ejecución: problemas conocidos, estándares de revisión y decisiones sobre qué ignorar. Un punto por entrada, con fecha y etiquetado con el repositorio al que se aplica.
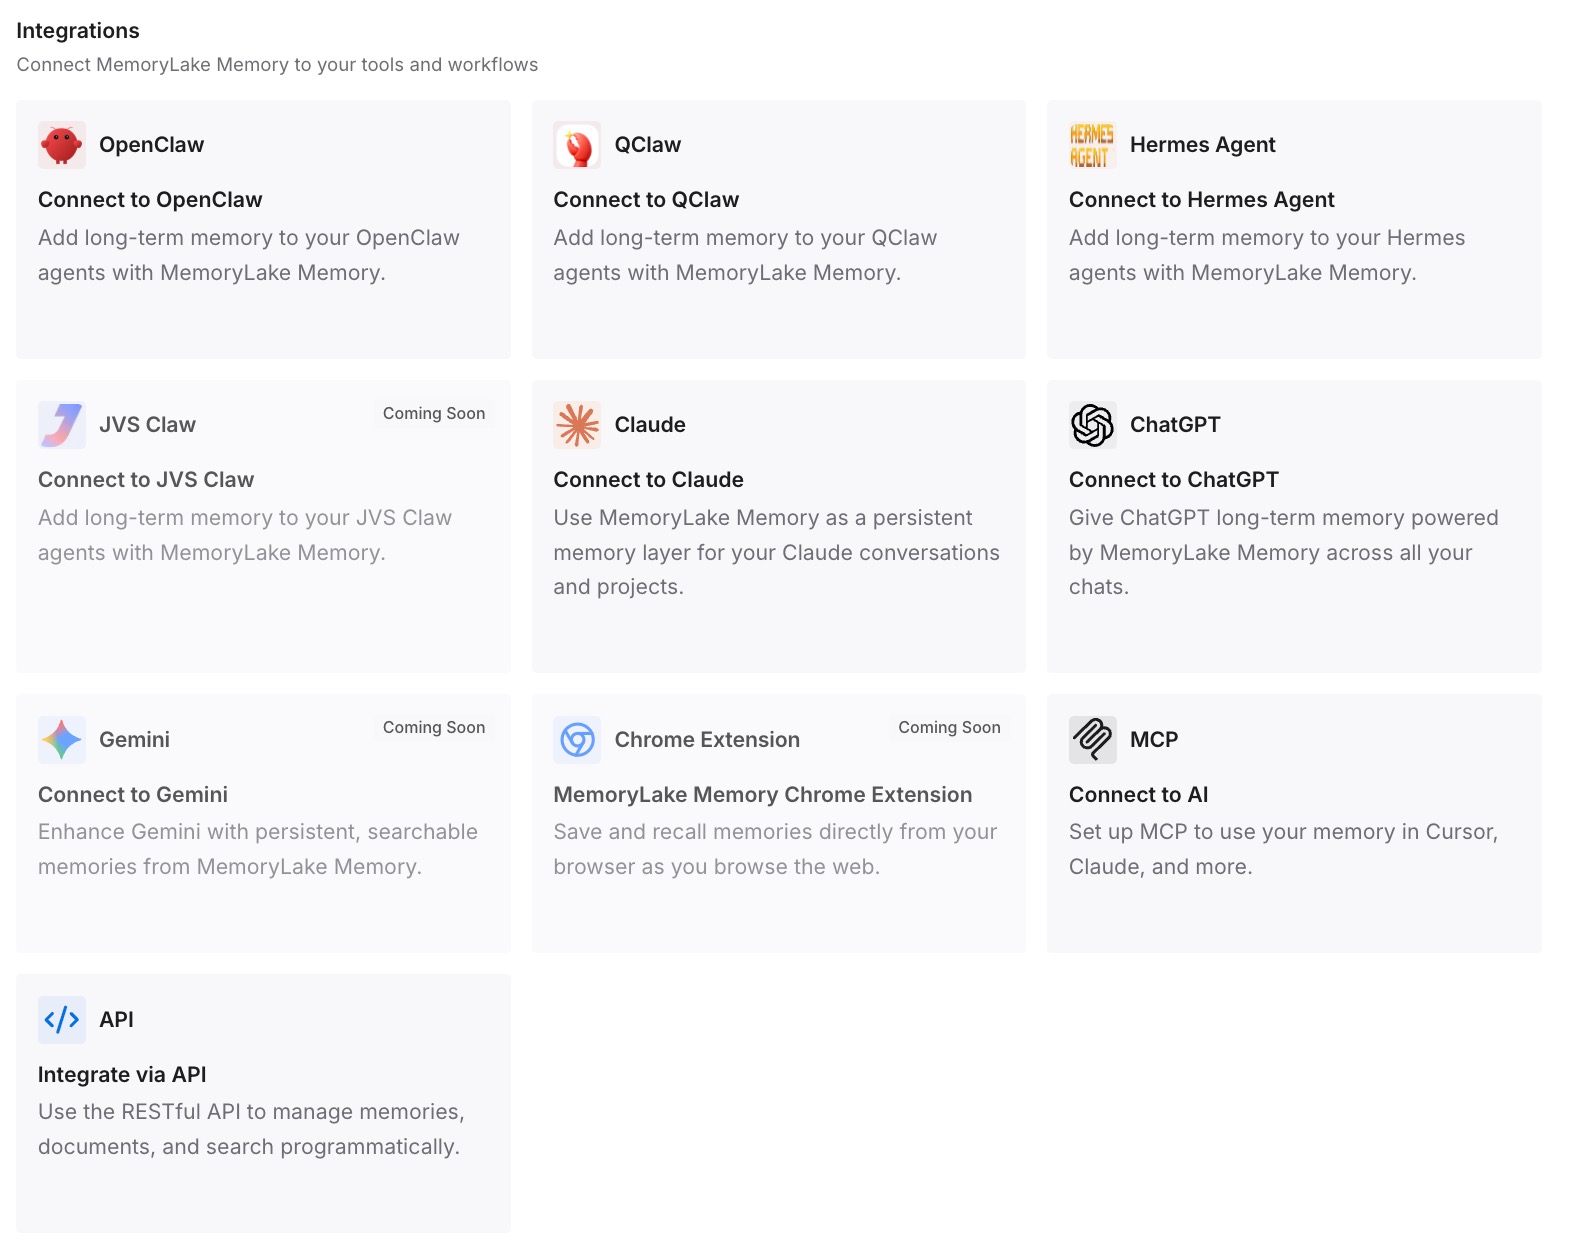
Paso 3: Conectar su IA y agentes
Conecte Claude Code y los otros asistentes que utilice. El contexto en el que confía está en un solo lugar, independientemente de la sesión o herramienta que esté realizando el trabajo.
Lo que esto cambia en la práctica
La primera diferencia es que el comportamiento de una ejecución deja de ser sorprendente. Usted sabe que una ejecución en la nube comienza desde un clon fresco y una nueva sesión, y sabe dónde están las excepciones.
La segunda es que las correcciones se mantienen. Van a un archivo, al prompt o a la memoria del proyecto, no a una conversación que la siguiente ejecución no verá.
La tercera es que puede elegir el tipo correcto de tarea. Si también programa trabajo en ChatGPT, nuestra guía sobre tareas programadas en ChatGPT cubre la misma pregunta allí.
Mejores prácticas para las tareas programadas de Claude Code
Trate cada ejecución en la nube como una nueva sesión. Dele lo que necesita en el prompt y en el repositorio.
Confirme el conocimiento permanente. CLAUDE.md, reglas o un archivo de notas que el prompt nombre.
Mantenga un registro continuo si las ejecuciones deben basarse unas en otras. Y asegúrese de que las actualizaciones lleguen a la rama que clona la siguiente ejecución.
Use un proyecto cuando quiera continuidad. Las ejecuciones allí pueden continuar un hilo o comenzar desde la memoria del proyecto.
Use tareas de Desktop para trabajos que necesiten su configuración local. Se ejecutan con sus archivos y memoria automática.
Reserve /loop para sondeos cortos. Vive en una sola sesión.
Lea las transcripciones, no solo los resultados. Una ejecución exitosa solo significa que la sesión terminó normalmente.
Si Claude Code también olvida su configuración cuando cambia de computadora, nuestra guía sobre Claude Code en otra máquina cubre ese caso.
Conclusión
Las rutinas de Claude Code ahora se llaman tareas programadas en la nube. Cada ejecución en la nube es una nueva sesión que comienza desde un clon fresco de sus repositorios y el prompt guardado, sin su configuración local ni memoria automática. Dentro de un proyecto, una ejecución puede continuar un hilo y los hilos comienzan desde la memoria del proyecto. Las tareas de Desktop se ejecutan como nuevas sesiones en su máquina con sus archivos locales, y /loop se repite dentro de una sesión hasta que termina o expira.
Para hacer que las ejecuciones se basen unas en otras, ponga lo que necesitan en el repositorio, haga que el prompt lea y actualice un registro, y corrija los errores donde la siguiente ejecución los lea.