
Por qué copiar el archivo de sesión no funciona
Una sesión de Claude Code es una conversación guardada vinculada a un directorio de proyecto. Por defecto, la transcripción reside como JSONL en ~/.claude/projects/<project>/<session-id>.jsonl, donde el segmento del proyecto es la ruta de tu directorio de trabajo con los caracteres no alfanuméricos reemplazados por guiones.
Así que el archivo está justo ahí, y copiarlo parece la solución. Aquí está el comportamiento documentado cuando lo haces:
"La búsqueda entre proyectos resuelve el ID solo cuando exactamente otro proyecto contiene una transcripción con mensajes para él, por lo que un duplicado copiado a mano hace que Claude Code informe que no se encontró en lugar de reanudar una copia arbitraria."
Lee eso dos veces. La búsqueda no está fallando al encontrar tu copia. Está encontrando dos candidatas y negándose a adivinar. Copiar el archivo es la acción que rompe la reanudación, y cuanto más cuidadoso hayas sido —copiando en lugar de moviendo, manteniendo el original a salvo— con mayor seguridad caerás en el fallo.
Hay una segunda razón para no construir sobre ese archivo, expresada con la misma claridad:
"El formato de entrada es interno de Claude Code y cambia entre versiones, por lo que los scripts que analizan estos archivos directamente pueden romperse en cualquier lanzamiento. Para construir sobre los datos de la sesión, utiliza /export o las interfaces de script en su lugar."Y una tercera cosa que vale la pena saber antes de planificar en torno al archivo: las transcripciones caducan. La limpieza de retención se ejecuta con un valor predeterminado de treinta días, ajustable a través de una clave de configuración. Una transcripción es un artefacto de trabajo, no un archivo histórico.
Este es un problema diferente al de rebobinar una sesión a un punto anterior, que se mantiene dentro de una sola máquina y una sola sesión, y un problema diferente también al de bifurcar una sesión remota desde la aplicación Claude, donde la copia es realizada por la herramienta y se registra correctamente. Aquí la pregunta es cómo la sustancia de una conversación llega a una máquina que nunca la tuvo.
Lo que la gente intenta en su lugar
Copiar el JSONL y reanudar por ID. Cubierto anteriormente. El duplicado es lo que causa el error de no encontrado.
Copiar todo el directorio del proyecto bajo ~/.claude/projects. Mismo mecanismo, mayor radio de impacto. Ahora tienes dos directorios que contienen transcripciones con mensajes para los mismos IDs.
Escribir un script que analice el JSONL para generar un resumen. Esto funciona hasta el próximo lanzamiento. El formato es explícitamente interno y está documentado que cambia entre versiones.
Reanudar y esperar que la configuración de inicio venga con ello. No es así, y la lista de lo que se debe volver a pasar es específica: "Si la sesión dependía de --mcp-config, --settings, --plugin-dir, --fallback-model o directorios agregados con --add-dir, pásalos de nuevo cuando reanudes". Los directorios agregados a mitad de la sesión con el comando add-directory tampoco se restauran. Los archivos de configuración se vuelven a leer al inicio, por lo que cualquier cosa que resida en ellos sí regresa.
Asumir que todo en la conversación sobrevive. La mayor parte sí. Una sesión reanudada restaura el historial completo, incluyendo las llamadas a herramientas y sus resultados. Pero una herramienta que aún se estaba ejecutando cuando finalizó el proceso anterior "no termina ni se ejecuta de nuevo cuando reanudas; Claude continúa sin su salida". Si tu última acción fue una compilación larga, su resultado no estará en la conversación reanudada.
Confiar en un resumen que no solicitaste. En un plan Pro o Max, reanudar una sesión que ha estado inactiva durante más de una hora aproximadamente y supera los 100,000 tokens abre primero un diálogo. Una opción ejecuta la compactación de inmediato y "reemplaza el historial con el resumen, tus intercambios más recientes y hasta cinco archivos leídos recientemente". Ese es un valor predeterminado razonable y un archivo histórico deficiente, por las mismas razones que hacen que elegir qué sobrevive a la compactación sea un acto deliberado.
La solución: Exportar un registro legible y luego trasladar las decisiones por separado
Dos artefactos hacen dos trabajos diferentes. La exportación te da la conversación como un documento. Las decisiones dentro de ella deben viajar como hechos, no como una transcripción.
Paso 1: Exportar la conversación mientras la sesión aún está abierta
Ejecuta el comando de exportación dentro de la sesión. Abre un menú que te permite copiar la conversación al portapapeles o guardarla como un archivo de texto plano, con los mensajes y las salidas de las herramientas renderizados como texto legible. Pasa un nombre de archivo y omitirá el menú para escribir directamente en ese archivo.
Lo que obtienes se describe con precisión: "/export produce una transcripción renderizada para que la lea una persona". Esa es la expectativa correcta. Es un documento que tú o un colega pueden leer en cualquier máquina, en cualquier editor, sin depender de una versión de Claude Code.
Haz esto antes de terminar el día en lugar de después. La exportación se ejecuta contra la conversación en vivo, y es el único paso que se vuelve más difícil una vez que la limpieza de retención o un diálogo de compactación han hecho de las suyas.
Paso 2: Extraer las decisiones de la exportación en hechos independientes
Abre el archivo exportado y léelo buscando conclusiones en lugar de narrativa. Estás buscando la pequeña cantidad de líneas que cambiarían lo que alguien hará mañana.
Vale la pena extraer tres tipos de información. Decisiones que fueron discutidas y resueltas (por ejemplo, la migración se ejecuta antes del llenado de datos, y la razón). Restricciones descubiertas de la manera difícil (esta tabla no se puede alterar mientras el trabajo se está ejecutando). Vocabulario que de otro modo la siguiente sesión entendería mal (lo que tu equipo entiende por un 'tenant').
Escribe cada una como una oración que se sostenga por sí misma, sin referencia a la conversación. "Decidimos ejecutar la migración primero" no es portable. "La migración debe ejecutarse antes del llenado de datos porque el llenado lee la nueva columna" sí lo es. La prueba es si la oración sigue teniendo sentido para alguien que nunca vio la sesión, que es la misma prueba que separa un registro indexado de lo que sucedió de la memoria útil.
Paso 3: Reanudar por ID en la máquina original, comenzar de cero en la nueva
En la máquina que ejecutó la sesión, reanuda por ID desde cualquier directorio. La búsqueda busca primero en el proyecto actual y sus árboles de trabajo (worktrees), luego en todos los demás proyectos de la máquina, por lo que una sesión que comenzó en otro lugar o se movió aún se resuelve, siempre que exactamente una transcripción contenga mensajes para ella. Pasa las banderas de inicio de las que dependía la sesión.
En la nueva máquina, no intentes reanudar. Inicia una sesión y dale los hechos del Paso 2. Ese es todo el traspaso, y es más rápido de lo que parece, porque los hechos son cortos por diseño.
Si deseas que el archivo de exportación en sí esté disponible en ambas máquinas, guárdalo donde guardes tus documentos de trabajo. Solo mantenlo fuera de ~/.claude/projects, porque una copia de una transcripción en un segundo directorio de proyecto es exactamente el duplicado que causa el error de no encontrado.
Configurando esto en MemoryLake
El Paso 2 produce un conjunto de hechos de una sola oración que deben ser legibles desde cualquier máquina en la que te sientes a continuación. MemoryLake es un lugar para colocarlos de modo que el traspaso no dependa de un archivo que recordaste sincronizar.
Tú mismo escribes las entradas, con tus propias palabras. No se lee, escribe ni elimina nada de los archivos de transcripción de Claude Code, ~/.claude, ni del almacén de ningún proveedor.
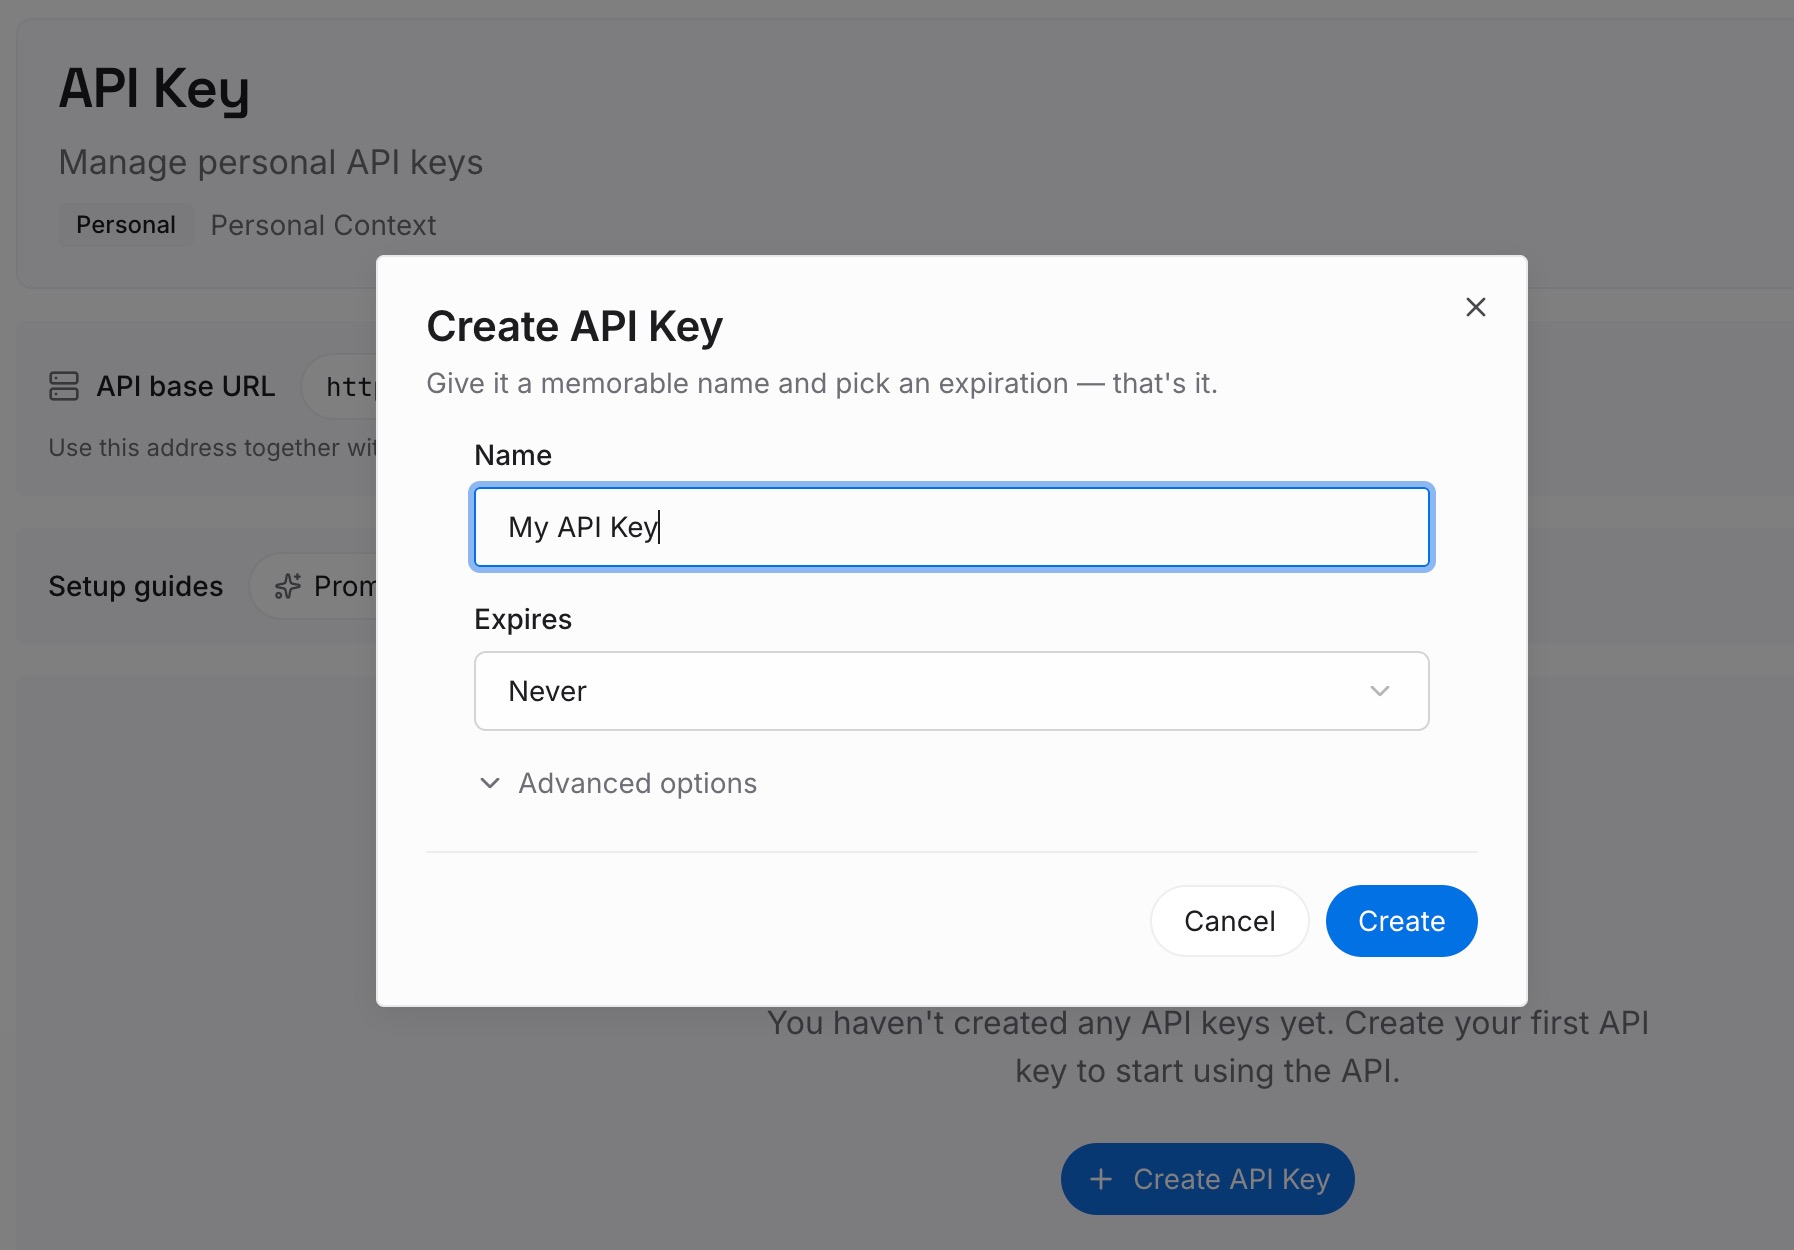
Paso 1: Crear una clave API
Inicia sesión y genera una clave desde el panel de control. La clave es lo que permite a un agente en cualquier máquina leer las entradas, que es la parte que un archivo copiado no te puede dar.
Paso 2: Subir tus primeras memorias
Agrega las decisiones, restricciones y vocabulario del Paso 2 anterior, un hecho por entrada. Mantén la transcripción exportada como el registro de formato largo; las entradas son la parte que debe leerse al inicio de la siguiente sesión.
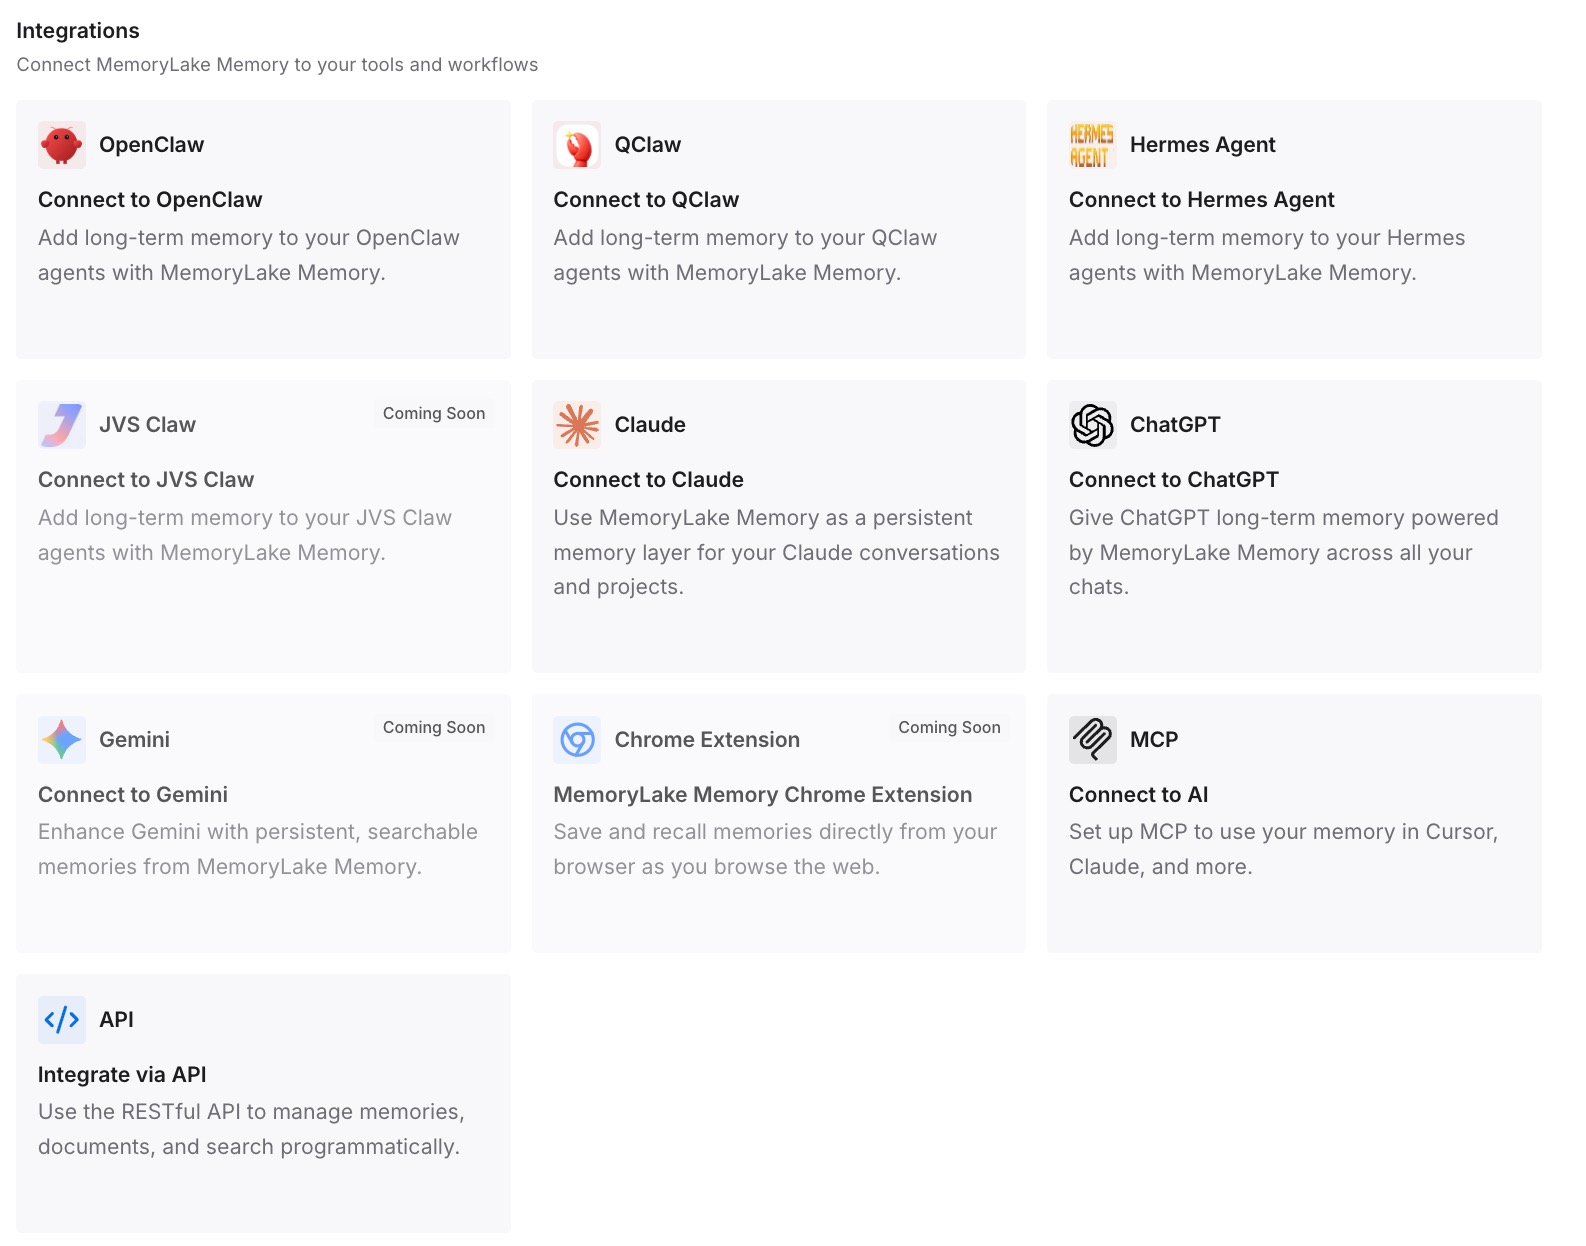
Paso 3: Conectar tu IA y agentes
Apunta los agentes de ambas máquinas al mismo espacio de trabajo. Una nueva sesión comenzará entonces con las decisiones acordadas ya disponibles, en lugar de comenzar desde una conversación que no puede abrir.
Qué cambia esto en la práctica
El primer cambio es que el traspaso deja de ser una operación de archivos. Ya no estás intentando hacer que el estado local de una máquina aparezca en otra máquina, que es un problema que la herramienta se niega deliberadamente a resolver por ti.
El segundo es que los dos artefactos dejan de competir. La exportación es un registro legible de cómo llegaste a algún lugar, útil en la descripción de un pull request, una nota de traspaso o un informe de incidentes. Los hechos son lo que la siguiente sesión necesita cargar. Intentar que un solo artefacto haga ambos trabajos es lo que produce la transcripción gigante que nadie lee y la nueva sesión que no sabe nada.
El tercero es que la rotación de versiones deja de importar. Una exportación renderizada es texto plano para siempre. Una transcripción JSONL es un formato interno que está documentado que cambia entre lanzamientos, por lo que cualquier cosa que hayas construido sobre ella es un compromiso de mantenimiento que no tenías intención de asumir.
También hay una dimensión de privacidad que vale la pena mencionar, ya que cambia lo que deberías exportar. Las escrituras de transcripción se pueden suprimir por completo a través de una variable de entorno, y se puede indicar a una sola ejecución no interactiva que no persista su sesión. Si trabajas en un contexto donde las conversaciones no deben residir en el disco, esos interruptores existen, y eso significa que el paso de exportación se convierte en el único registro, así que hazlo deliberadamente. Este es un artefacto diferente de la exportación de datos a nivel de cuenta que solicitas a Claude, que cubre las aplicaciones de consumo en lugar de las transcripciones locales de la CLI.
Los equipos que trabajan entre un portátil y un ordenador de escritorio tienden a encontrarse con esto más rápido, y la solución es la misma que evita que el contexto se pierda al cambiar de máquina: la parte duradera tiene que vivir en algún lugar que ninguna de las dos máquinas posea.
Buenas prácticas para mover el trabajo entre máquinas
Exportar al final de una sesión de trabajo, no al inicio de la siguiente. La exportación es una operación en vivo contra la conversación actual. Las limpiezas de retención, los diálogos de compactación y el simple olvido se interponen entre tú y la sesión de ayer.
Nunca coloques una copia de la transcripción dentro de un segundo directorio de proyecto. Esta es la acción individual con más probabilidades de hacer que falle la reanudación. Mantén las exportaciones con tus documentos.
Anota las banderas de inicio junto a la exportación. Una sesión reanudada no restaura las banderas de configuración con las que se inició. Una nota de una sola línea que indique qué banderas necesitaba la sesión te ahorra los veinte minutos de averiguar por qué faltan las herramientas.
Trata la retención de treinta días como la fecha límite real. La limpieza predeterminada es de treinta días y es una clave de configuración, no una promesa. Cualquier cosa que desees conservar en seis meses debe ser una exportación o un hecho, no una transcripción.
Nombra tus sesiones. Una sesión con nombre se resuelve por nombre en todo el repositorio y sus árboles de trabajo (worktrees), lo que hace que la reanudación en la máquina original sea trivial y que tus notas sean legibles. Una sesión sin nombre es un ID que no reconocerás.
Separa "lo que decidimos" de "lo que discutimos". Lo primero es corto y pertenece al traspaso. Lo segundo es largo y pertenece a la exportación. Las sesiones que pierden el hilo generalmente lo perdieron porque las decisiones del proyecto nunca se escribieron en ningún lugar fuera de la conversación.
Utiliza una solicitud de resumen en lugar de un analizador. Si deseas una salida estructurada de una sesión antigua, envíale una solicitud de seguimiento por ID y captura la respuesta estructurada. Esa es una interfaz compatible. Analizar el JSONL no lo es.
Conclusión
Claude Code almacena tu conversación en un archivo que puedes ver, lo que hace que copiarlo parezca la forma obvia de mover el trabajo. Es el único enfoque que la herramienta está diseñada para rechazar, y lo rechaza informando que no se encontró en lugar de reanudar una copia que no puede verificar.
La ruta compatible es más pequeña y duradera. Exporta la conversación como un documento legible mientras la sesión está abierta. Extrae el puñado de decisiones, restricciones y términos como oraciones independientes. Reanuda por ID en la máquina que tiene la transcripción y comienza de cero en la máquina que no la tiene, con los hechos ya cargados.
Esa división también resulta ser lo que permite que más de una persona retome el trabajo, que es la misma razón por la que compartir el contexto entre sesiones es un problema de escritura antes de ser un problema de herramientas.